
NoSQL 与搜索 / 系统课时
语义搜索工作流程
语义搜索工作流程
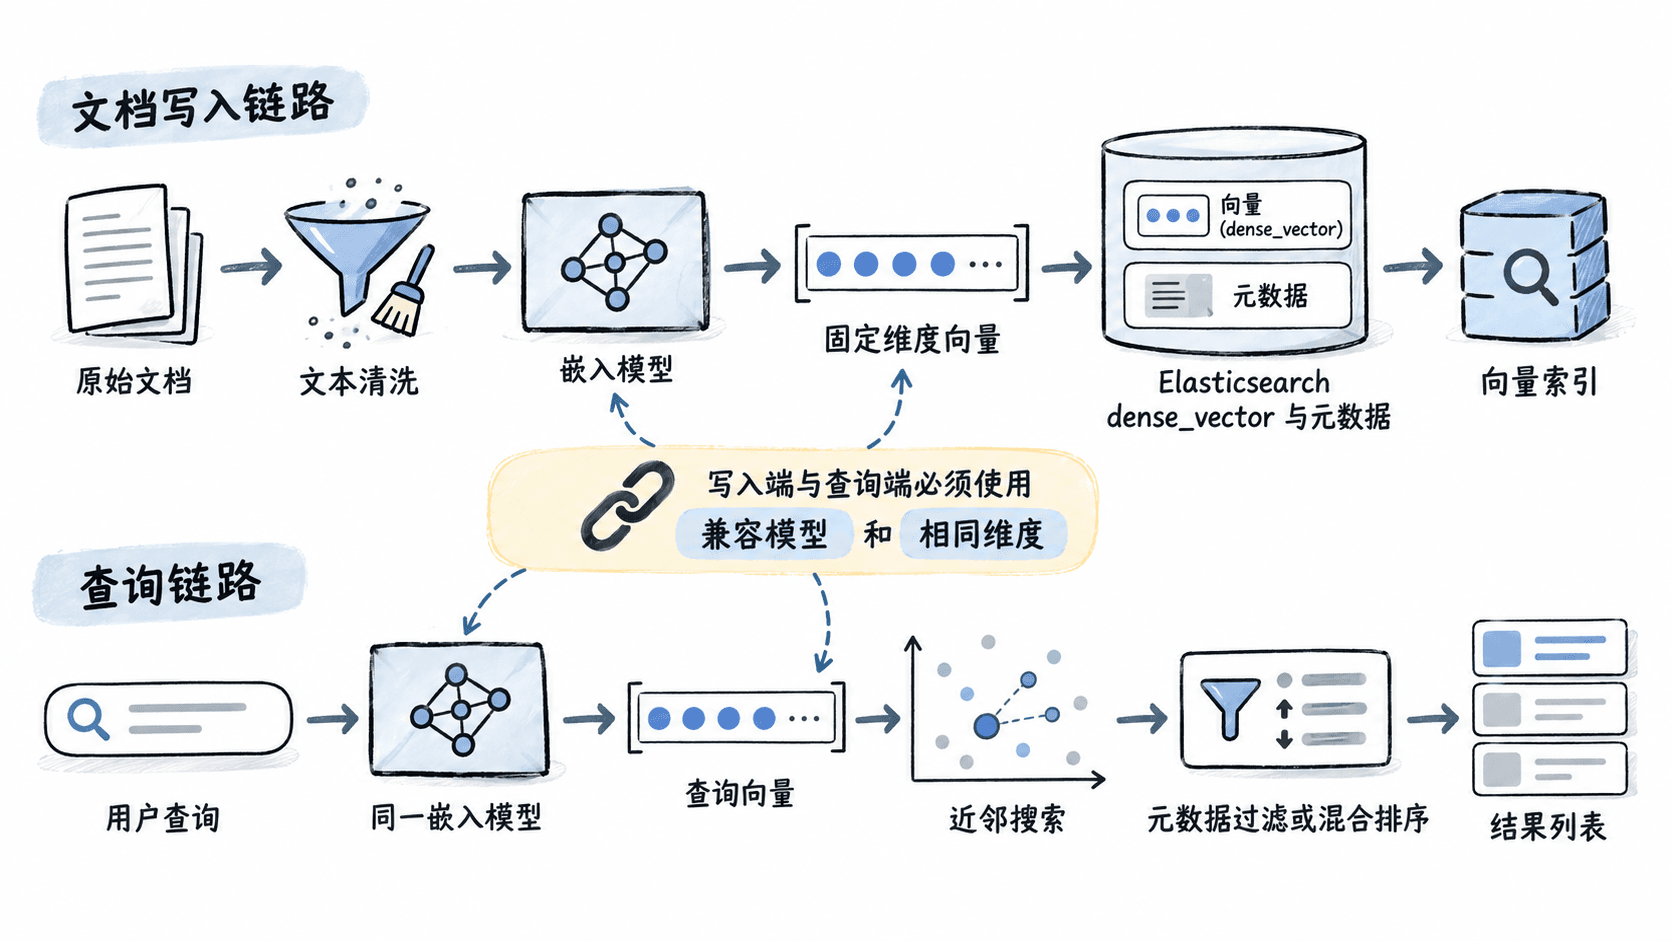
语义搜索解决“关键词不同但含义相近”的召回问题。完整链路不是直接比较原文,而是先把文档与查询转换为同一向量空间中的坐标,再借助向量索引快速找到距离最近的候选结果。
学习目标
- 说明嵌入模型、向量表示、向量索引和近邻搜索各自承担的职责
- 理解文档写入链路与查询链路为何必须使用兼容的模型
- 能用一个最小示例观察相似度排序结果
从文本到结果的四个阶段
第一阶段是嵌入。模型接收标题、正文或用户查询,输出固定维度的数值数组。向量中的单个数字通常没有独立业务含义,真正有意义的是多个维度共同形成的位置关系。
第二阶段是存储。文档向量写入 Elasticsearch 的 dense_vector 字段,同时保留标题、正文、分类和权限等普通字段。向量负责语义召回,普通字段负责展示、过滤和精确约束。
第三阶段是建索引。系统为向量构建近似近邻索引,使查询不必逐条扫描全部文档。索引通常用少量精度损失换取更低延迟,因此候选数量会影响召回率和查询成本。
第四阶段是检索。查询文本使用同一套模型生成查询向量,近邻搜索返回最相似的候选文档,随后还可以叠加关键词评分、业务权重或重排模型。
用最小程序观察近邻排序
下面的程序用二维向量模拟查询与三个文档,并按余弦相似度从高到低排序。它没有调用嵌入模型,但完整展示了近邻搜索最后一步的核心逻辑。
import math
from typing import Dict, List, Tuple

Vector = List[float]

def cosine_similarity(left: Vector, right: Vector) -> float:
    if len(left) != len(right):
        raise ValueError("向量维度必须一致")

    dot = sum(a * b for a, b in zip(left, right))
    left_norm = math.sqrt(sum(value * value for value in left))
    right_norm = math.sqrt(sum(value * value for value in right))
    if left_norm == 0 or right_norm == 0:
        raise ValueError("向量不能是零向量")
    return dot / (left_norm * right_norm)

def main() -> None:
    query = [1.0, 0.8]
    documents: Dict[str, Vector] = {
        "文档A": [1.0, 0.9],
        "文档B": [0.8, 1.0],
        "文档C": [-1.0, 0.0],
    }

    # 生产环境由向量索引完成候选检索,这里直接计算便于观察结果。
    ranked: List[Tuple[str, float]] = sorted(
        ((name, cosine_similarity(query, vector)) for name, vector in documents.items()),
        key=lambda item: item[1],
        reverse=True,
    )

    for name, score in ranked:
        print(f"{name}: {score:.3f}")

if __name__ == "__main__":
    main()
预期输出
文档A: 0.998
文档B: 0.976
文档C: -0.781
文档 A 与查询方向最接近,因此排在首位。真实系统中的向量通常有数百到数千个维度,排序仍遵循相同思想,只是由专门的近邻索引减少计算量。
落地时必须守住的边界
写入端和查询端应使用同一模型版本、相同文本处理规则与相同维度。只要其中一项变化,旧向量与新查询向量就可能失去可比性,通常需要建立新字段或新索引并重新生成文档向量。
近邻搜索只负责找“语义上接近”的候选,不等于最终业务排序。权限、租户、时间范围和状态等硬条件应通过过滤字段约束;关键词命中、热度和新鲜度则可以在混合检索或重排阶段补充。
Tips:先用小规模人工标注查询集验证召回质量,再调整候选数量和索引参数。只观察单次查询耗时,无法判断语义搜索是否真正有效。
本课总结
- 嵌入模型把文本映射到统一向量空间,向量索引负责快速寻找近邻候选
- 文档与查询必须保持模型、维度和预处理规则兼容
- 向量召回通常还要结合过滤、关键词评分或重排才能形成最终结果
下一课预告
下一课将进入 dense_vector 字段建模,配置维度、相似度和向量索引参数,并通过映射接口验证配置是否生效。