
NoSQL 与搜索 / 系统课时
数据同步与索引发布
数据同步与索引发布
本课把商品数据从业务库安全发布到 Elasticsearch:先建立新索引并完成全量导入,再接入增量同步,最后通过校验、别名切换和回滚把变更稳定上线。
学习目标
- 设计“物理索引 + 稳定别名”的零停机发布模型
- 完成全量导入、增量写入与发布前校验
- 掌握别名原子切换和异常回滚方法
建立可回滚的发布模型
线上查询不要直接依赖带版本号的物理索引,而应始终访问固定别名,例如 products_read。每次发布创建一个新索引 products_v<INDEX_VERSION>,导入并验证完成后,再用一次别名操作把读流量切到新版本。
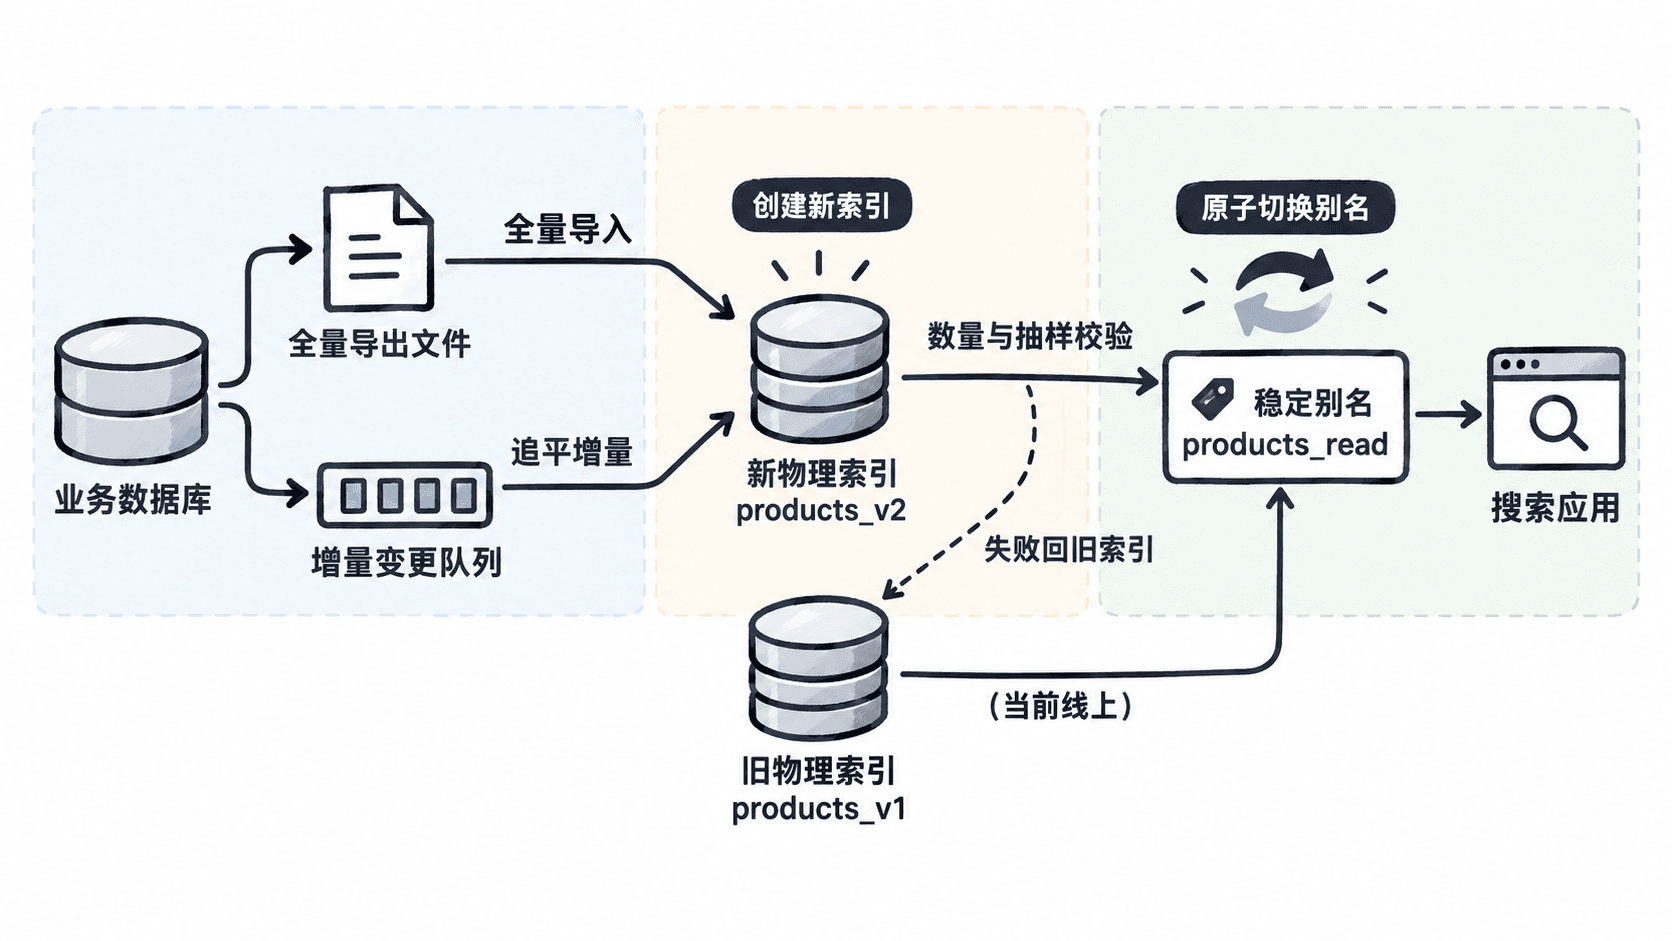
这种模型把“数据准备”和“线上生效”分开。新索引在校验通过前不会承接查询;切换后旧索引暂时保留,因此出现映射错误、文档缺失或相关性退化时,可以快速切回。
执行全量导入
下面的脚本创建一个带映射的新索引,写入三条示例商品,刷新后核对文档数,并在首次发布时绑定别名。运行前确保本机已安装 curl,并把 ES_URL 改为实际地址。
#!/usr/bin/env bash
set -euo pipefail

# 版本化物理索引用于构建,稳定别名供应用查询
ES_URL="${ES_URL:-http://localhost:9200}"
NEW_INDEX="products_v20260803"
READ_ALIAS="products_read"

curl -sS -w '\n' -X PUT "${ES_URL}/${NEW_INDEX}"   -H 'Content-Type: application/json'   -d '{
    "mappings": {
      "properties": {
        "name": {"type": "text"},
        "category": {"type": "keyword"},
        "price": {"type": "double"},
        "updatedAt": {"type": "date"}
      }
    }
  }'

# Bulk 文件必须严格保持“一行动作、一行文档”的 NDJSON 结构
cat > /tmp/products.ndjson <<'EOF'
{"index":{"_index":"products_v20260803","_id":"1001"}}
{"name":"机械键盘","category":"keyboard","price":399.0,"updatedAt":"2026-08-03T01:00:00Z"}
{"index":{"_index":"products_v20260803","_id":"1002"}}
{"name":"无线鼠标","category":"mouse","price":159.0,"updatedAt":"2026-08-03T01:01:00Z"}
{"index":{"_index":"products_v20260803","_id":"1003"}}
{"name":"显示器支架","category":"accessory","price":219.0,"updatedAt":"2026-08-03T01:02:00Z"}
EOF

# refresh=true 只用于本课立即验证,超大批量导入应统一控制刷新
curl -sS -w '\n' -X POST "${ES_URL}/_bulk?refresh=true"   -H 'Content-Type: application/x-ndjson'   --data-binary @/tmp/products.ndjson

# 先确认导入数量,再让稳定别名指向新索引
curl -sS -w '\n' "${ES_URL}/${NEW_INDEX}/_count"

curl -sS -w '\n' -X POST "${ES_URL}/_aliases"   -H 'Content-Type: application/json'   -d "{
    \"actions\": [
      {\"add\": {\"index\": \"${NEW_INDEX}\", \"alias\": \"${READ_ALIAS}\"}}
    ]
  }"
预期输出
{"acknowledged":true,"shards_acknowledged":true,"index":"products_v20260803"}
{"errors":false,"took":<TIME>,"items":[<BULK_ITEMS>]}
{"count":3,"_shards":{"total":<COUNT>,"successful":<COUNT>,"skipped":0,"failed":0}}
{"acknowledged":true}<TIME>、<COUNT> 和 <BULK_ITEMS> 会随环境变化。若返回 errors:true,必须停止发布并检查失败项。生产导入时应把示例 NDJSON 替换为业务库导出的完整数据,并保留稳定的商品主键作为 _id,这样重复导入会覆盖同一文档,而不会产生副本。
接入增量同步
全量导入期间,业务库仍可能发生新增、修改和删除。常见做法是从数据库变更日志或消息队列消费事件,并以商品主键执行幂等写入:新增和修改使用 index 或 update,删除使用 delete。
下面是一次批量增量写入的片段示例,依赖已存在的 products_v20260803 索引。
{"index":{"_index":"products_v20260803","_id":"1002"}}
{"name":"无线鼠标 Pro","category":"mouse","price":199.0,"updatedAt":"2026-08-03T02:00:00Z"}
{"delete":{"_index":"products_v20260803","_id":"1003"}}
预期结果:批量接口返回 errors:false,商品 1002 被覆盖为新内容,商品 1003 被删除。切换别名前,应先记录全量开始时的变更位点,再持续消费到当前位点,避免发布窗口内漏数据。
校验后原子切换
发布前至少检查四类结果:文档总数是否在允许误差内、关键字段是否缺失、抽样商品是否一致、核心搜索用例是否通过。只有这些检查全部成功,才执行别名切换。
#!/usr/bin/env bash
set -euo pipefail

ES_URL="${ES_URL:-http://localhost:9200}"
OLD_INDEX="products_v20260720"
NEW_INDEX="products_v20260803"
READ_ALIAS="products_read"

# 移除旧索引与绑定新索引必须放在同一个别名请求中
curl -sS -w '\n' -X POST "${ES_URL}/_aliases"   -H 'Content-Type: application/json'   -d "{
    \"actions\": [
      {\"remove\": {\"index\": \"${OLD_INDEX}\", \"alias\": \"${READ_ALIAS}\"}},
      {\"add\": {\"index\": \"${NEW_INDEX}\", \"alias\": \"${READ_ALIAS}\"}}
    ]
  }"

# 再读取别名,确认线上查询已经指向目标版本
curl -sS -w '\n' "${ES_URL}/_alias/${READ_ALIAS}"
预期输出
{"acknowledged":true}
{"products_v20260803":{"aliases":{"products_read":{}}}}
同一个 _aliases 请求中的移除和新增会作为一次操作提交,应用不会经历“别名暂时不存在”的中间状态。切换后应立即观察错误率、查询延迟、零结果率和关键商品命中情况。
异常回滚与旧索引清理
发现异常时,使用同样的别名接口把 products_read 从新索引切回旧索引。回滚前不要删除旧索引,也不要在旧索引上继续执行不可逆的数据修复。
# 回滚只切换别名,不修改新旧索引中的文档
curl -sS -w '\n' -X POST "${ES_URL:-http://localhost:9200}/_aliases"   -H 'Content-Type: application/json'   -d '{
    "actions": [
      {"remove":{"index":"products_v20260803","alias":"products_read"}},
      {"add":{"index":"products_v20260720","alias":"products_read"}}
    ]
  }'
预期输出
{"acknowledged":true}旧索引建议保留一个明确的观察窗口,例如一个发布周期。确认新索引稳定、快照可用且无需回滚后,再按保留策略删除旧版本,避免磁盘长期被历史索引占满。
本课总结
- 新建物理索引、离线校验、别名切换可以把索引构建与线上查询解耦
- 增量同步必须从全量起点持续追平,并使用稳定主键保证幂等
- 旧索引应保留到观察期结束,异常时通过别名原子切回
下一课预告
下一课将对搜索系统执行读写压测和相关性测试,定位性能瓶颈,并演练节点故障与索引恢复流程。