
NoSQL 与搜索 / 系统课时
深度分页
深度分页
当结果集超过普通页码分页的合理范围时,本课用稳定排序与 search_after 实现向后翻页。你将完成两页可验证的查询,并理解为什么后续请求必须复用同一查询条件和上一页最后一条命中的排序值。
学习目标
- 说明大偏移量
from + size的资源消耗来源 - 使用唯一、稳定的排序字段构造
search_after请求 - 识别数据变动、随机跳页和排序值重复等边界
为什么大偏移量分页会变慢
普通分页使用 from 跳过前面的结果,再用 size 取当前页。搜索跨越多个分片时,每个分片都可能先收集并排序 from + size 条候选结果,协调节点再进行归并。页码越深,需要保留和比较的候选结果越多,CPU、堆内存与网络传输都会增加。
search_after 不再表达“跳过多少条”,而是表达“从哪个排序位置之后继续”。它适合上一页、下一页式浏览,但不能直接跳到任意页码。
稳定排序是正确翻页的前提
排序字段必须在每一页保持相同,并能确定唯一顺序。只按时间排序时,多条文档可能拥有相同时间,因此应再增加一个唯一的 keyword 或数值字段作为决胜字段。后续请求需要把上一页最后一条命中的完整 sort 数组原样传给 search_after,字段顺序和数据类型都不能改变。
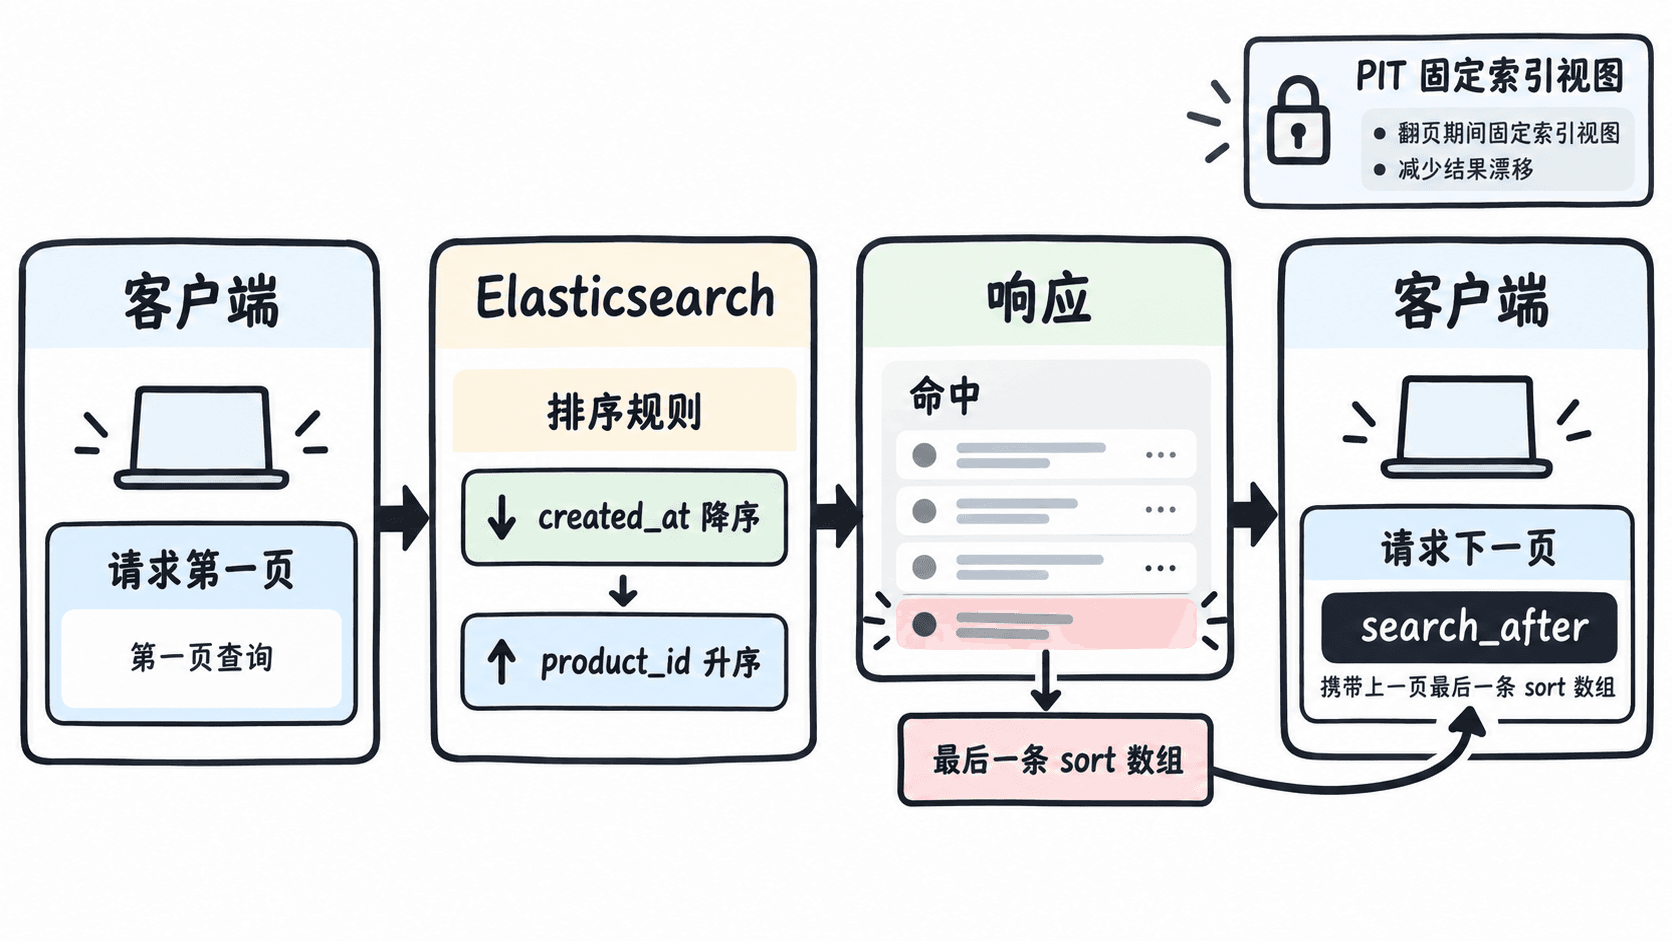
图中的核心不是保存页码,而是保存上一页末尾的排序游标。查询条件、排序规则或索引视图一旦变化,这个游标就不再代表原来的位置。
完成两页查询
下面的请求可直接在 Kibana Console 执行。示例先创建索引和五条文档,再按 created_at 降序、product_id 升序获取两页结果,每页两条。
PUT /products_deep_page
{
  "mappings": {
    "properties": {
      "product_id": { "type": "keyword" },
      "name": { "type": "text" },
      "created_at": { "type": "date" }
    }
  }
}

POST /products_deep_page/_bulk?refresh=true
{"index":{"_id":"P001"}}
{"product_id":"P001","name":"机械键盘","created_at":"2026-08-01T08:00:00Z"}
{"index":{"_id":"P002"}}
{"product_id":"P002","name":"无线鼠标","created_at":"2026-08-02T08:00:00Z"}
{"index":{"_id":"P003"}}
{"product_id":"P003","name":"显示器支架","created_at":"2026-08-02T09:00:00Z"}
{"index":{"_id":"P004"}}
{"product_id":"P004","name":"扩展坞","created_at":"2026-08-03T08:00:00Z"}
{"index":{"_id":"P005"}}
{"product_id":"P005","name":"降噪耳机","created_at":"2026-08-03T09:00:00Z"}

GET /products_deep_page/_search
{
  "size": 2,
  "query": {
    "match_all": {}
  },
  "sort": [
    {
      "created_at": {
        "order": "desc",
        "format": "strict_date_optional_time"
      }
    },
    {
      "product_id": {
        "order": "asc"
      }
    }
  ]
}

GET /products_deep_page/_search
{
  "size": 2,
  "query": {
    "match_all": {}
  },
  "search_after": [
    "2026-08-03T08:00:00.000Z",
    "P004"
  ],
  "sort": [
    {
      "created_at": {
        "order": "desc",
        "format": "strict_date_optional_time"
      }
    },
    {
      "product_id": {
        "order": "asc"
      }
    }
  ]
}
预期结果如下。实际响应还会包含 _index、_score 等字段,这里只保留验证翻页所需的信息。
创建索引:acknowledged = true
批量写入:errors = false

第一页:
P005  sort = ["2026-08-03T09:00:00.000Z", "P005"]
P004  sort = ["2026-08-03T08:00:00.000Z", "P004"]

第二页:
P003  sort = ["2026-08-02T09:00:00.000Z", "P003"]
P002  sort = ["2026-08-02T08:00:00.000Z", "P002"]
真实代码不要手工重新计算 search_after。应从响应中读取最后一个 hit.sort,整体保存并传入下一次请求,这样可避免日期格式、数值类型或决胜字段不一致。
一致性与使用边界
如果分页期间索引仍在写入或更新,同一排序位置附近的文档可能发生移动。面向持续变化的数据,应在第一页前创建 Point in Time,并在后续请求中复用 PIT 标识与相同排序规则,使多次搜索基于一致的索引视图。
search_after 适合顺序向后浏览,不适合“直接跳到第 500 页”。需要导出或离线处理大量文档时,应选择面向批处理的方案,而不是把交互式分页无限向后延伸。前端还应限制最大浏览深度,并在筛选条件变化时清空旧游标。
常见错误:只按非唯一时间字段排序、第二页改变查询条件、只传部分
sort值,都会导致重复、遗漏或请求失败。
本课总结
search_after用上一页末尾的排序值继续搜索,避免大偏移量分页不断扩大候选集合- 排序必须稳定且唯一,后续请求要原样复用查询、排序和完整
sort数组 - 数据持续变化时应配合 PIT 固定索引视图,随机跳页则需要重新设计交互方式
下一课预告
下一课将学习结果折叠与去重,用一个代表文档展示同组内容,并按需展开组内结果。