
NoSQL 与搜索 / 系统课时
业务权重调节
业务权重调节
商品搜索不能只依赖文本相关性:名称很匹配但已售罄、长期无人购买或发布时间过旧的商品,通常不应排在最前。本课使用 function_score 保留全文检索能力,再把销量、库存和发布时间转换为可控的业务加分。
学习目标
- 理解文本评分与业务评分的组合方式
- 使用
function_score同时接入销量、库存和时间衰减 - 通过上限、缺失值和对照查询避免权重失控
为什么需要业务评分
match、multi_match 等全文查询主要回答“文档与关键词有多相关”。真实排序还需要回答“这个结果是否值得优先展示”,例如库存是否可售、近 30 天销量是否较高、内容是否仍然新鲜。
业务指标不能直接替代文本相关性。否则销量很高但名称完全不匹配的商品也可能进入前排。更稳妥的思路是先由全文查询筛出相关候选,再让业务信号在候选范围内调整顺序。
组合规则的核心
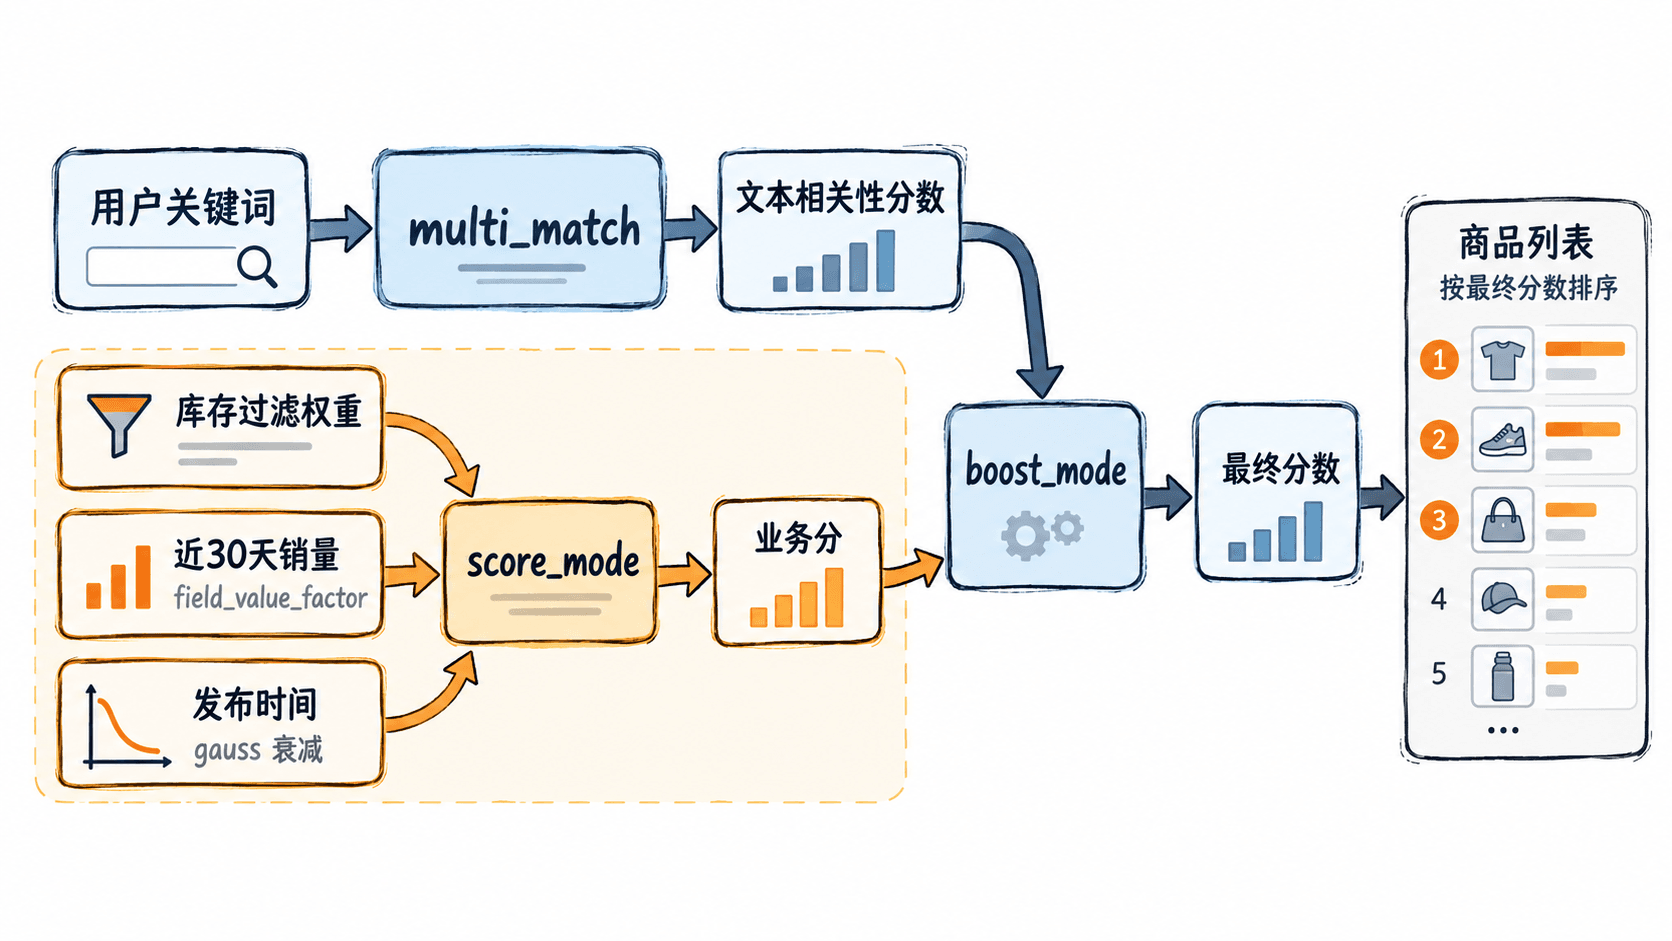
function_score 内部先执行 query,得到原始 _score;随后执行 functions 中的业务函数。score_mode 决定多个业务函数如何合并,boost_mode 决定业务分与原始 _score 如何结合。
例如,score_mode: sum 会把库存、销量和时间衰减的结果相加;boost_mode: multiply 再把合并后的业务分乘到文本分上。这样,文本不相关的文档仍然难以靠业务指标“硬冲”到前排。
主示例:销量、库存和新鲜度
下面的查询假设索引 products 中存在 name、description、in_stock、sales_30d 和 published_at 字段。销量字段应为数值类型,发布时间应为 date 类型。
POST products/_search
{
  "size": 10,
  "query": {
    "function_score": {
      "query": {
        "multi_match": {
          "query": "无线耳机",
          "fields": ["name^3", "description"]
        }
      },
      "functions": [
        {
          "filter": {
            "term": {
              "in_stock": true
            }
          },
          "weight": 1.2
        },
        {
          "field_value_factor": {
            "field": "sales_30d",
            "factor": 0.02,
            "modifier": "log1p",
            "missing": 0
          }
        },
        {
          "gauss": {
            "published_at": {
              "origin": "now",
              "scale": "30d",
              "offset": "7d",
              "decay": 0.5
            }
          }
        }
      ],
      "score_mode": "sum",
      "boost_mode": "multiply",
      "max_boost": 5,
      "min_score": 0.1
    }
  }
}
预期结果
HTTP/1.1 200 OK
响应体中的 hits.hits 按最终 _score 降序排列。
同等文本相关性下,有库存、近 30 天销量较高且发布时间较新的商品通常更靠前。
具体 _score 会随索引内容、当前时间和字段值变化。
log1p 会把销量的增长压缩为对数曲线,避免销量从 1000 增长到 10000 时产生十倍线性加分。gauss 则让发布时间越远离 now,贡献越低;offset: 7d 表示最近 7 天内不开始明显衰减。
参数边界与调权顺序
先选择业务信号,再决定组合方式,最后调整数值大小。不要一开始同时修改所有参数,否则很难判断是哪一个信号改变了排序。
| 参数 | 作用 | 常用选择 |
|---|---|---|
score_mode |
合并多个业务函数 | sum 易解释,multiply 会放大差异 |
boost_mode |
合并文本分与业务分 | multiply 保留文本相关性的主导地位 |
max_boost |
限制业务分上限 | 防止极端字段值支配结果 |
missing |
处理业务字段缺失 | 明确给出中性值或零值,避免查询失败 |
库存如果是硬性条件,应放到查询的 filter 中直接排除无库存商品;只有“有库存优先,但无库存仍可展示”时,才适合使用过滤函数加权。销量等字段还应避免负数,并在写入阶段完成清洗。
如何验证调权是否有效
准备一组固定关键词和人工标注样本,先保存不加业务权重的基线结果,再逐个启用库存、销量和时间衰减。每次只改变一个参数,记录前 10 名变化以及不相关结果是否上升。
调权完成后还要检查极端数据:销量为零、字段缺失、发布时间很久以前以及异常大值。只看正常商品容易得到“看起来有效”的结论,却把边界问题留到线上。
本课总结
function_score适合在文本相关候选中加入可解释的业务信号score_mode管理业务函数之间的关系,boost_mode管理业务分与文本分的关系- 对数压缩、衰减函数、缺失值和分数上限是防止排序失控的关键
下一课预告
下一课将使用 explain 拆解单个文档的评分来源,并通过 profile 查看查询各阶段的执行耗时。