
NoSQL 与搜索 / 系统课时
边输入边搜索
边输入边搜索
本课将建立一个可直接查询的即时搜索索引,让用户输入到一半时就返回文档结果,并用同一组标准比较 search_as_you_type 与自定义 edge_ngram 方案。
学习目标
- 使用
search_as_you_type和bool_prefix完成即时搜索。 - 理解自动生成的子字段如何支持词组与前缀匹配。
- 根据语言、排序和索引成本选择实现方案。
即时搜索与自动补全的区别
即时搜索返回的是匹配文档,通常需要相关性评分、高亮、过滤和分页;自动补全返回的是候选词,重点是极低延迟和固定导航入口。二者可以共存:输入框上方展示补全词,结果区域同时执行即时搜索。
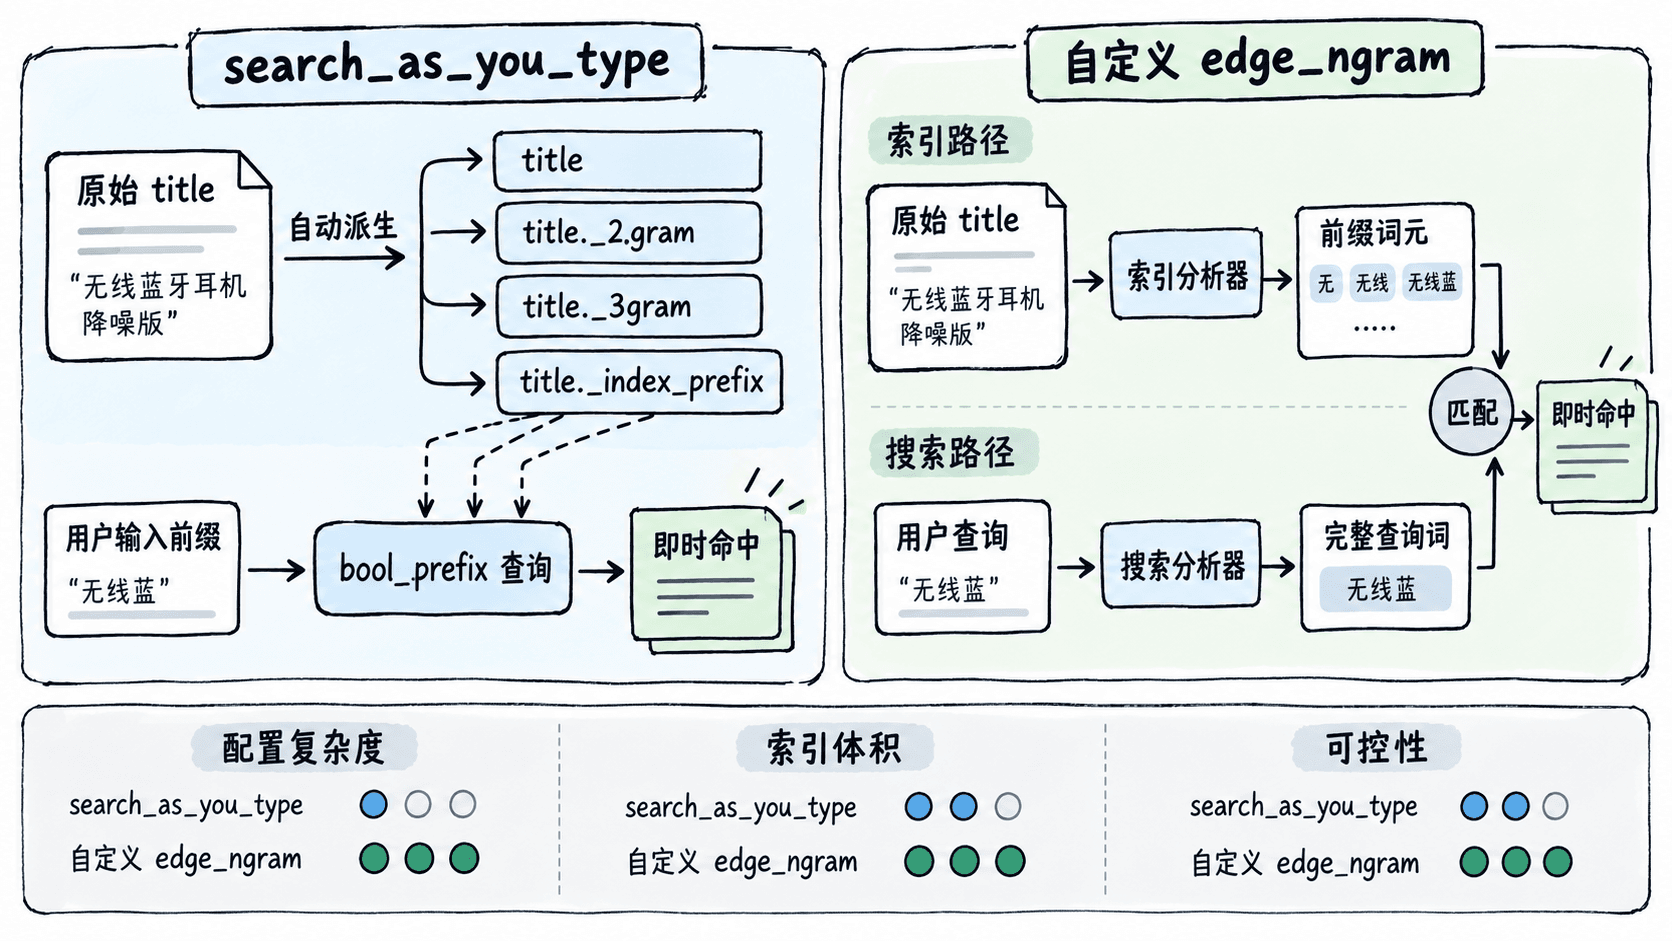
search_as_you_type 会为根字段创建 shingle 子字段和 _index_prefix 前缀子字段。官方推荐使用 multi_match 的 bool_prefix 类型同时查询根字段、_2gram 和 _3gram,从而兼顾任意词序召回与连续词组加分。:contentReference[oaicite:4]{index=4}
使用 search_as_you_type
下面创建商品索引、写入两条文档,再以未输完的 wireless e 查询。示例使用英文是为了让默认分析器的分词结果稳定可见;中文项目应结合实际分词器验证词元。
curl -X PUT "http://localhost:9200/products-instant?filter_path=acknowledged,shards_acknowledged,index" \
  -H "Content-Type: application/json" \
  -d '{
    "mappings": {
      "properties": {
        "title": {
          "type": "search_as_you_type",
          "max_shingle_size": 3
        },
        "category": { "type": "keyword" }
      }
    }
  }'

curl -X POST "http://localhost:9200/products-instant/_bulk?refresh=true&filter_path=errors,items.index._id,items.index.status" \
  -H "Content-Type: application/x-ndjson" \
  --data-binary $'{"index":{"_id":"1"}}\n{"title":"wireless earbuds with charging case","category":"audio"}\n{"index":{"_id":"2"}}\n{"title":"wireless charger stand","category":"accessory"}\n'

curl -X POST "http://localhost:9200/products-instant/_search?filter_path=hits.hits._id,hits.hits._source.title" \
  -H "Content-Type: application/json" \
  -d '{
    "query": {
      "multi_match": {
        "query": "wireless e",
        "type": "bool_prefix",
        "fields": [
          "title",
          "title._2gram",
          "title._3gram"
        ]
      }
    }
  }'
预期结果依次表示索引创建成功、两条批量写入均成功,以及仅第一条文档命中。最后一个未完成词 e 能匹配 earbuds 的前缀。
{"acknowledged":true,"shards_acknowledged":true,"index":"products-instant"}
{"errors":false,"items":[{"index":{"_id":"1","status":201}},{"index":{"_id":"2","status":201}}]}
{"hits":{"hits":[{"_id":"1","_source":{"title":"wireless earbuds with charging case"}}]}}
bool_prefix 会把查询的最后一个词按前缀处理,前面的完整词按普通词项处理。把三个字段一起查询,可以让连续词组在 shingle 字段获得更高相关性,同时保留较宽松的多词召回。:contentReference[oaicite:5]{index=5}
自定义 edge_ngram 方案
当项目需要自行决定最短前缀、最长前缀、字符类型或分析器组合时,可以使用 edge_ngram。关键原则是只在索引阶段切前缀,搜索阶段使用普通分析器;否则用户查询也被切成大量前缀,容易扩大召回并增加计算量。:contentReference[oaicite:6]{index=6}
curl -X PUT "http://localhost:9200/products-edge?filter_path=acknowledged,shards_acknowledged,index" \
  -H "Content-Type: application/json" \
  -d '{
    "settings": {
      "analysis": {
        "tokenizer": {
          "title_edge_tokenizer": {
            "type": "edge_ngram",
            "min_gram": 2,
            "max_gram": 15,
            "token_chars": ["letter", "digit"]
          }
        },
        "analyzer": {
          "title_edge_index": {
            "type": "custom",
            "tokenizer": "title_edge_tokenizer",
            "filter": ["lowercase"]
          }
        }
      }
    },
    "mappings": {
      "properties": {
        "title": {
          "type": "text",
          "analyzer": "title_edge_index",
          "search_analyzer": "standard"
        }
      }
    }
  }'

curl -X POST "http://localhost:9200/products-edge/_analyze?filter_path=tokens.token" \
  -H "Content-Type: application/json" \
  -d '{
    "analyzer": "title_edge_index",
    "text": "Earbuds"
  }'
预期结果先确认索引创建成功,再返回从词首逐步增长的词元。由于 min_gram 为 2,单个字母 e 不会被索引;由于 max_gram 为 15,本例完整单词仍可保留。
{"acknowledged":true,"shards_acknowledged":true,"index":"products-edge"}
{"tokens":[{"token":"ea"},{"token":"ear"},{"token":"earb"},{"token":"earbu"},{"token":"earbud"},{"token":"earbuds"}]}
max_gram 过小会导致更长查询词无法匹配已生成的前缀词元,过大则明显增加词项数量和索引体积。应根据真实输入长度分布设定范围,而不是直接使用很大的上限。:contentReference[oaicite:7]{index=7}
方案成本对比
| 维度 | search_as_you_type |
自定义 edge_ngram |
|---|---|---|
| 配置成本 | 低,自动创建前缀与 shingle 子字段 | 高,需要设计 tokenizer、index analyzer 和 search analyzer |
| 相关性 | 适合多词即时搜索,连续词组可获得额外分数 | 完全由字段、查询和权重配置决定 |
| 可控性 | 参数较少,行为一致 | 可精确控制前缀长度、字符类型和多字段策略 |
| 索引成本 | 生成多个派生字段 | 生成大量前缀词元,范围越大体积越高 |
| 适用场景 | 常规标题、名称和短文本搜索 | 特殊语言、字段差异大或需要精细分析链路 |
默认优先选择 search_as_you_type,因为实现和维护成本较低。只有在默认分析行为不能满足中文分词、特殊字符、字段级权重或前缀长度要求时,再采用 edge_ngram,并通过 _analyze 与真实查询集验证。
上线前的性能边界
前端应增加防抖,并在输入长度达到最小阈值后再查询;后端应限制 size、只返回必要字段,并设置超时。即时搜索每次返回文档,通常比候选词补全更重,不应在每个按键事件中无限制执行聚合、高亮和复杂脚本。
验收时分别测试短前缀、完整词、多词顺序变化、无结果、中文与特殊字符。还要比较索引前后体积、P95 延迟和召回质量,避免只看“能够命中”就上线。
本课总结
search_as_you_type配合multi_match的bool_prefix是低配置成本的即时搜索方案。edge_ngram提供更高可控性,但会增加映射设计、词项数量和验证成本。- 方案选择应同时评估语言分析、相关性、索引体积和每次按键触发的查询压力。
下一课预告
下一课将继续优化搜索体验,把即时搜索结果与高亮、拼写容错和业务排序组合成完整的输入框交互链路。