
NoSQL 与搜索 / 系统课时
近实时搜索机制
近实时搜索机制
本课解释文档写入后为何不会在同一瞬间出现在搜索结果中,并串联缓冲区、刷新、Lucene 段、提交点与事务日志,形成完整的近实时搜索心智模型。
学习目标
- 描述文档从写入到可搜索的主要路径
- 区分 refresh、flush 与提交点的职责
- 使用一次请求验证文档何时对搜索可见
为什么称为近实时
Elasticsearch 接收写入后,会先完成主分片上的处理并记录事务日志,但搜索请求只能读取已经打开的 Lucene 段。新文档在进入可搜索段之前存在一个很短的可见性延迟,因此系统称为“近实时”,而不是严格实时。
索引通常按刷新间隔自动执行 refresh,常见默认值约为 1 秒,但实际行为会受到索引设置和活跃状态影响。应用不应假定写入响应返回后,普通搜索一定立即命中新文档。
从写入到可搜索
写入请求到达主分片后,文档会进入内存索引缓冲区,同时追加到事务日志。refresh 发生时,缓冲区中的内容被写成新的不可变 Lucene 段,并打开供搜索器读取;从这一刻开始,新文档才能被普通搜索命中。
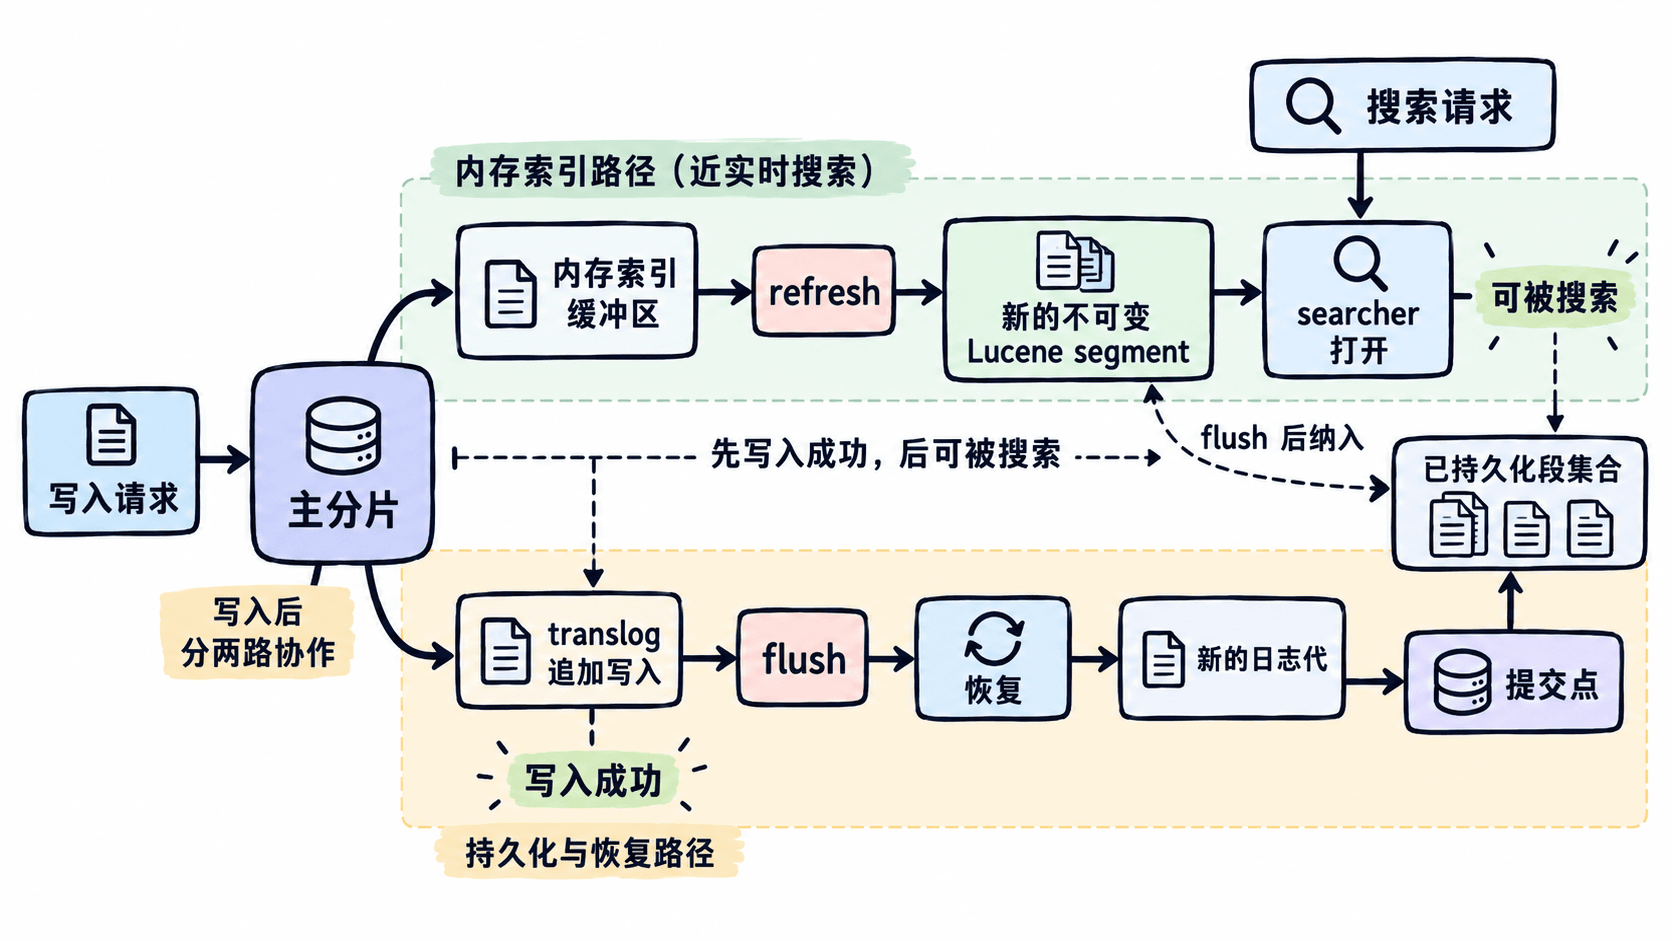
Lucene 段生成后通常先由操作系统文件缓存提供读取能力,并不意味着已经完成一次持久化提交。段是不可变的,后续更新本质上会写入新版本并标记旧版本删除,后台再通过段合并回收空间。
Refresh、Flush 与提交点
| 机制 | 主要作用 | 是否让新文档可搜索 |
|---|---|---|
| refresh | 生成并打开新的 Lucene 段 | 是 |
| flush | 执行 Lucene 提交并开启新的事务日志代 | 通常不是其主要目的 |
| 提交点 | 记录一组可恢复的已提交段 | 不直接决定即时可见性 |
refresh 关注搜索可见性,flush 关注恢复边界和事务日志管理。把两者混为一谈,会误以为每次搜索可见都伴随一次昂贵的磁盘提交;实际上,近实时能力正是通过较轻量的刷新与较低频的提交分离实现的。
用请求验证可见性
下面假设本地教学环境已经允许通过 http://localhost:9200 访问 Elasticsearch。首次执行时,refresh=wait_for 会让写入请求等待相关刷新完成,再返回结果,因此紧随其后的搜索应能看到文档。
# 首次写入等待刷新完成
curl -s -X PUT "http://localhost:9200/nrt-demo/_doc/1?refresh=wait_for" -H "Content-Type: application/json" -d '{"title":"近实时搜索"}'

# 紧接着执行全文搜索
curl -s "http://localhost:9200/nrt-demo/_search?q=title:%E8%BF%91%E5%AE%9E%E6%97%B6"
预期结果
首次写入返回 HTTP 201,响应中的 result 为 created。
随后搜索返回 HTTP 200,hits.total.value 为 1。
若环境启用了认证或 HTTPS,需要补充实际凭据和协议。重复执行同一文档 ID 时,写入可能返回 HTTP 200 且 result 为 updated,但搜索命中数量仍应为 1。
何时主动控制刷新
批量导入时频繁 refresh 会不断产生小段,增加段合并和 I/O 压力,因此通常让系统按合理间隔刷新。只有在“写入后立刻搜索必须可见”的明确业务场景中,才考虑 refresh=wait_for;不建议普遍使用 refresh=true 强制每次写入立即刷新。
对于“按文档 ID 立即读取”的场景,可以优先使用实时 GET,而不是把搜索可见性当作一致性保证。选择 API 时,应先判断需求是读取已知文档,还是执行真正的检索。
本课总结
- 写入成功与普通搜索可见是两个时间点,refresh 负责连接它们
- Lucene 段不可变,提交点与事务日志主要服务持久化和故障恢复
- 主动刷新应只用于明确的即时可见需求,批量写入应避免高频强制刷新
下一课预告
下一课将继续分析分片与副本如何分布数据、并行执行搜索,以及它们对容量、吞吐量和故障恢复的影响。