
NoSQL 与搜索 / 系统课时
性能优化方法
性能优化方法
Elasticsearch 性能优化不能只调一个参数。本课将先建立可重复的性能基线,再分别优化字段映射、分片布局、批量写入、查询结构和缓存使用,最后用同一组指标验证收益。
学习目标
- 能识别映射、分片、写入和查询路径中的主要性能成本。
- 能完成一组安全、可验证的索引与查询优化。
- 能用延迟、吞吐、拒绝数和缓存命中率判断优化是否有效。
先建立可重复基线
优化前必须固定数据量、查询条件、并发度和预热方式,并记录搜索延迟、写入吞吐、CPU、堆内存、磁盘 I/O 与线程池拒绝数。没有基线,就无法判断参数调整究竟带来了收益还是波动。
curl -s "http://<HOST>:9200/_nodes/stats/indices,os,jvm,thread_pool?filter_path=nodes.*.os.cpu.percent,nodes.*.jvm.mem.heap_used_percent,nodes.*.thread_pool.search.rejected,nodes.*.thread_pool.write.rejected,nodes.*.indices.search.query_total,nodes.*.indices.search.query_time_in_millis"预期结果:HTTP 200,响应体如下。
{"nodes":{"<NODE_ID>":{"indices":{"search":{"query_total":1200,"query_time_in_millis":3600}},"os":{"cpu":{"percent":42}},"jvm":{"mem":{"heap_used_percent":58}},"thread_pool":{"search":{"rejected":0},"write":{"rejected":0}}}}}<HOST> 和 <NODE_ID> 使用实际值。可用 query_time_in_millis / query_total 估算累计平均查询耗时,但验收时还应结合客户端的 P95、P99 延迟,避免平均值掩盖长尾。
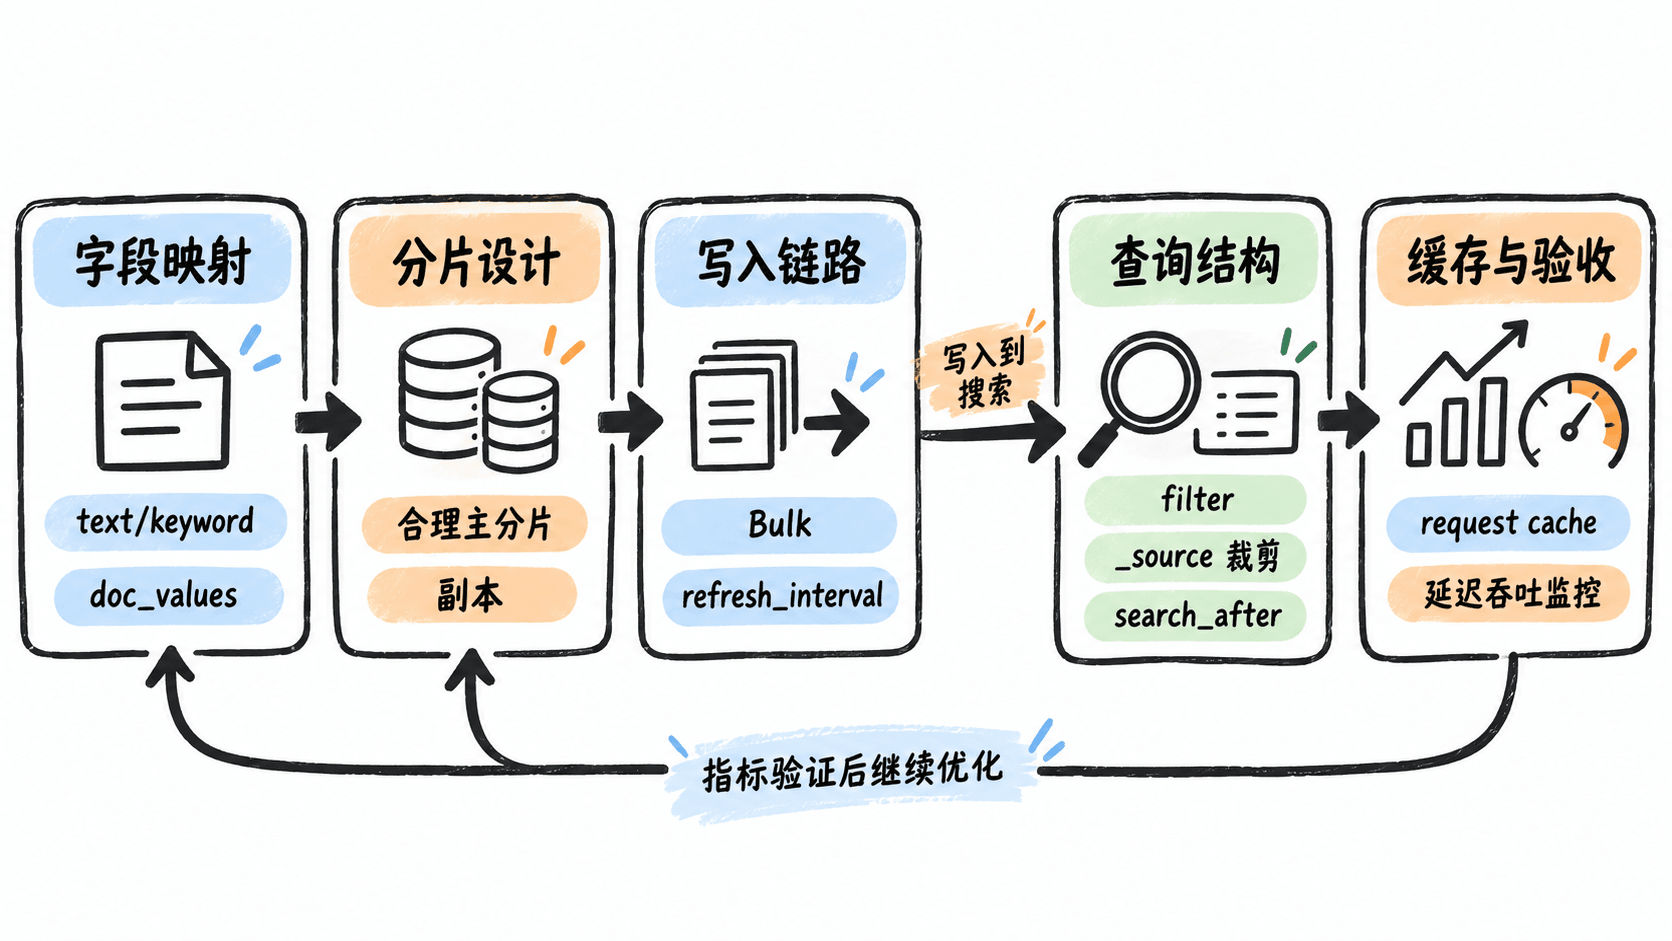
优化字段映射与分片设计
字段类型决定索引结构。全文检索使用 text,精确过滤、排序和聚合使用 keyword;不参与搜索的字段可设置 "index": false;大文本若不需要聚合和排序,不要额外创建 keyword 子字段。错误映射通常只能通过新索引重建修复。
下面创建一个最小索引:订单号用于精确查询,标题用于全文检索,备注只保存在 _source 中;主分片数按当前数据规模设为 3,副本数设为 1。
curl -s -X PUT "http://<HOST>:9200/orders-v2" \
  -H "Content-Type: application/json" \
  -d '{
    "settings": {
      "number_of_shards": 3,
      "number_of_replicas": 1,
      "refresh_interval": "5s"
    },
    "mappings": {
      "properties": {
        "order_no": { "type": "keyword" },
        "title": { "type": "text" },
        "amount": { "type": "scaled_float", "scaling_factor": 100 },
        "created_at": { "type": "date" },
        "remark": { "type": "keyword", "index": false }
      }
    }
  }'
预期结果:HTTP 200,响应体如下。
{"acknowledged":true,"shards_acknowledged":true,"index":"orders-v2"}分片不是越多越快。过多小分片会增加堆内存、文件句柄和协调开销;过大的分片又会延长迁移与恢复时间。应根据单分片数据量、节点数和恢复窗口测试,而不是机械套用固定数字。
优化批量写入链路
高频逐条写入会产生大量网络往返和刷新成本。Bulk 请求应按字节大小和处理时间控制批次,常见起点是每批数百到数千条,再根据写入延迟、堆内存和 write 线程池拒绝数调节。全量回灌时可临时增大 refresh_interval,完成后必须恢复。
cat > /tmp/orders.ndjson <<'EOF'
{"index":{"_index":"orders-v2","_id":"1001"}}
{"order_no":"A1001","title":"无线键盘","amount":199.00,"created_at":"2026-08-03T00:00:00Z","remark":"first"}
{"index":{"_index":"orders-v2","_id":"1002"}}
{"order_no":"A1002","title":"人体工学鼠标","amount":299.00,"created_at":"2026-08-03T00:01:00Z","remark":"second"}
EOF
curl -s -X POST "http://<HOST>:9200/_bulk" \
  -H "Content-Type: application/x-ndjson" \
  --data-binary @/tmp/orders.ndjson
预期结果:HTTP 200,响应体如下。
{"took":<MILLISECONDS>,"errors":false,"items":[{"index":{"_index":"orders-v2","_id":"1001","status":201}},{"index":{"_index":"orders-v2","_id":"1002","status":201}}]}<MILLISECONDS> 会随环境变化。若 errors 为 true,必须逐项检查 items,只重试失败记录,避免整批重复写入。
优化查询结构
查询应尽早缩小候选集。精确条件放入 bool.filter,因为过滤条件不参与相关性评分;只返回页面需要的 _source 字段;深分页使用 search_after,不要持续增加 from;聚合前先过滤时间范围和业务范围。
curl -s -X POST "http://<HOST>:9200/orders-v2/_search" \
  -H "Content-Type: application/json" \
  -d '{
    "size": 10,
    "_source": ["order_no", "title", "amount"],
    "query": {
      "bool": {
        "must": [
          { "match": { "title": "鼠标" } }
        ],
        "filter": [
          { "range": { "amount": { "gte": 100, "lte": 500 } } },
          { "range": { "created_at": { "gte": "2026-08-01T00:00:00Z" } } }
        ]
      }
    },
    "sort": [
      { "created_at": "desc" },
      { "_id": "asc" }
    ]
  }'
预期结果:HTTP 200,响应体如下。
{"took":<MILLISECONDS>,"timed_out":false,"hits":{"total":{"value":1,"relation":"eq"},"hits":[{"_id":"1002","_source":{"order_no":"A1002","title":"人体工学鼠标","amount":299.0}}]}}若查询仍慢,可临时开启 Profile API 分析各查询子句耗时,但不要长期在生产高并发请求中启用,因为 Profile 本身会增加开销。
正确使用缓存并完成验收
查询缓存由 Elasticsearch 自动管理,适合重复出现且可复用的过滤条件;请求缓存更适合相同请求体的聚合查询。包含 now、随机分值或持续变化条件的请求通常难以稳定命中缓存。缓存只能减少重复计算,不能修复错误映射、分片过多或全量扫描。
curl -s "http://<HOST>:9200/orders-v2/_stats/request_cache,query_cache?filter_path=indices.*.total.request_cache.*,indices.*.total.query_cache.*"预期结果:HTTP 200,响应体如下。
{"indices":{"orders-v2":{"total":{"request_cache":{"memory_size_in_bytes":<BYTES>,"hit_count":<HITS>,"miss_count":<MISSES>},"query_cache":{"memory_size_in_bytes":<BYTES>,"hit_count":<HITS>,"miss_count":<MISSES>}}}}}验收时使用与基线相同的数据量、查询集和并发度,对比 P95/P99 延迟、吞吐、CPU、堆内存、磁盘 I/O、GC 时间和线程池拒绝数。一次只改一类变量,保留回滚方式;如果延迟下降但拒绝数或资源占用明显上升,就不能视为稳定优化。
本课总结
- 性能优化应从基线出发,按映射、分片、写入、查询和缓存逐层定位。
- Bulk、合理刷新间隔、过滤条件和字段裁剪通常能带来直接收益,但必须结合资源指标验证。
- 优化是否成功由稳定的延迟、吞吐和错误率共同决定,而不是某个参数看起来更大或更激进。
下一课预告
后续将把健康排查与性能指标结合起来,建立可持续的 Elasticsearch 监控、告警和容量治理流程。