
NoSQL 与搜索 / 系统课时
关键词与向量混合搜索
关键词与向量混合搜索
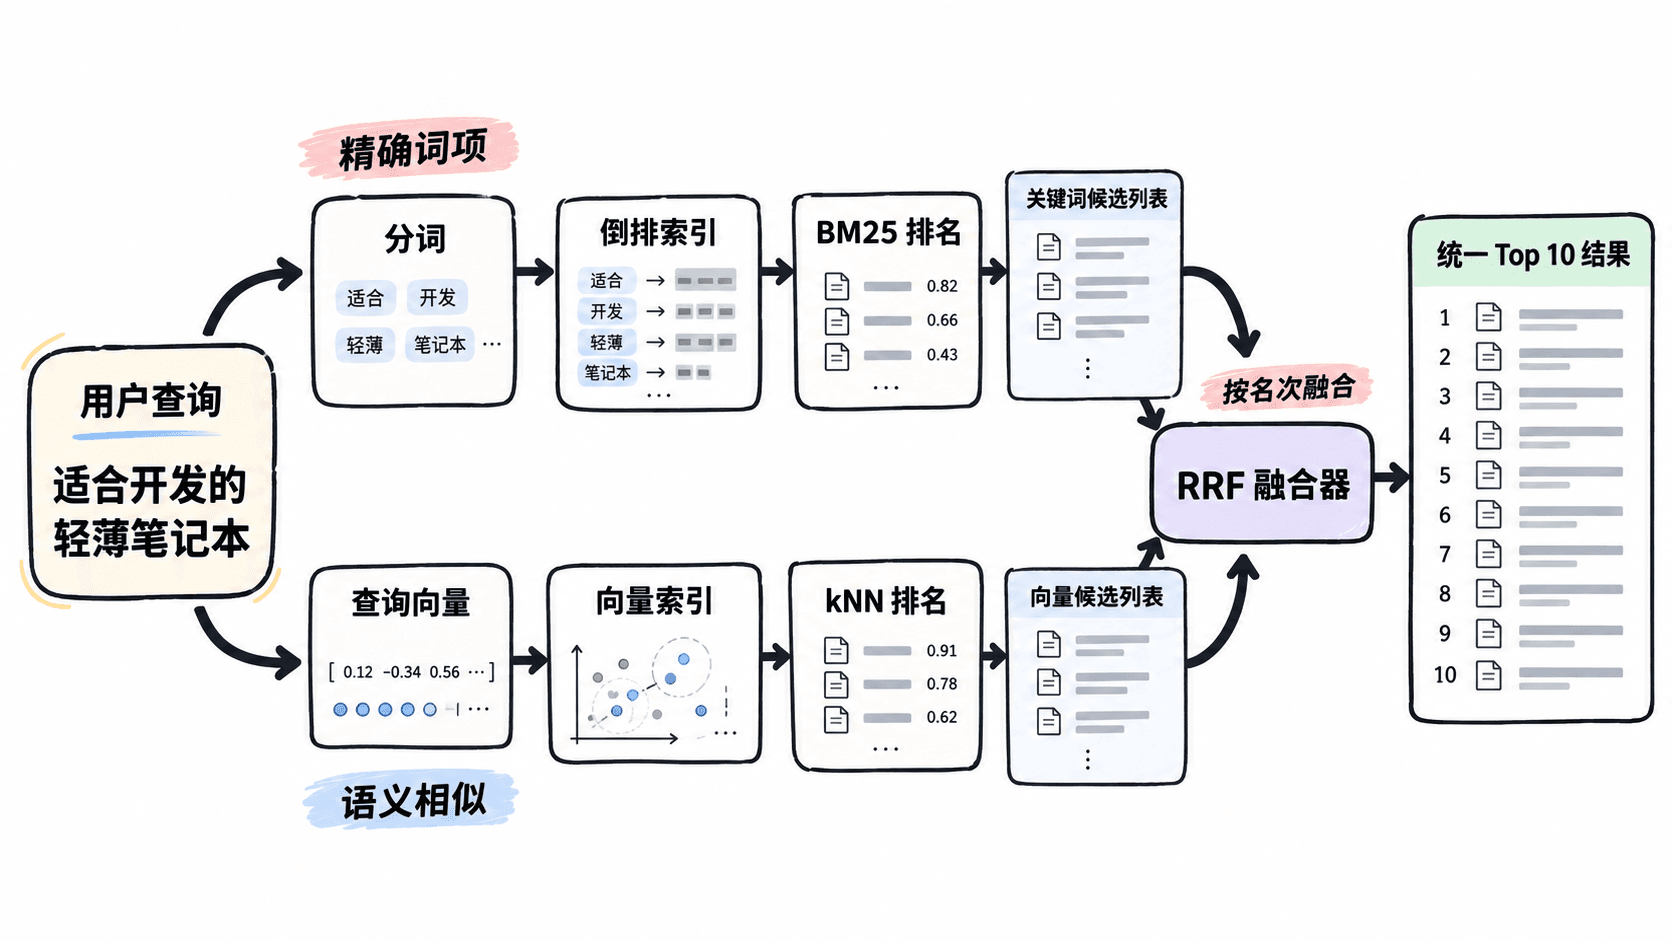
关键词检索擅长命中产品名、型号和专有词,向量检索擅长理解近义表达与隐含意图。本课将把两条召回链路并行执行,再用 RRF 融合排名,得到兼顾精确匹配与语义召回的搜索结果。
学习目标
- 说明关键词检索与向量检索各自解决的问题
- 使用 RRF 组合全文查询和 kNN 向量查询
- 根据召回窗口与候选数量调整混合检索效果
为什么要混合两种检索
全文查询依赖倒排索引,适合“iPhone 15 Pro”“退款接口”等包含明确词项的查询。向量查询比较查询向量与文档向量的相似度,即使原文没有出现完全相同的词,也可能召回语义接近的内容。
单独使用关键词检索,容易漏掉同义词、口语化表达和描述性问题;单独使用向量检索,又可能把语义相近但关键型号、品牌或约束不匹配的文档排到前面。混合检索让两条链路分别产生候选集,再统一融合排名。
RRF 如何融合排名
RRF(Reciprocal Rank Fusion)不直接相加 BM25 分数与向量相似度,而是根据文档在每条结果列表中的名次计算贡献。文档在任一列表中越靠前,贡献越大;同时出现在两条列表中的文档会累加两份贡献。
这种方式避开了不同评分体系量纲不一致的问题。Elasticsearch 的 RRF retriever 可以组合 standard 与 knn 等子检索器,并通过 rank_window_size 控制参与融合的候选窗口。:contentReference[oaicite:0]{index=0}
实现混合查询
下面是片段示例,依赖已存在的 products 索引:title 和 description 为文本字段,embedding 为 4 维向量字段。实际系统应使用与索引文档相同的嵌入模型生成查询向量。
POST /products/_search
{
  "size": 10,
  "_source": ["title", "description"],
  "retriever": {
    "rrf": {
      "retrievers": [
        {
          "standard": {
            "query": {
              "multi_match": {
                "query": "适合开发的轻薄笔记本",
                "fields": ["title^2", "description"]
              }
            }
          }
        },
        {
          "knn": {
            "field": "embedding",
            "query_vector": [0.12, -0.31, 0.44, 0.08],
            "k": 50,
            "num_candidates": 200
          }
        }
      ],
      "rank_window_size": 100,
      "rank_constant": 60
    }
  }
}
预期结果
{
  "took": "<TIME>",
  "hits": {
    "hits": [
      {
        "_id": "<ID>",
        "_score": "<SCORE>",
        "_source": {
          "title": "<TITLE>",
          "description": "<DESCRIPTION>"
        }
      }
    ]
  }
}
请求成功时 HTTP 状态码为 200。<TIME>、<ID>、<SCORE> 等实际值由索引数据、分片状态和模型输出决定;重点验证返回结果是否同时覆盖精确型号命中与语义相关文档。
参数调优与边界
k 决定向量检索最终保留多少个近邻,num_candidates 决定近似搜索阶段检查多少候选。候选越多,召回通常越充分,但计算成本也越高。rank_window_size 应不小于最终分页所需范围,否则融合器看不到窗口之外的文档。
混合检索不是固定地让两种方法各占一半。对于型号、订单号、错误码等强关键词查询,可提高文本字段权重或先加过滤条件;对于自然语言问句,可扩大向量候选集。所有调整都应通过固定评测集验证,而不是只观察少量示例。
提示:过滤品牌、状态、价格区间等结构化条件时,应在两条召回链路中保持一致,避免关键词结果与向量结果来自不同业务范围。
本课总结
- 关键词检索保证精确词项命中,向量检索补充语义召回
- RRF 按名次融合结果,避免直接比较不同体系的原始分数
k、num_candidates与rank_window_size需要在质量和延迟之间平衡
下一课预告
下一课将建立查询集、相关性标注和评价指标,用统一方法比较关键词、向量与混合检索的真实效果。