
NoSQL 与搜索 / 系统课时
搜索系统解决什么问题
搜索系统解决什么问题
搜索系统解决的不是“把数据查出来”这么简单,而是让用户能在大量、非结构化且持续增长的数据中,快速找到最相关的内容,并完成筛选、排序和统计。本课将从站内搜索、日志检索和实时分析三个场景出发,说明传统数据库为什么难以独立承担这类任务。
学习目标
- 区分站内搜索、日志检索和实时分析的核心诉求
- 理解传统数据库在全文检索与相关性排序上的局限
- 判断哪些需求适合引入专用搜索系统
三类典型搜索需求
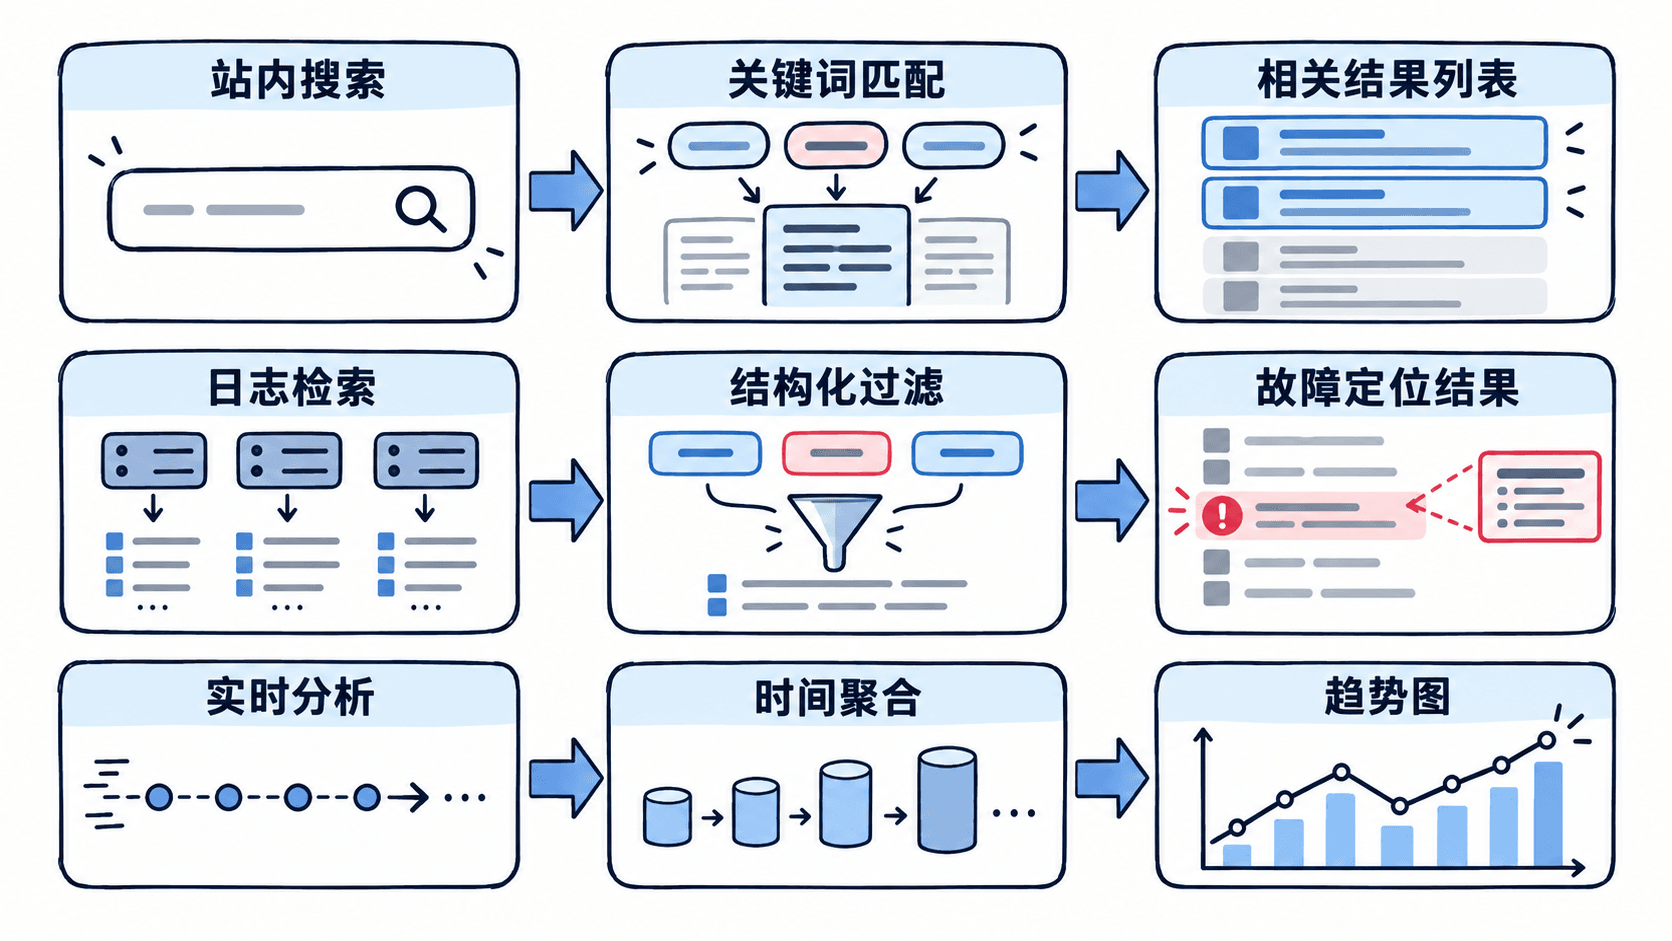
站内搜索关注“用户想找什么”。输入通常很短,可能包含错别字、同义词或不完整表达。系统不仅要返回包含关键词的记录,还要综合标题、正文、热度和时间计算相关性,让更有价值的结果排在前面。
日志检索关注“问题发生在哪里”。日志数量大、字段多、写入持续,排查时还会组合时间范围、服务名、状态码和关键字。系统必须同时支持全文搜索与结构化过滤,并在秒级内缩小故障范围。
实时分析关注“数据正在怎样变化”。例如统计最近十分钟的请求量、错误率和接口延迟分布。它不仅要求查到原始记录,还要按时间、地区或业务类型聚合,并尽快反映新写入的数据。
传统数据库为何吃力
关系数据库擅长精确条件、范围查询、关联和事务一致性,但全文搜索需要分词、倒排索引、相关性评分和高亮等能力。使用 LIKE '%关键词%' 虽然能完成简单包含匹配,却通常难以利用普通 B 树索引,也无法理解词语之间的相关程度。
下面的 SQL 可以直接在 MySQL 中运行,用来观察包含匹配的行为:
CREATE TEMPORARY TABLE products (
  id INT PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

INSERT INTO products (id, name) VALUES
  (1, 'Elasticsearch 搜索系统'),
  (2, '高性能日志检索平台'),
  (3, '关系数据库入门');

SELECT id, name
FROM products
WHERE name LIKE '%搜索%';
预期结果:
+----+----------------------------+
| id | name                       |
+----+----------------------------+
|  1 | Elasticsearch 搜索系统     |
+----+----------------------------+
结果只返回包含“搜索”这一连续字符串的记录,不会返回语义接近的“检索平台”。当数据量增大时,前置通配符还可能导致全表扫描,因此它适合小规模辅助查询,不适合作为复杂搜索系统的核心方案。
搜索系统如何工作
专用搜索系统通常在写入阶段先对文本分词,再建立“词到文档”的倒排索引。查询到来时,系统先找到包含相关词项的候选文档,再结合字段权重、词频、文档长度和业务规则计算得分,最后返回排序后的结果。
这种设计把部分计算从查询阶段提前到索引阶段,换取更快的搜索速度。过滤、聚合和高亮也围绕索引结构执行,因此能同时处理文本匹配与结构化条件。
何时应该引入搜索引擎
当需求主要是主键查询、精确条件、强事务更新或复杂表关联时,关系数据库仍是更合适的数据源。搜索引擎不应替代交易数据库,而应作为面向查询的索引层。
当系统出现大规模文本搜索、相关性排序、多条件日志排查、近实时聚合或模糊匹配需求时,可以把业务数据库中的数据同步到搜索引擎。数据库保存权威数据,搜索引擎负责快速检索,两者通过同步机制保持一致。
本课总结
- 搜索系统同时解决文本匹配、相关性排序、结构化过滤和聚合分析问题
- 传统数据库能完成简单包含查询,但缺少分词、倒排索引和相关性评分等核心机制
- 搜索引擎通常作为查询索引层,与业务数据库协同,而不是直接取代数据库
下一课预告
下一课将认识 Elasticsearch 的四类核心能力,并了解全文搜索、结构化过滤、聚合分析和向量检索如何组合成统一的搜索方案。