
NoSQL 与搜索 / 系统课时
集群监控指标
集群监控指标
本课建立一套可执行的 Elasticsearch 集群监控方法:从节点资源、JVM、线程池、请求吞吐与延迟一路检查到分片状态,并用增量计算避免被累计计数器误导。
学习目标
- 识别 JVM、CPU、磁盘、线程池与分片状态中的关键风险信号
- 使用集群与节点统计接口采集核心指标
- 用时间窗口增量计算查询延迟和写入速率
建立分层监控视角
集群监控不能只看 CPU。一次搜索请求会依次消耗节点资源、JVM 堆、线程池和分片执行能力,最终表现为延迟、吞吐或错误率变化。排查时应从结果指标向底层资源逐层回溯。
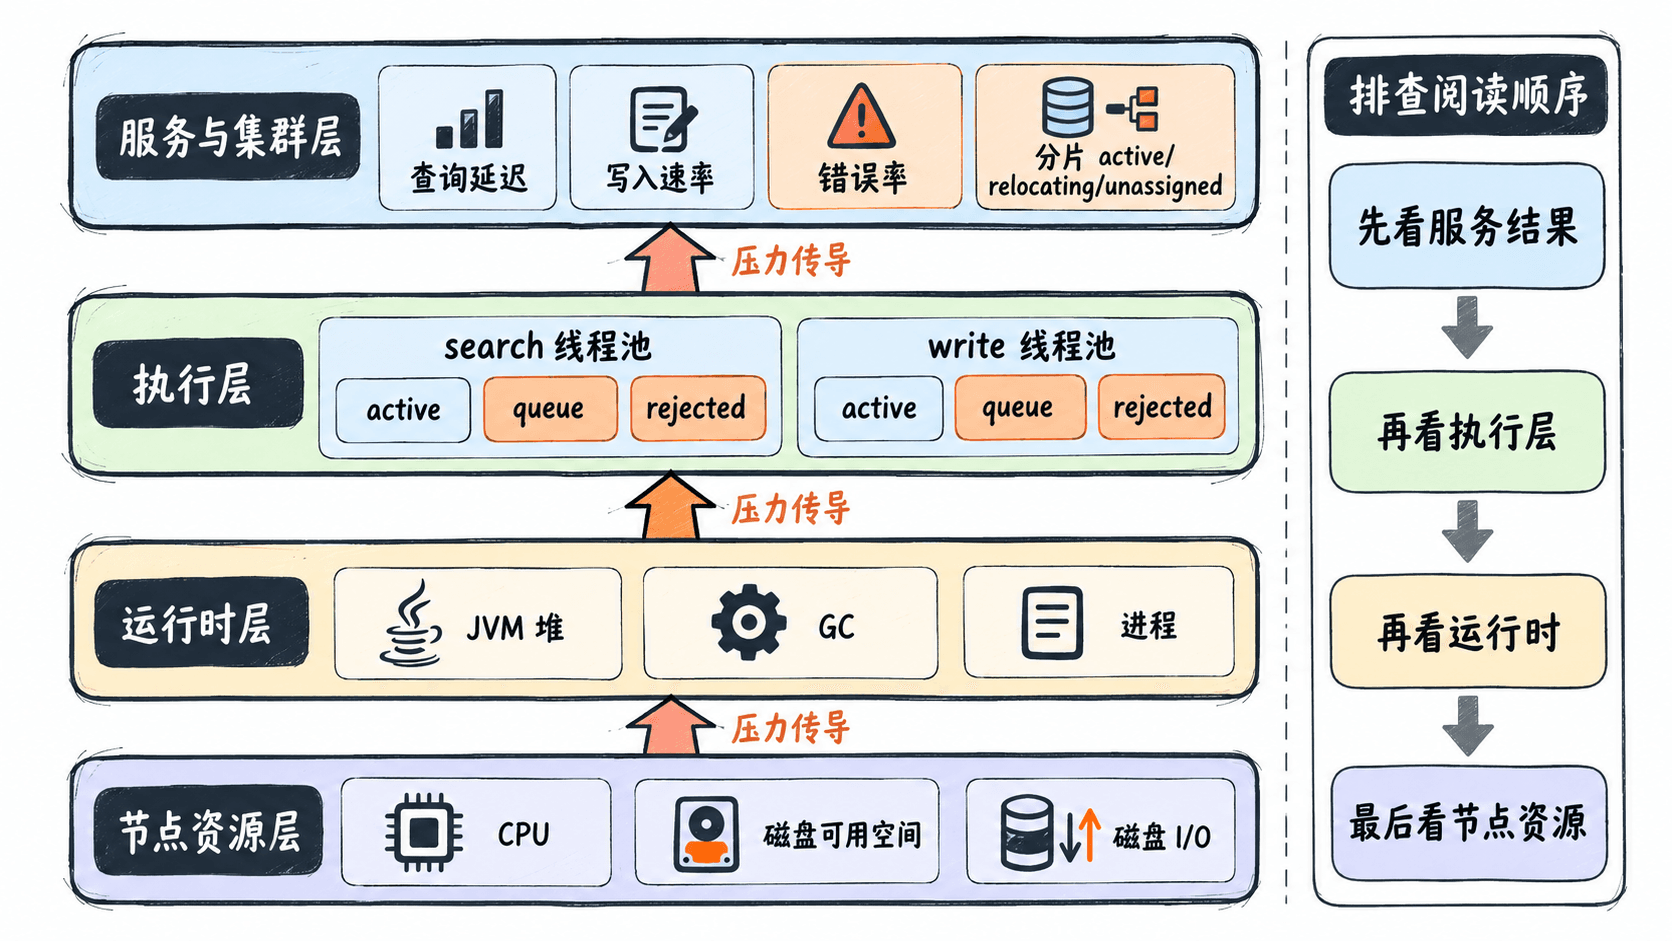
资源层回答“节点是否快到极限”,运行时层回答“JVM 是否发生内存压力”,执行层回答“请求是否开始排队或被拒绝”,服务层则回答“用户是否已经感知异常”。四层必须关联观察,单个瞬时峰值通常不能直接判定故障。
采集核心指标
下面的命令同时读取集群健康和节点统计。请将 <HOST>、<PORT>、<USER>、<PASSWORD> 替换为实际值;生产环境应使用安全凭据管理方式,避免把密码写入脚本或命令历史。
ES_URL="https://<HOST>:<PORT>"

curl -sS -u "<USER>:<PASSWORD>" \
  "$ES_URL/_cluster/health?level=indices&filter_path=cluster_name,status,number_of_nodes,active_shards,relocating_shards,initializing_shards,unassigned_shards"

curl -sS -u "<USER>:<PASSWORD>" \
  "$ES_URL/_nodes/stats/jvm,process,os,fs,thread_pool,indices?filter_path=nodes.*.name,nodes.*.jvm.mem.heap_used_percent,nodes.*.jvm.gc.collectors.*,nodes.*.process.cpu.percent,nodes.*.os.cpu.percent,nodes.*.fs.total.available_in_bytes,nodes.*.thread_pool.search.*,nodes.*.thread_pool.write.*,nodes.*.indices.search.query_total,nodes.*.indices.search.query_time_in_millis,nodes.*.indices.indexing.index_total,nodes.*.indices.indexing.index_time_in_millis"
预期输出
{"cluster_name":"<CLUSTER_NAME>","status":"green","number_of_nodes":"<COUNT>","active_shards":"<COUNT>","relocating_shards":"<COUNT>","initializing_shards":"<COUNT>","unassigned_shards":"<COUNT>"}
{"nodes":{"<NODE_ID>":{"name":"<NODE_NAME>","jvm":{"mem":{"heap_used_percent":"<PERCENT>"},"gc":{"collectors":{"young":{"collection_count":"<COUNT>","collection_time_in_millis":"<MILLIS>"}}}},"process":{"cpu":{"percent":"<PERCENT>"}},"os":{"cpu":{"percent":"<PERCENT>"}},"fs":{"total":{"available_in_bytes":"<BYTES>"}},"thread_pool":{"search":{"active":"<COUNT>","queue":"<COUNT>","rejected":"<COUNT>","completed":"<COUNT>"},"write":{"active":"<COUNT>","queue":"<COUNT>","rejected":"<COUNT>","completed":"<COUNT>"}},"indices":{"search":{"query_total":"<COUNT>","query_time_in_millis":"<MILLIS>"},"indexing":{"index_total":"<COUNT>","index_time_in_millis":"<MILLIS>"}}}}}
节点标识、计数器和时间值会随环境变化。命令成功时应返回集群状态和每个节点的统计对象;若权限不足,通常会得到 401 或 403,此时应为监控账号补充最小化的集群监控权限,而不是改用超级管理员长期采集。
正确解读资源与线程池
JVM 重点看堆使用趋势、老年代压力以及 GC 耗时是否持续上升。一次堆占用峰值并不等于内存泄漏;更危险的信号是堆长期高位、回收后下降有限,并伴随查询延迟增长。
CPU 要区分 Elasticsearch 进程 CPU 与操作系统总 CPU。进程 CPU 高说明工作负载集中在 Elasticsearch,系统 CPU 高但进程 CPU 不高时,还应检查同机其他进程、虚拟化争用或 I/O 等待。
磁盘不能只看“还有多少 GB”,还要与集群配置的磁盘水位比较。接近水位时,分片分配会受限,严重时索引可能进入写保护。线程池则重点关注 queue 和 rejected:短时 active 升高可以正常,队列持续堆积或拒绝数增长说明处理能力已经落后于请求进入速度。
计算延迟与吞吐
query_total、query_time_in_millis 和 index_total 都是节点启动后的累计值。监控系统应在固定窗口内取两次样本,再计算增量,而不是直接使用累计总量。
查询平均耗时可按下面的方式计算:
写入速率则为:
例如 60 秒内查询累计耗时增加 120000 毫秒、查询次数增加 4000 次,则窗口平均查询耗时为 30 毫秒。平均值无法代替 P95、P99;线上还应由监控系统或调用链记录分位延迟,避免少量慢请求被平均值掩盖。
设置告警与验证闭环
告警应同时包含“阈值”和“持续时间”。例如 CPU 瞬时升高不一定有问题,但搜索线程池队列持续增长、拒绝计数增加并伴随 P95 延迟恶化,就应触发高优先级告警。
建议至少建立三类组合告警:资源风险关注堆、GC、CPU 与磁盘;容量风险关注线程池排队、拒绝和写入速率;集群风险关注 yellow、red、未分配分片和频繁迁移。每条告警都要附带节点、索引、时间窗口与当前值,确保值班人员可以直接进入下一步定位。
验证监控是否有效时,可在测试环境制造一段可控查询或批量写入负载,确认指标能上升、告警能触发、负载停止后状态能恢复。不要在生产环境通过故意打满资源来验证告警。
本课总结
- 集群监控应从服务结果、执行队列、JVM 到节点资源分层关联分析
- 累计计数器必须按时间窗口取增量,才能得到可信的延迟与速率
- 持续排队、拒绝增长、磁盘水位风险和未分配分片比单次峰值更值得告警
下一课预告
下一课将使用慢日志、任务接口和热点线程,把已经发现的延迟或资源异常进一步定位到具体查询、写入任务与执行线程。