
NoSQL 与搜索 / 系统课时
分片路由与副本
分片路由与副本
本课解决“文档写到哪个分片、查询为什么会访问多个分片、分片数量如何影响性能”三个问题。完成后,你可以解释主分片定位、副本同步和查询分发过程,并用一个可验证示例观察自定义路由带来的请求范围变化。
学习目标
- 解释文档路由到主分片的基本规则
- 串联主分片写入、副本复制和查询分发过程
- 根据数据量、节点数与查询模式评估分片数量
文档如何定位主分片
索引创建后,主分片数量通常保持不变。写入文档时,Elasticsearch 会对路由值计算哈希,再把结果映射到某个主分片。默认路由值是文档 _id;显式传入 routing 后,同一路由值的文档会稳定落到同一分片。
为了建立直觉,可以把默认过程理解为下面的简化模型,其中 是主分片数量:
该公式用于理解“相同路由值会落到相同主分片”。实际实现还会考虑内部路由分片、索引拆分和路由分区等细节,因此不要依赖手工计算结果来猜测具体分片编号。
写入、副本与查询如何协作
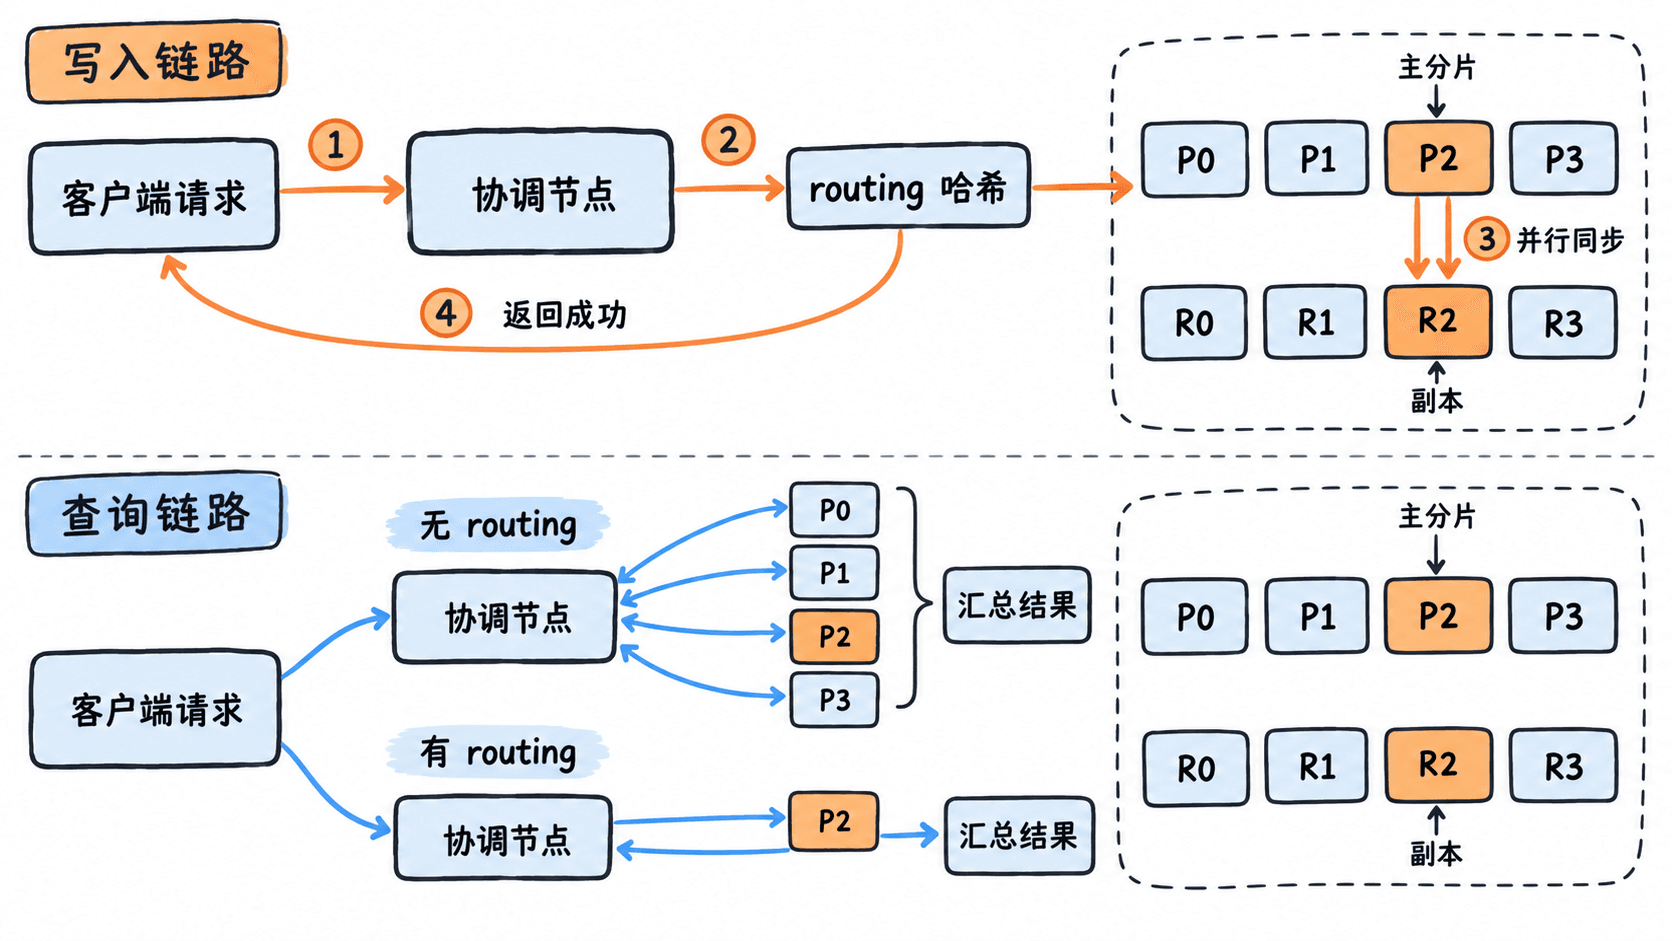
协调节点收到写入请求后,先根据路由值找到目标主分片。主分片完成校验和本地写入,再把操作复制到处于活动状态的副本分片;达到请求所需的活动分片条件后,协调节点才向客户端返回结果。
查询请求采用 scatter-gather 模式。协调节点先确定需要访问哪些分片,把查询阶段分发出去,再汇总候选文档并完成取回阶段。没有路由条件时,查询通常需要访问索引的所有相关主分片或副本分片;指定路由后,可以缩小到包含该路由值的分片集合。
用自定义路由观察请求范围
下面的完整示例可直接在 Kibana Dev Tools 中执行。它创建 4 个主分片且不配置副本,避免单节点实验环境因副本无法分配而出现干扰;生产环境是否设置副本应按可用性目标决定。
PUT /orders
{
  "settings": {
    "number_of_shards": 4,
    "number_of_replicas": 0
  },
  "mappings": {
    "properties": {
      "merchantId": { "type": "keyword" },
      "amount": { "type": "long" }
    }
  }
}

PUT /orders/_doc/order-1001?routing=merchant-42&refresh=wait_for
{
  "merchantId": "merchant-42",
  "amount": 19900
}

GET /orders/_search?routing=merchant-42
{
  "query": {
    "term": {
      "merchantId": "merchant-42"
    }
  }
}

GET /orders/_search
{
  "query": {
    "term": {
      "merchantId": "merchant-42"
    }
  }
}
预期结果
以下仅展示与本课有关的响应字段,<TIME_MS>、<SEQ_NO> 和 <PRIMARY_TERM> 等实际值可能不同。
创建索引:HTTP 200
{"acknowledged":true,"shards_acknowledged":true,"index":"orders"}

写入文档:HTTP 201
{"_index":"orders","_id":"order-1001","_version":1,"result":"created","_seq_no":<SEQ_NO>,"_primary_term":<PRIMARY_TERM>}

带 routing 查询:HTTP 200
{"took":<TIME_MS>,"timed_out":false,"_shards":{"total":1,"successful":1,"skipped":0,"failed":0},"hits":{"total":{"value":1,"relation":"eq"}}}

不带 routing 查询:HTTP 200
{"took":<TIME_MS>,"timed_out":false,"_shards":{"total":4,"successful":4,"skipped":0,"failed":0},"hits":{"total":{"value":1,"relation":"eq"}}}
由此可以看到,自定义路由不会改变匹配结果,却能减少查询需要访问的分片。代价是同一路由键的数据可能集中到少数分片,因此路由键必须具有足够离散度,不能长期把大多数数据压到一个热点键上。
分片数量如何影响系统
分片太少时,单分片会变大,迁移、恢复和单分片查询的并行度受限;分片太多时,每个分片都要消耗文件句柄、堆内存和集群状态空间,查询还会产生更多扇出与归并开销。
规划时应同时观察单分片大小、数据增长周期、数据节点数量、恢复时间和查询模式。不要只按当前数据量计算,也不要套用固定“每节点多少分片”的经验值。更可靠的方法是用接近生产的数据和查询进行压测,再通过 rollover、数据流或重建索引调整后续分片布局。
| 现象 | 可能的分片问题 | 调整方向 |
|---|---|---|
| 单分片恢复时间过长 | 分片过大 | 增加后续索引主分片数或缩短 rollover 周期 |
| 小索引占用大量资源 | 分片过多 | 合并索引、减少主分片或缩短保留范围 |
| 查询扇出高、协调压力大 | 分片数量过多或路由缺失 | 减少分片,或在业务允许时使用稳定路由键 |
| 某个分片持续高负载 | 路由键倾斜 | 更换离散度更高的路由策略 |
副本的边界与验证重点
副本可以提高读取并发,并在主分片所在节点故障时参与故障恢复,但它不会自动修复错误的数据模型,也不能替代跨集群备份。副本数量增加还会放大写入、网络和磁盘成本。
验证副本策略时,应确认副本分布在不同数据节点、集群健康状态符合预期,并通过节点故障演练观察主分片重新选定和业务恢复时间。单节点集群即使配置副本,副本也无法与主分片分配到同一节点,因此通常会保持未分配状态。
本课总结
- 路由值决定文档所在主分片,默认使用
_id - 写入先到主分片再复制到副本,查询由协调节点分发并汇总
- 分片数量和路由策略必须同时考虑容量、恢复时间、查询扇出与热点风险
下一课预告
下一课将继续学习分片分配与集群恢复,重点理解节点故障后分片如何重新分配,以及如何判断集群从黄色或红色状态恢复到绿色。