
NoSQL 与搜索 / 系统课时
模糊搜索与拼写纠错
模糊搜索与拼写纠错
精确词项无法命中少字、多字、错字或相邻字符颠倒的输入。本课使用 match 查询的 fuzziness 参数构建可容错搜索,并通过 prefix_length 与 max_expansions 限制候选扩展,避免用性能换取无边界召回。
学习目标
- 理解模糊匹配使用的编辑距离及
AUTO规则 - 为全文字段配置可控的拼写容错查询
- 评估召回提升、误匹配与查询成本之间的取舍
fuzziness 如何容忍拼写错误
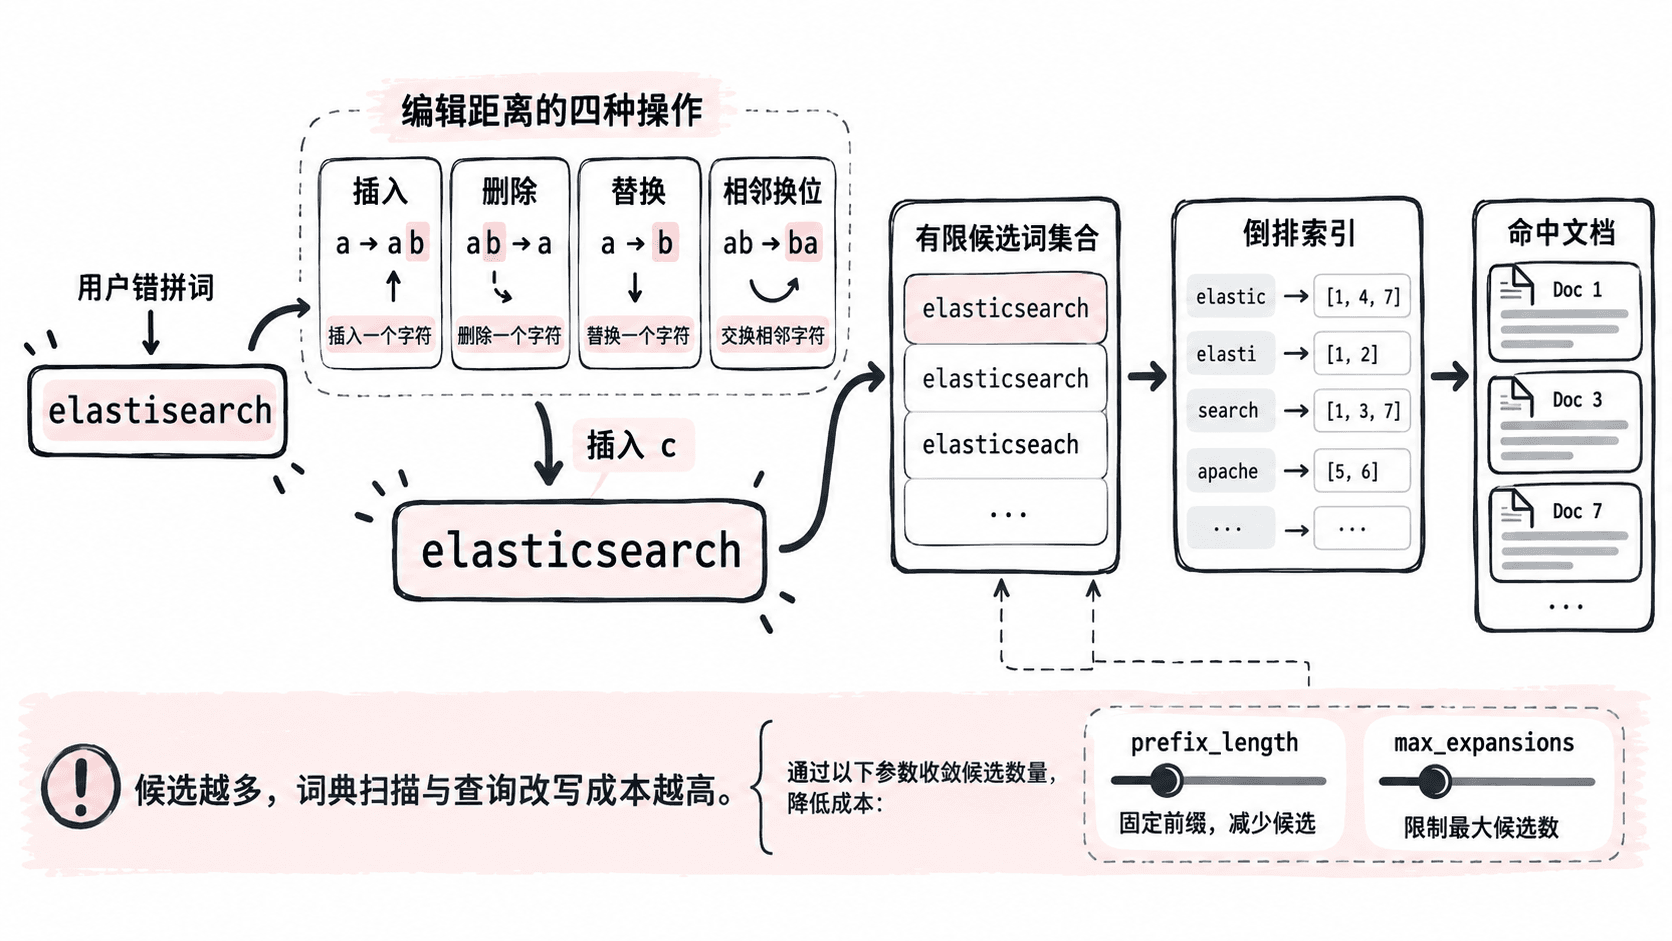
Elasticsearch 在文本或关键字词项上把 fuzziness 解释为 Levenshtein 编辑距离,即把一个词变成另一个词所需的单字符插入、删除、替换或相邻字符换位次数。AUTO 默认按词项长度决定距离:长度 0~2 必须精确,3~5 允许一次编辑,超过 5 允许两次编辑。:contentReference[oaicite:1]{index=1}
match 查询会先分析输入,再对生成的词元应用模糊匹配,适合全文字段;fuzzy 查询属于词项级查询,会直接围绕给定词项生成候选扩展。全文搜索通常优先从 match + fuzziness 开始。:contentReference[oaicite:2]{index=2}
建立最小测试数据
下面创建两个英文标题。第一次运行可直接执行;重复练习前需先删除同名索引。
PUT /fuzzy-demo
{
  "mappings": {
    "properties": {
      "title": {
        "type": "text",
        "analyzer": "standard"
      }
    }
  }
}

PUT /fuzzy-demo/_doc/1
{
  "title": "elasticsearch guide"
}

PUT /fuzzy-demo/_doc/2
{
  "title": "distributed search tutorial"
}

POST /fuzzy-demo/_refresh
预期结果
索引创建成功;两次写入分别返回 201 Created;刷新请求返回 200 OK。
响应中的耗时、分片统计等动态值可能不同。
从精确匹配切换到模糊匹配
查询词 elastisearch 比索引词元 elasticsearch 少一个字符。先执行不允许编辑的查询,再启用 AUTO,即可看到召回差异。
GET /fuzzy-demo/_search?filter_path=hits.total.value,hits.hits._id
{
  "query": {
    "match": {
      "title": {
        "query": "elastisearch",
        "fuzziness": 0
      }
    }
  }
}

GET /fuzzy-demo/_search?filter_path=hits.total.value,hits.hits._id
{
  "query": {
    "match": {
      "title": {
        "query": "elastisearch",
        "fuzziness": "AUTO",
        "prefix_length": 3,
        "max_expansions": 20
      }
    }
  }
}
预期结果
fuzziness=0:命中数为 0。
fuzziness=AUTO:命中数为 1,命中文档 ID 为 1。
_score 的具体数值可能因版本及索引统计信息不同。
prefix_length=3 要求词项开头三个字符保持不变,可减少明显无关的扩展;max_expansions=20 限制查询最多展开的候选词项数量。它们不是越大越好,而是用于控制召回边界和词典扩展成本。
控制召回率与查询成本
模糊查询会生成多个候选词项,再对候选执行精确词项匹配。官方文档特别提醒:当 prefix_length=0 时,不应把 max_expansions 设得过高;fuzzy 查询在 search.allow_expensive_queries=false 时不会执行。:contentReference[oaicite:3]{index=3}
生产环境可采用三步策略:先用真实错拼日志统计高频错误,再从 AUTO、较短候选上限和非零前缀开始,最后用延迟、召回率和人工相关性标注共同验收。高频固定错词更适合同义词或查询改写,不能全部交给模糊查询。
中文字段还要注意分词后的词元长度。AUTO 对一到两个字符的短词元要求精确匹配,因此“已经启用 fuzziness 却没有纠错”可能是分词结果过短,而不是参数未生效。应先用 _analyze 查看实际词元,再决定使用自定义距离、同义词或专门的纠错方案。
Tips:不要把
fuzziness=2作为所有查询的默认值。短词上的两次编辑可能产生大量无关候选,既降低相关性,也放大查询成本。
本课总结
fuzziness用编辑距离容忍插入、删除、替换和相邻换位AUTO是常用起点,prefix_length与max_expansions用于收敛扩展- 模糊搜索应由真实错拼样本和性能指标驱动,不能替代同义词与规则纠错
下一课预告
下一课将继续进入全文相关性控制,学习如何组合查询条件并让更重要的匹配获得更高权重。