
NoSQL 与搜索 / 系统课时
结果折叠与去重
结果折叠与去重
当多条命中文档属于同一商品、主题或会话时,直接展示会让列表被重复内容占满。本课使用字段折叠保留每组代表结果,并通过 inner_hits 返回组内近期文档,完成可运行的分组展示查询。
学习目标
- 理解字段折叠与真正删除重复数据的区别
- 使用
collapse按单值字段返回每组代表文档 - 使用
inner_hits控制组内结果数量和排序
折叠解决什么问题
字段折叠只改变搜索结果的展示方式,不会删除索引中的文档,也不会修改查询命中的文档总数。Elasticsearch 先执行查询和顶层排序,再按折叠字段分组,每组只把排名最高的一条文档放入顶层 hits。
适合折叠的字段通常是 keyword 或数值类型,并且每条文档只能提供一个分组值。字段需要支持文档值,以便搜索阶段快速读取。典型场景包括同一商品的多个版本、同一主题的多篇文章和同一会话的多条事件。
代表结果与组内结果
顶层排序决定哪个分组先出现,也决定每组哪条文档成为代表结果。inner_hits 会针对每个已返回的分组再取一组内部命中,因此可以使用独立的 size 和 sort,例如展示每个主题下最新的两篇文章。
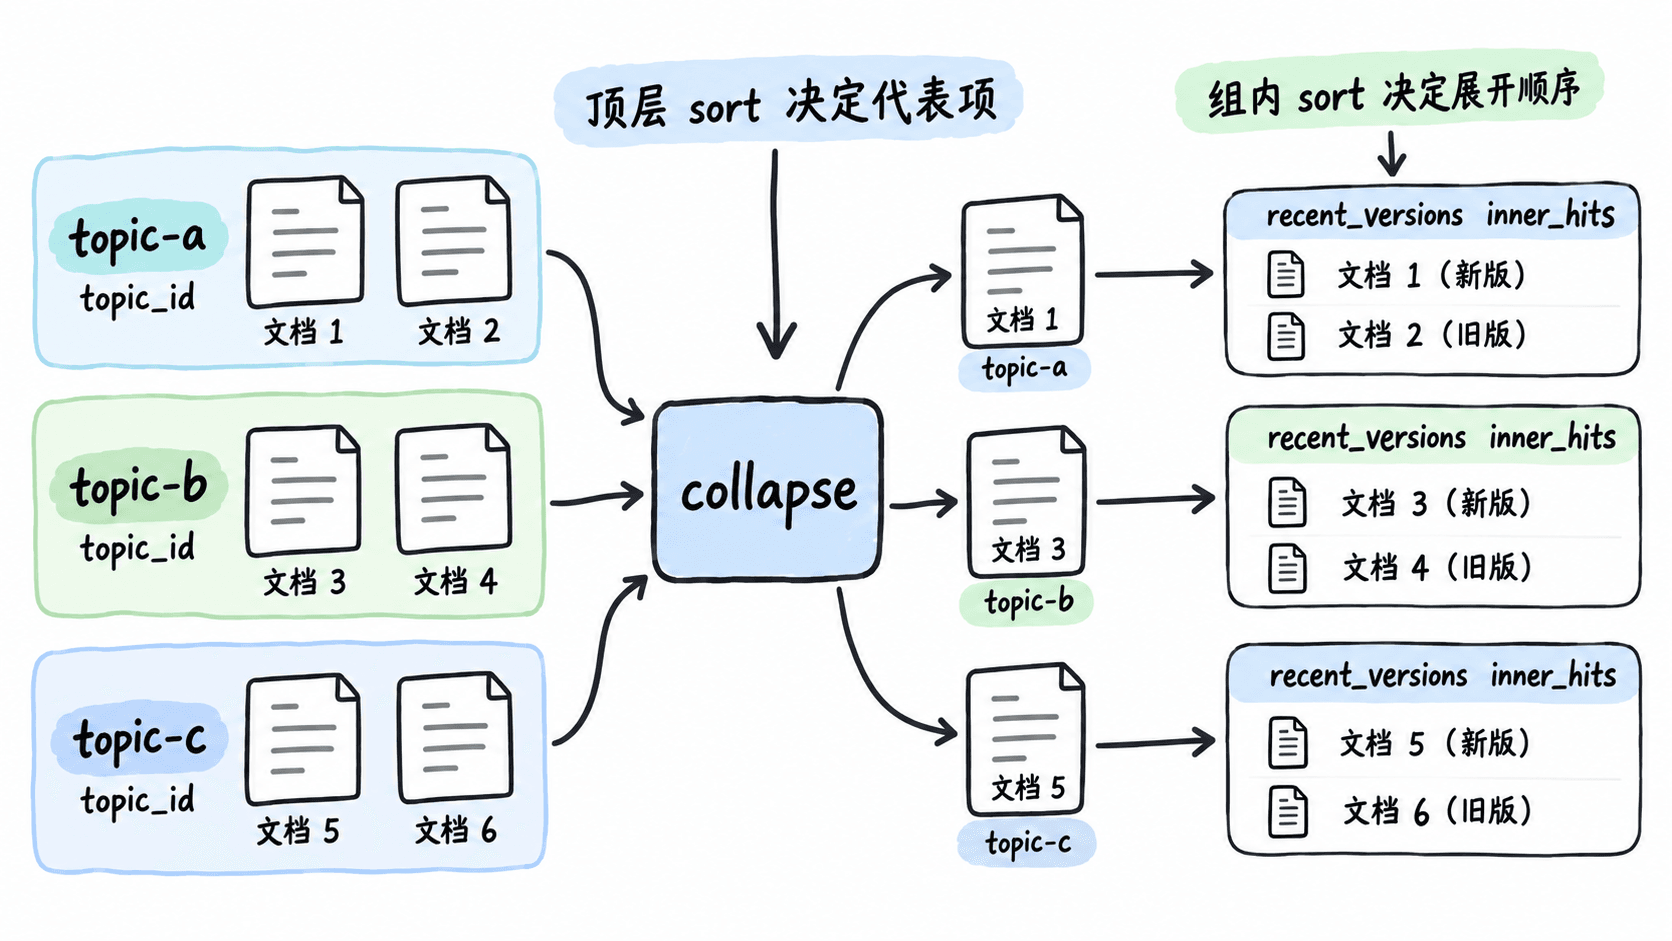
折叠后的顶层结果可以理解为“分组入口”,而 inner_hits 是入口下面的明细列表。组数和组内条数都应受限,否则搜索会为大量分组执行额外的展开工作。
查询折叠结果
下面的示例创建四篇文章,其中两篇属于 topic-a,两篇属于 topic-b。查询按发布时间倒序排列分组代表文档,并在每组内返回最近两篇文章。
PUT /articles_collapse
{
  "mappings": {
    "properties": {
      "article_id": { "type": "keyword" },
      "topic_id": { "type": "keyword" },
      "title": { "type": "text" },
      "published_at": { "type": "date" }
    }
  }
}

POST /articles_collapse/_bulk?refresh=true
{"index":{"_id":"A1"}}
{"article_id":"A1","topic_id":"topic-a","title":"搜索排序基础","published_at":"2026-08-01T09:00:00Z"}
{"index":{"_id":"A2"}}
{"article_id":"A2","topic_id":"topic-a","title":"搜索排序进阶","published_at":"2026-08-03T10:00:00Z"}
{"index":{"_id":"B1"}}
{"article_id":"B1","topic_id":"topic-b","title":"聚合入门","published_at":"2026-08-01T08:00:00Z"}
{"index":{"_id":"B2"}}
{"article_id":"B2","topic_id":"topic-b","title":"聚合实战","published_at":"2026-08-03T11:00:00Z"}

GET /articles_collapse/_search
{
  "size": 2,
  "query": {
    "match_all": {}
  },
  "collapse": {
    "field": "topic_id",
    "inner_hits": {
      "name": "recent_versions",
      "size": 2,
      "sort": [
        { "published_at": "desc" },
        { "article_id": "asc" }
      ]
    }
  },
  "sort": [
    { "published_at": "desc" },
    { "article_id": "asc" }
  ]
}
预期结果如下。实际响应中的 inner_hits 会包含完整命中文档,这里按展示顺序列出关键字段。
创建索引:acknowledged = true
批量写入:errors = false
HTTP 状态码:200

顶层第 1 组:topic-b
代表文档:B2
recent_versions:B2、B1

顶层第 2 组:topic-a
代表文档:A2
recent_versions:A2、A1

hits.total.value:4
size: 2 控制返回两个折叠组,不是每组两条文档;组内两条由 inner_hits.size 控制。hits.total.value 仍表示原始查询命中的文档数,因此不能直接把它当作分组总数。
选择折叠还是聚合
字段折叠面向搜索结果列表,重点是返回可直接展示的代表文档。terms 配合 top_hits 更适合统计和分桶,但响应结构与普通命中列表不同。
| 需求 | 推荐方式 | 关键结果 |
|---|---|---|
| 搜索列表中每组只显示一条 | collapse |
顶层 hits 直接返回代表文档 |
| 代表文档下展开少量明细 | collapse + inner_hits |
每个代表命中带组内结果 |
| 统计每组数量或计算指标 | terms 等聚合 |
aggregations 返回桶和指标 |
折叠不会改变聚合结果。若同一请求同时包含 collapse 与聚合,聚合仍基于全部查询命中文档计算。需要准确分组数量时,应单独设计聚合或维护可统计的分组数据。
性能提示:
inner_hits会对每个返回分组执行额外展开。应限制顶层size、组内size和排序复杂度,不要一次展开大量分组及大量明细。
本课总结
collapse只压缩搜索展示结果,不删除文档,也不改变原始命中总数- 顶层排序决定分组代表文档,
inner_hits的独立排序决定组内明细顺序 - 需要分组统计时应使用聚合,不能把折叠后的
hits当作完整分桶结果
下一课预告
下一课将继续学习搜索体验功能,并用同样的请求、响应和性能边界方法验证其实际效果。