
NoSQL 与搜索 / 系统课时
向量相似度评分
向量相似度评分
本课解决“同一批向量为什么会得到不同排序”的问题。你将从方向、长度和空间距离三个角度理解余弦相似度、点积与欧氏距离,并结合模型是否归一化选择 Elasticsearch 的 similarity。
学习目标
- 解释三种评分方式分别关注向量的哪些特征
- 根据嵌入模型输出选择合适的相似度
- 理解 Elasticsearch 如何把原始相似度转换为
_score
三种评分方式的本质
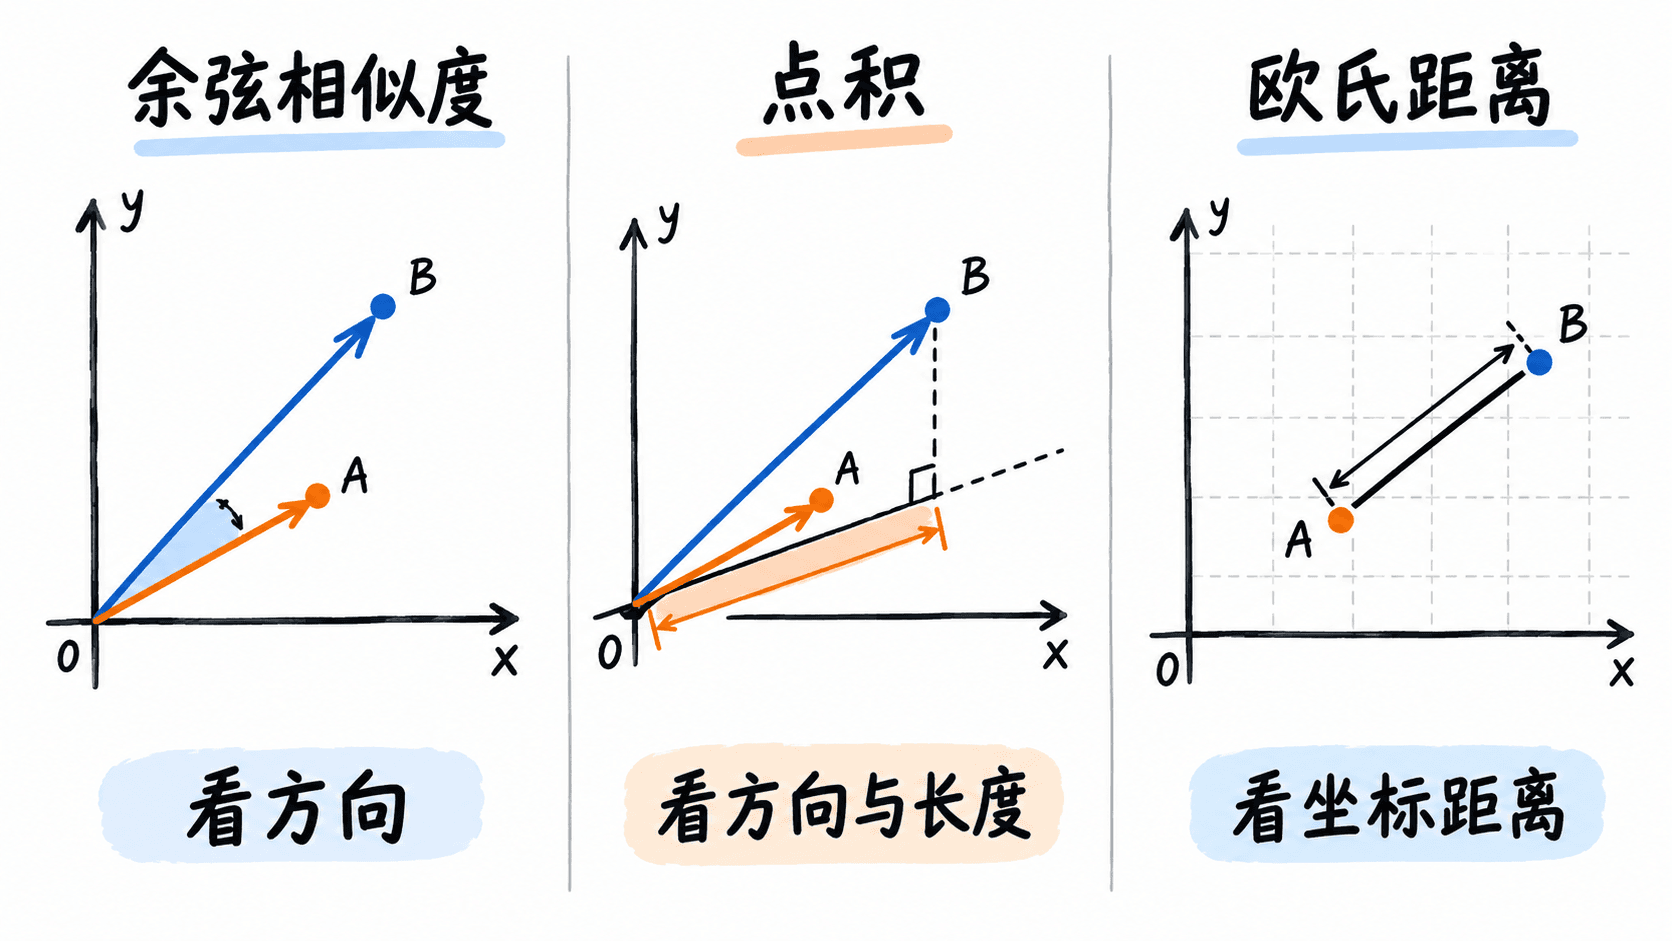
余弦相似度比较两个向量的夹角,公式为 。只要方向相同,即使向量长度不同,结果也接近 1,因此它适合“方向代表语义、长度不应影响排序”的嵌入。
点积直接计算 ,同时受到方向和长度影响。两个向量方向相近时,长度更大的向量可能得到更高分。Elasticsearch 的浮点 dot_product 要求文档向量和查询向量都是单位向量;若模型已经完成 L2 归一化,它与余弦相似度会产生相同排序,并可使用更直接的计算方式。:contentReference[oaicite:2]{index=2}
欧氏距离衡量两点在向量空间中的直线距离,距离越小越相似。它保留绝对坐标和尺度差异,适合向量位置本身具有度量意义的场景,但对不同维度的量纲和数值范围更敏感。
在 Elasticsearch 中选择评分方式
相似度在 dense_vector 映射中确定。普通浮点向量默认使用 cosine;选择 dot_product 时必须保证向量已归一化;选择 l2_norm 时应确保各维度尺度可比较。字段建立索引后,不应把更换评分方式当作普通查询参数,通常需要创建新字段或新索引并重新写入向量。
下面是创建索引请求体的片段示例,需要作为 PUT /vector-score-demo 的请求体提交。验证时可执行 GET vector-score-demo/_mapping,检查 embedding.similarity 是否为 cosine。
{
  "mappings": {
    "properties": {
      "embedding": {
        "type": "dense_vector",
        "dims": 3,
        "index": true,
        "similarity": "cosine"
      }
    }
  }
}
Elasticsearch 会把不同指标转换成“越大越好”的正 _score。对浮点向量,余弦和单位向量点积使用 (1 + similarity) / 2;L2 使用 1 / (1 + distance²)。因此 _score 适合在同一字段、同一指标下排序,不应直接把不同指标的分数当作同一量纲比较。:contentReference[oaicite:3]{index=3}
用可运行示例观察排序差异
下面的 Python 程序对同一组二维向量计算三种指标。向量 B 与查询向量方向完全相同但长度更大;向量 C 长度接近,却存在明显夹角。
from math import sqrt
from typing import List

Vector = List[float]

def dot(a: Vector, b: Vector) -> float:
    return sum(x * y for x, y in zip(a, b))

def norm(v: Vector) -> float:
    return sqrt(dot(v, v))

def cosine(a: Vector, b: Vector) -> float:
    # 零向量没有可定义的方向,生产代码应提前拒绝。
    return dot(a, b) / (norm(a) * norm(b))

def l2_distance(a: Vector, b: Vector) -> float:
    # 欧氏距离越小越相似,与前两种“越大越相似”相反。
    return sqrt(sum((x - y) ** 2 for x, y in zip(a, b)))

query = [1.0, 0.0]
documents = {
    "A": [1.0, 0.0],
    "B": [2.0, 0.0],
    "C": [1.0, 1.0],
}

for name, vector in documents.items():
    print(
        name,
        f"cosine={cosine(query, vector):.4f}",
        f"dot={dot(query, vector):.4f}",
        f"l2={l2_distance(query, vector):.4f}",
    )
预期输出
A cosine=1.0000 dot=1.0000 l2=0.0000
B cosine=1.0000 dot=2.0000 l2=1.0000
C cosine=0.7071 dot=1.0000 l2=1.0000
结果表明,余弦认为 A 与 B 同样相似,因为它们方向一致;点积更偏好长度更大的 B;欧氏距离则明确把与查询向量重合的 A 排在最前。选择指标时必须服从模型训练方式,而不是仅凭一次搜索效果决定。
本课总结
- 余弦主要比较方向,点积同时受方向和长度影响,欧氏距离比较绝对位置
- 已归一化嵌入适合余弦或单位向量点积,未归一化向量不能直接使用浮点
dot_product - 不同指标会被转换成不同
_score,跨指标直接比较分数没有意义
下一课预告
下一课将把关键词查询与向量检索组合起来,学习如何构建兼顾精确匹配和语义召回的混合检索。