
NoSQL 与搜索 / 系统课时
自定义分析器
自定义分析器
当内置分析器无法同时满足清洗、切词和规范化规则时,需要把多个分析组件组合成一条可验证的处理链。本课将创建索引级自定义分析器,并用真实请求确认每个阶段的最终效果。
学习目标
- 理解字符过滤器、分词器和词元过滤器的执行顺序
- 在索引设置中定义并绑定自定义分析器
- 使用
_analyze验证配置,并识别上线前的变更边界
分析链由三个阶段组成
自定义分析器按照“字符过滤器 → 分词器 → 词元过滤器”的顺序工作:字符过滤器先修改原始字符流,分词器负责产生词元,词元过滤器再对词元做小写化、停用词删除或字符折叠。字符过滤器和词元过滤器可以有零个或多个,但分词器必须且只能指定一个。:contentReference[oaicite:4]{index=4}
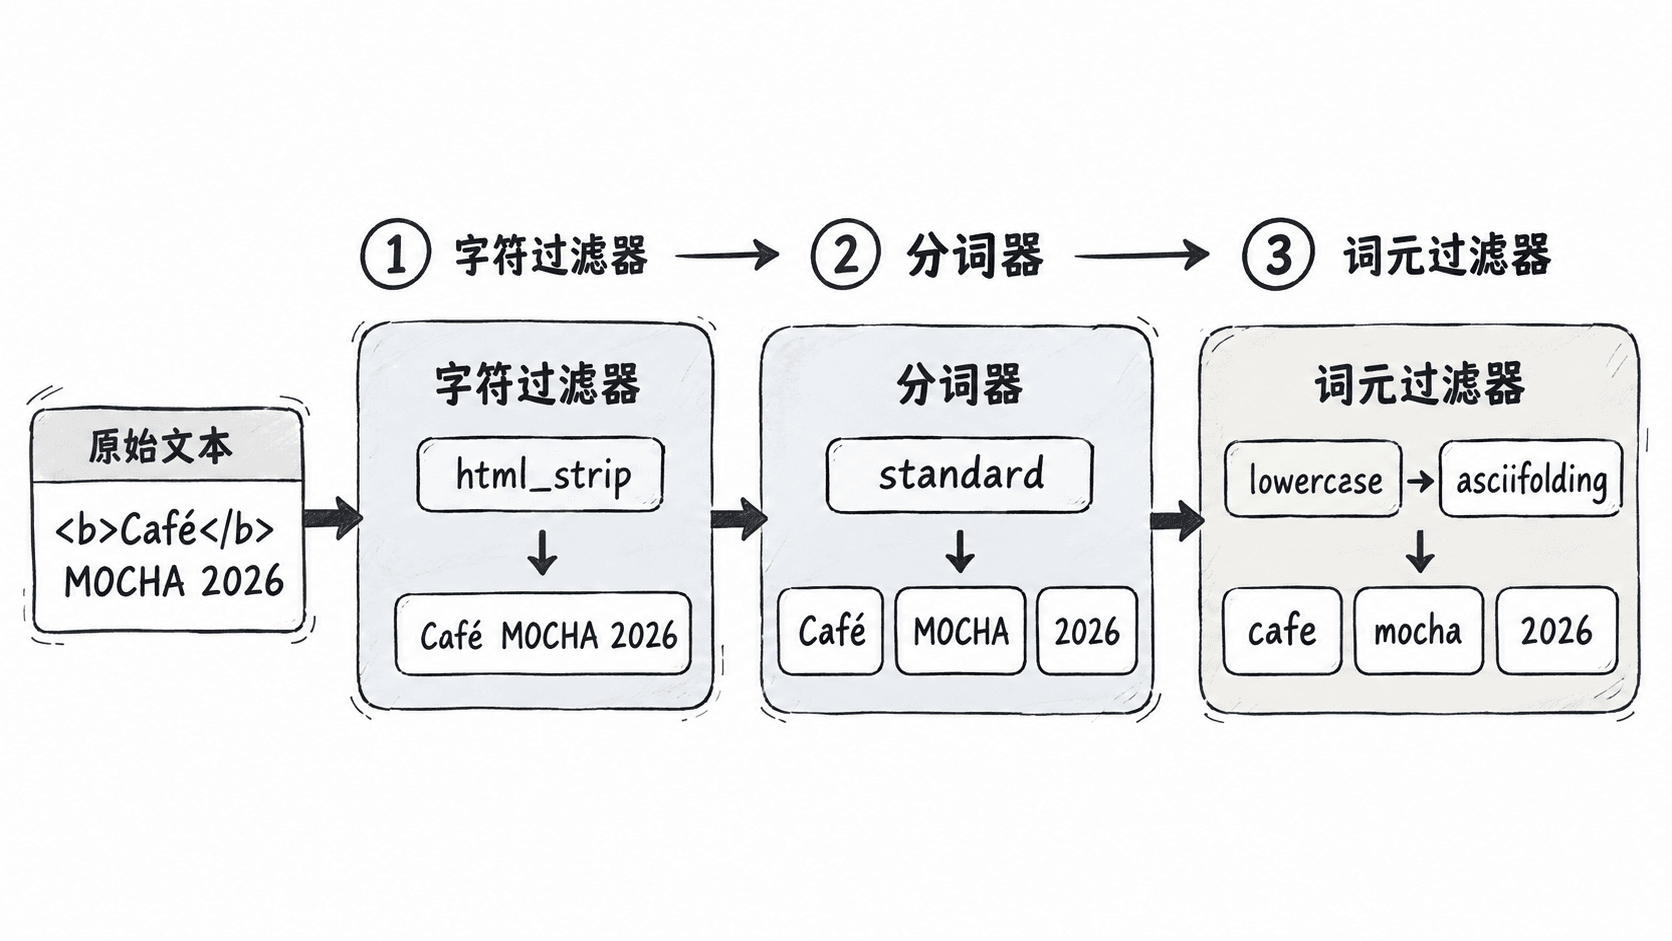
顺序不能随意交换。例如,html_strip 必须在切词前去除标签;lowercase 和 asciifolding 处理的是已经生成的词元。先明确每一步要解决的问题,再选择组件,比不断叠加过滤器更容易维护。
创建并验证分析器
下面在新索引中定义 product_text_analyzer。它先移除 HTML 标签,再使用标准分词器切词,最后统一大小写并把重音字符折叠为基础拉丁字符。分析器绑定到 title 字段后,写入该字段的文本都会按这条链建立倒排索引。
PUT product-search-v1
{
  "settings": {
    "analysis": {
      "analyzer": {
        "product_text_analyzer": {
          "type": "custom",
          "char_filter": [
            "html_strip"
          ],
          "tokenizer": "standard",
          "filter": [
            "lowercase",
            "asciifolding"
          ]
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "title": {
        "type": "text",
        "analyzer": "product_text_analyzer"
      }
    }
  }
}
预期结果:
{
  "acknowledged": true,
  "shards_acknowledged": true,
  "index": "product-search-v1"
}
自定义分析器可以直接引用内置组件,也可以先在 analysis.char_filter、analysis.tokenizer 或 analysis.filter 中定义带参数的组件,再在分析器中按名称组合。:contentReference[oaicite:5]{index=5}
索引创建成功后,应使用索引级 _analyze 请求测试已注册的分析器,而不是在客户端凭经验猜测结果。
POST product-search-v1/_analyze?filter_path=tokens.token
{
  "analyzer": "product_text_analyzer",
  "text": "<b>Café</b> MOCHA 2026"
}
预期输出:
{
  "tokens": [
    {
      "token": "cafe"
    },
    {
      "token": "mocha"
    },
    {
      "token": "2026"
    }
  ]
}
结果说明 HTML 标签未进入词元,大小写已统一,Café 被折叠为 cafe,数字仍被保留。测试时还应加入空字符串、超长文本、混合语言、品牌符号和业务编号,避免只验证一个理想样例。:contentReference[oaicite:6]{index=6}
处理索引变更边界
字段的 analyzer 不能通过更新映射直接改写。若已有字段需要采用新的分析规则,通常应创建带新设置和映射的索引,重新索引数据,再切换别名;直接修改旧字段不会重新分析已经写入的文档。:contentReference[oaicite:7]{index=7}
生产设计还要保持规则可复现。自定义词典、停用词文件和插件版本应纳入发布管理;索引端与搜索端若使用不同分析器,要分别测试召回率、短语查询和精确词命中,确认差异是有意设计而不是配置漂移。
本课总结
- 自定义分析器按字符清洗、切词、词元处理的固定顺序执行
- 配置完成后必须通过索引级
_analyze检查真实词元,而不是只检查 JSON 是否创建成功 - 已有字段更换分析规则通常需要新建索引并重新索引数据
下一课预告
下一课将进入中文分词方案,比较基础切分与专业词典对品牌词、组合词和业务术语召回效果的影响。