
NoSQL 与搜索 / 系统课时
批量写入 Bulk API
批量写入 Bulk API
本课把多次单文档请求合并为一个 Bulk API 调用,重点解决 NDJSON 行式格式、四类操作的配对规则、局部失败检查和批次大小控制。完成后,你可以构造可执行的批量请求,并只重试真正失败的条目。
学习目标
- 正确编写 Bulk API 的 NDJSON 请求体
- 根据
errors、items和单项状态码定位失败操作 - 依据请求体积、耗时和拒绝率调整批次大小与并发度
Bulk 请求为什么采用行式格式
Bulk API 支持 create、index、update 和 delete。请求体不是普通 JSON 数组,而是 NDJSON:每一行都是独立 JSON,操作元数据行后是否需要数据行由操作类型决定。
| 操作 | 下一行内容 | 关键行为 |
|---|---|---|
create |
完整文档 | ID 已存在时失败 |
index |
完整文档 | 不存在则创建,存在则覆盖 |
update |
doc、script 或 upsert 配置 |
局部或脚本更新 |
delete |
无 | 只写操作元数据行 |
文件最后必须保留换行,JSON 也不能格式化成多行。使用 cURL 从文件提交时要用 --data-binary,否则换行可能被改变。
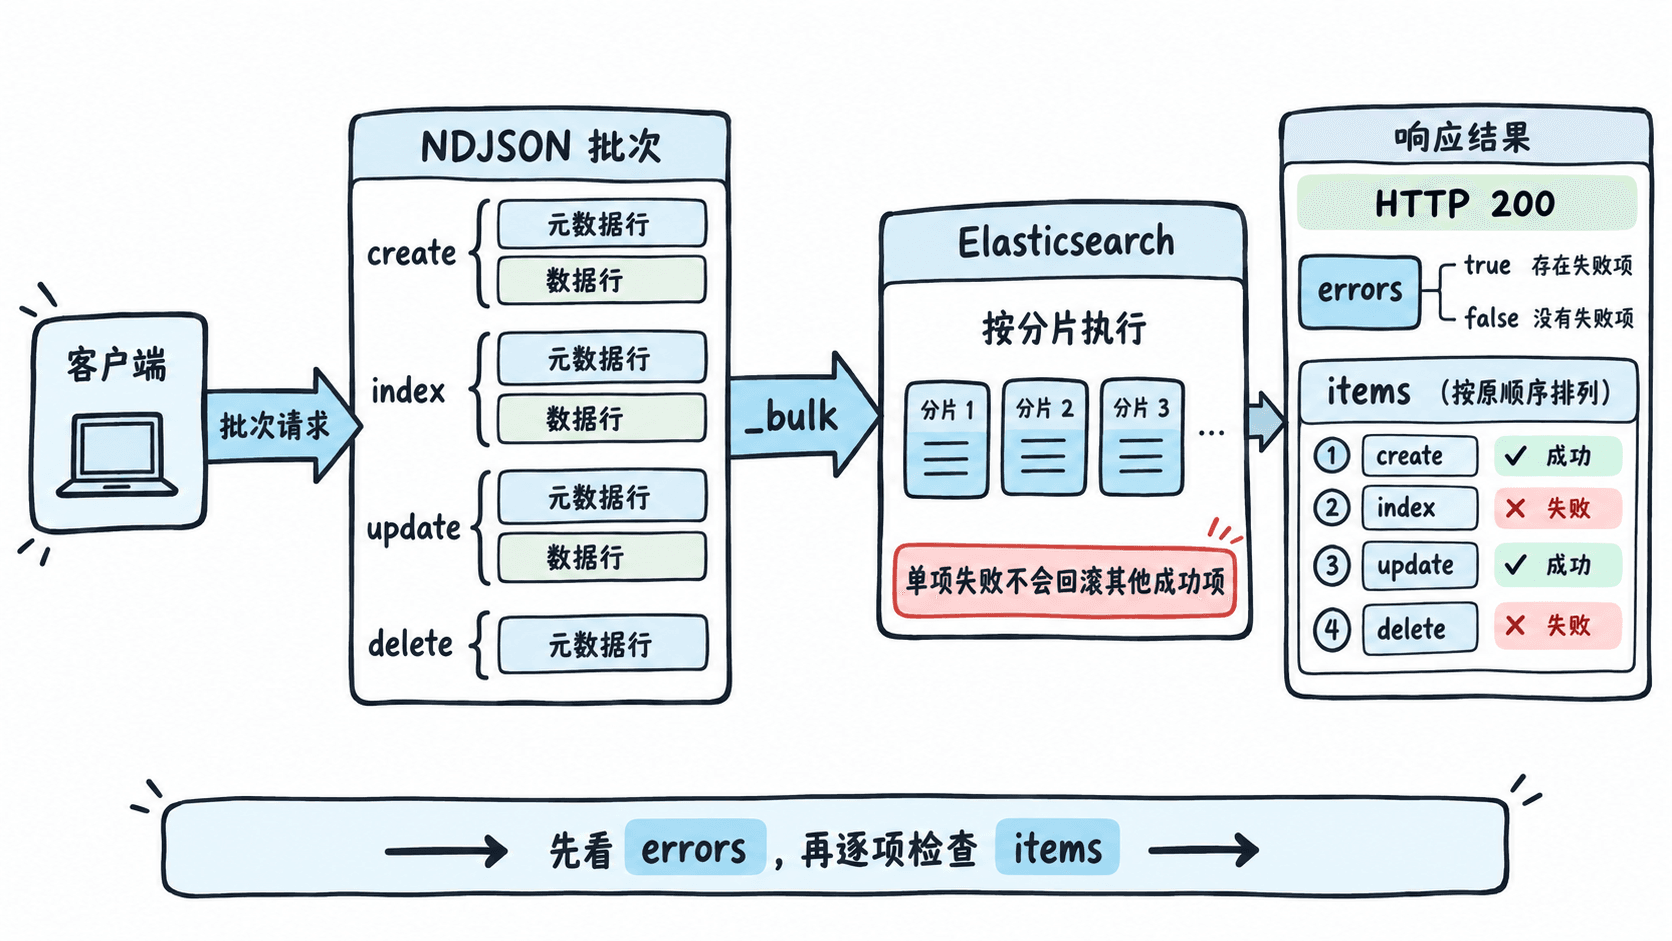
构造并执行一个完整批次
下面示例先准备两条已有文档,再批量执行重复创建、写入、局部更新和删除。第一项会故意触发冲突,用于观察 Bulk API 的局部失败行为。示例会删除测试索引,只应在本地练习环境运行。
curl -s -X DELETE "http://localhost:9200/products" > /dev/null

curl -s -X PUT "http://localhost:9200/products/_doc/sku-100?refresh=wait_for" \
  -H "Content-Type: application/json" \
  -d '{"name":"机械键盘","price":399,"stock":10}' > /dev/null

curl -s -X PUT "http://localhost:9200/products/_doc/sku-300?refresh=wait_for" \
  -H "Content-Type: application/json" \
  -d '{"name":"旧款鼠标","price":99}' > /dev/null

cat > bulk.ndjson <<'NDJSON'
{"create":{"_index":"products","_id":"sku-100"}}
{"name":"重复商品","price":1}
{"index":{"_index":"products","_id":"sku-200"}}
{"name":"人体工学鼠标","price":259,"stock":20}
{"update":{"_index":"products","_id":"sku-100"}}
{"doc":{"price":369}}
{"delete":{"_index":"products","_id":"sku-300"}}
NDJSON

curl -s -w '\nHTTP_STATUS:%{http_code}\n' \
  -X POST "http://localhost:9200/_bulk?refresh=wait_for" \
  -H "Content-Type: application/x-ndjson" \
  --data-binary "@bulk.ndjson"
预期输出
{
  "took": <MILLISECONDS>,
  "errors": true,
  "items": [
    {
      "create": {
        "_index": "products",
        "_id": "sku-100",
        "status": 409,
        "error": {
          "type": "version_conflict_engine_exception",
          "reason": "<REASON>"
        }
      }
    },
    {
      "index": {
        "_index": "products",
        "_id": "sku-200",
        "status": 201,
        "result": "created"
      }
    },
    {
      "update": {
        "_index": "products",
        "_id": "sku-100",
        "status": 200,
        "result": "updated"
      }
    },
    {
      "delete": {
        "_index": "products",
        "_id": "sku-300",
        "status": 200,
        "result": "deleted"
      }
    }
  ]
}
HTTP_STATUS:200响应中的版本号、分片信息等字段可能因版本和集群配置而额外出现。took 与错误原因是动态值,因此使用占位符表示。最重要的现象是:整体 HTTP 状态为 200,但顶层 errors 为 true,同时其余三项仍然成功。
正确检查并重试失败项
不能只检查 Bulk 请求的 HTTP 状态码。先判断顶层 errors,再按请求顺序遍历 items;单项 status 为 2xx 才算成功,存在 error 时应记录对应操作、文档 ID、错误类型和原因。
重试时只重新组装失败项,不要重复整个批次。重复提交成功过的 index 可能再次覆盖文档,重复执行非幂等脚本可能造成计数翻倍。对 429 或临时节点异常可采用指数退避;对 400 映射错误、409 创建冲突等确定性问题,应修复数据或操作语义后再提交。
生产程序还应保存“请求条目与响应条目”的位置对应关系。Bulk 响应会按提交顺序返回结果,这使程序可以从原批次中精确提取失败操作并进入重试队列。
控制批次大小与吞吐
Bulk 没有适用于所有场景的固定条数。文档大小差异很大,因此应同时观察请求字节数、单批耗时、节点堆内存、写入线程池拒绝和 429 比例,而不是只设置“每批 1000 条”。
从较小批次开始压测,逐步增加体积,吞吐不再提升或拒绝率上升时回退。单个 HTTP 请求不能超过集群的 http.max_content_length,默认上限通常为 100 MB;实际批次应明显低于上限,为请求头、并发波动和异常文档留出余量。
并发批次数也要独立控制。单批过大增加内存峰值和失败重试成本,并发过高则可能压满写入线程池。稳定方案通常是“有界队列、有限并发、失败项退避重试、持续记录批次指标”。
本课总结
- Bulk 请求使用 NDJSON,操作元数据行与数据行必须按类型正确配对,文件末尾保留换行
- HTTP 200 不代表全部成功,必须检查
errors并逐项读取items - 批次大小和并发度应通过压测确定,失败时只重试对应条目
下一课预告
下一课将继续学习索引管理操作,把文档写入流程与索引别名、生命周期或重建策略连接起来。