
NoSQL 与搜索 / 系统课时
容量与分片规划
容量与分片规划
容量规划要把业务增长转换为可验证的磁盘、节点和分片参数。本课以日志索引为例,从每日新增量、保留周期、查询并发和副本数出发,得到首版集群配置,并说明如何用真实数据持续校准。
学习目标
- 估算保留期内的主数据量、总磁盘需求与单节点容量
- 根据目标分片大小计算主分片和副本数量
- 使用 Elasticsearch API 验证分片分布并识别过度分片
先确定规划输入
不要直接用源文件大小推算集群容量。应先导入一批有代表性的数据,再读取主分片实际占用,因为字段映射、_source、倒排索引和压缩都会改变最终大小。
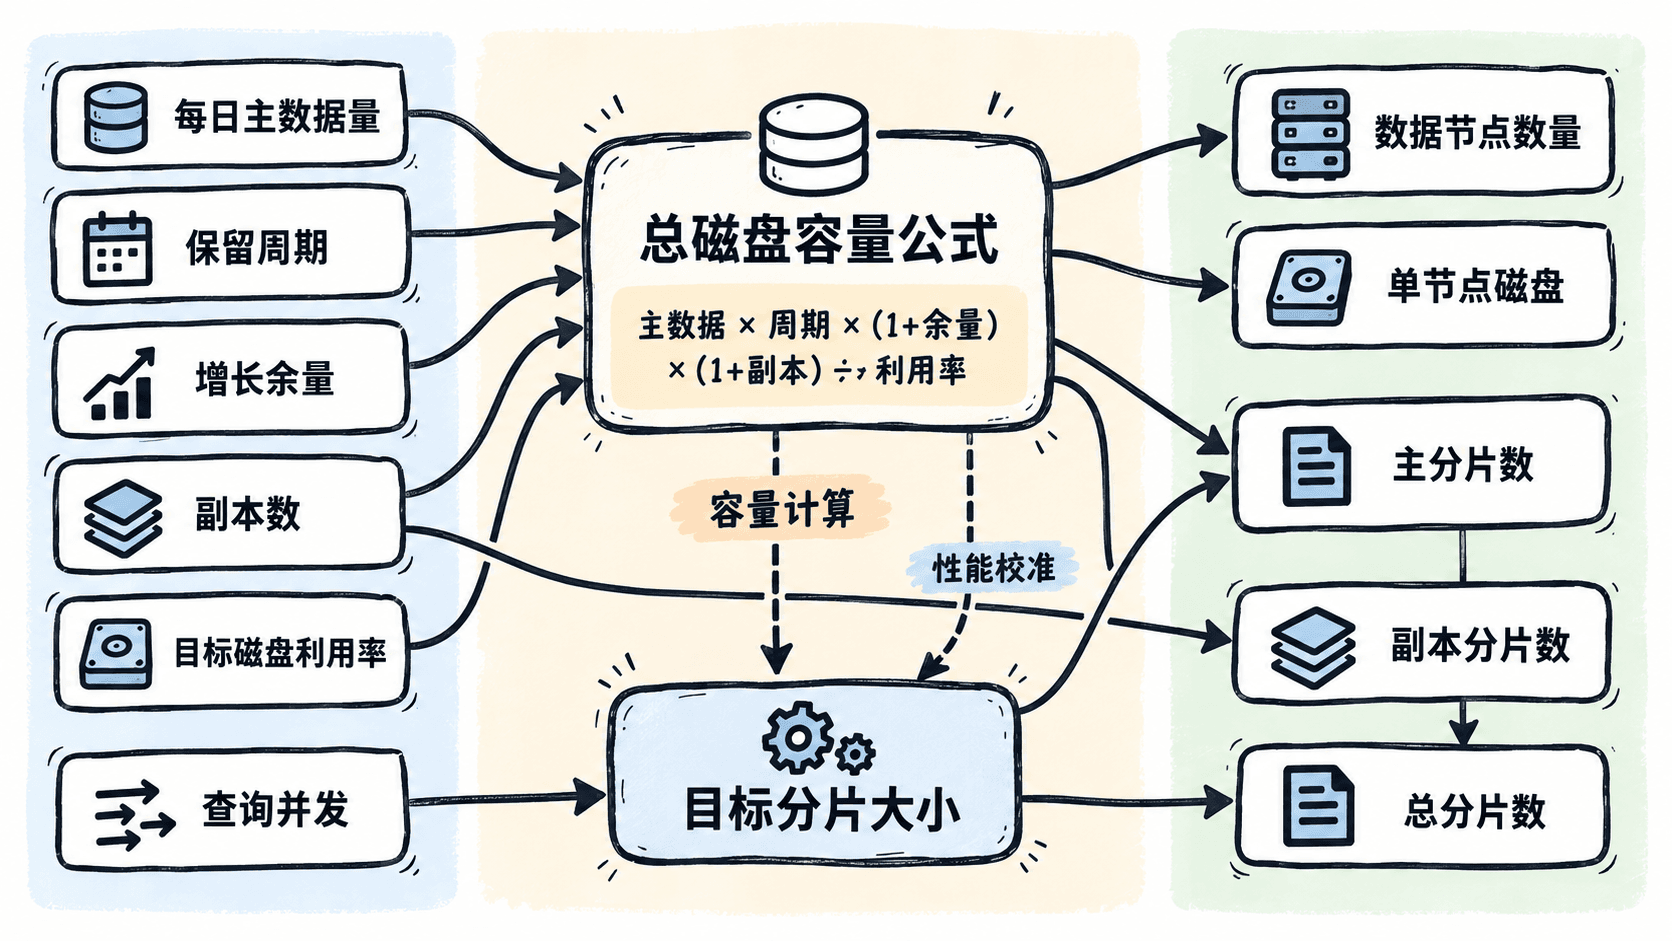
规划至少需要五个输入:每日主数据增量 D、保留天数 R、增长余量 G、副本数 N 和目标磁盘利用率 U。查询并发、聚合复杂度和写入峰值则用于决定 CPU、内存及节点数量,不能只按磁盘容量选机器。
估算磁盘与节点容量
可用下面的估算式计算数据节点所需的可用磁盘:
假设实测每日主数据为 120 GB,保留 30 天,预留 30% 增长空间,配置 1 个副本,并把长期磁盘利用率控制在 70%,则总磁盘约为 120 × 30 × 1.3 × 2 ÷ 0.7 ≈ 13.37 TB。若使用 6 个数据节点,平均每个节点至少需要约 2.23 TB 可用容量,还要结合故障迁移、段合并和临时写入峰值留出余量。
计算主分片数量
单个索引的主分片数可按“预计主数据量 ÷ 目标分片大小”向上取整。Elastic 当前建议把 10~50 GB 和每分片少于 2 亿文档作为常见起点,但最终值应使用生产数据、生产硬件和真实查询压测确定。过多小分片会增加集群状态、搜索协调和资源开销,过大分片则会延长恢复时间。:contentReference[oaicite:0]{index=0}
以上例每天 120 GB、目标每个主分片约 30 GB 计算,每日索引可先设置 4 个主分片。1 个副本会产生 4 个副本分片,因此每个日索引共有 8 个分片副本。主分片数量创建后不能直接修改,调整既有索引通常需要拆分、收缩或重建索引。
下面在至少两个可分配数据节点的测试集群中创建索引:
PUT logs-app-000001
{
  "settings": {
    "number_of_shards": 4,
    "number_of_replicas": 1
  }
}
预期结果:
{
  "acknowledged": true,
  "shards_acknowledged": true,
  "index": "logs-app-000001"
}
验证实际分片分布
创建后不要只看索引是否存在,还要检查主分片、复制分片、文档数、存储量和所在节点。实际的文档数、存储量和节点名会随环境变化,因此以下输出使用占位符表示。
GET _cat/shards/logs-app-000001?v&h=index,shard,prirep,docs,store,node&s=shard,prirep预期输出:
index               shard prirep docs   store  node
logs-app-000001     0     p      <DOCS> <SIZE> <NODE_A>
logs-app-000001     0     r      <DOCS> <SIZE> <NODE_B>
logs-app-000001     1     p      <DOCS> <SIZE> <NODE_B>
logs-app-000001     1     r      <DOCS> <SIZE> <NODE_A>
logs-app-000001     2     p      <DOCS> <SIZE> <NODE_A>
logs-app-000001     2     r      <DOCS> <SIZE> <NODE_B>
logs-app-000001     3     p      <DOCS> <SIZE> <NODE_B>
logs-app-000001     3     r      <DOCS> <SIZE> <NODE_A>
持续观察实际主分片大小。如果流量波动明显,固定按天建索引可能产生大量小分片,更适合使用数据流和滚动条件,让索引按主分片大小、文档数或时间切换。容量方案上线前还应执行写入与查询混合压测,因为最合适的配置必须由真实负载验证。:contentReference[oaicite:1]{index=1}
常见规划错误
只按当前数据量采购会忽略增长、副本和故障恢复空间;只追求更多分片会让查询扇出和集群管理成本上升;只看平均并发会漏掉报表聚合、批量写入和节点离线时的峰值。首版规划应保守可扩展,并用监控数据定期修正。
本课总结
- 容量估算必须基于实际索引后的主数据大小,并同时计入保留期、增长、副本和磁盘余量
- 主分片数应从目标分片大小反推,再通过真实写入与查询压测校准
- 分片过多和分片过大都会影响稳定性,应持续检查分片大小、数量和节点分布
下一课预告
下一课将使用组件模板和索引模板,把本课确定的分片、映射与别名规则自动应用到新索引。