
NoSQL 与搜索 / 系统课时
文本分析执行流程
文本分析执行流程
文本能否被 Elasticsearch 正确检索,取决于写入和查询时如何被拆成词元。本课将串联字符过滤器、分词器与词元过滤器的执行顺序,并用一个可验证的分析器示例说明它们怎样改变最终匹配结果。
学习目标
- 说明字符过滤器、分词器和词元过滤器的职责与顺序
- 读懂词元、位置和偏移量等分析结果
- 判断索引分析与查询分析不一致造成的匹配问题
文本分析的本质
Elasticsearch 不会直接把一整段文本原样用于全文检索。text 字段在写入倒排索引前,会先经过分析器,将原始字符串转换为一组标准化词元。查询字符串在执行 match 等全文查询时,也会经过分析,再用得到的词元去查倒排索引。
分析器由三个阶段组成:字符过滤器先修改原始字符流,分词器再决定从哪里切分词元,词元过滤器最后对词元做小写化、停用词删除、同义词扩展等处理。其中分词器必须且只能有一个,另外两个阶段可以没有,也可以配置多个。
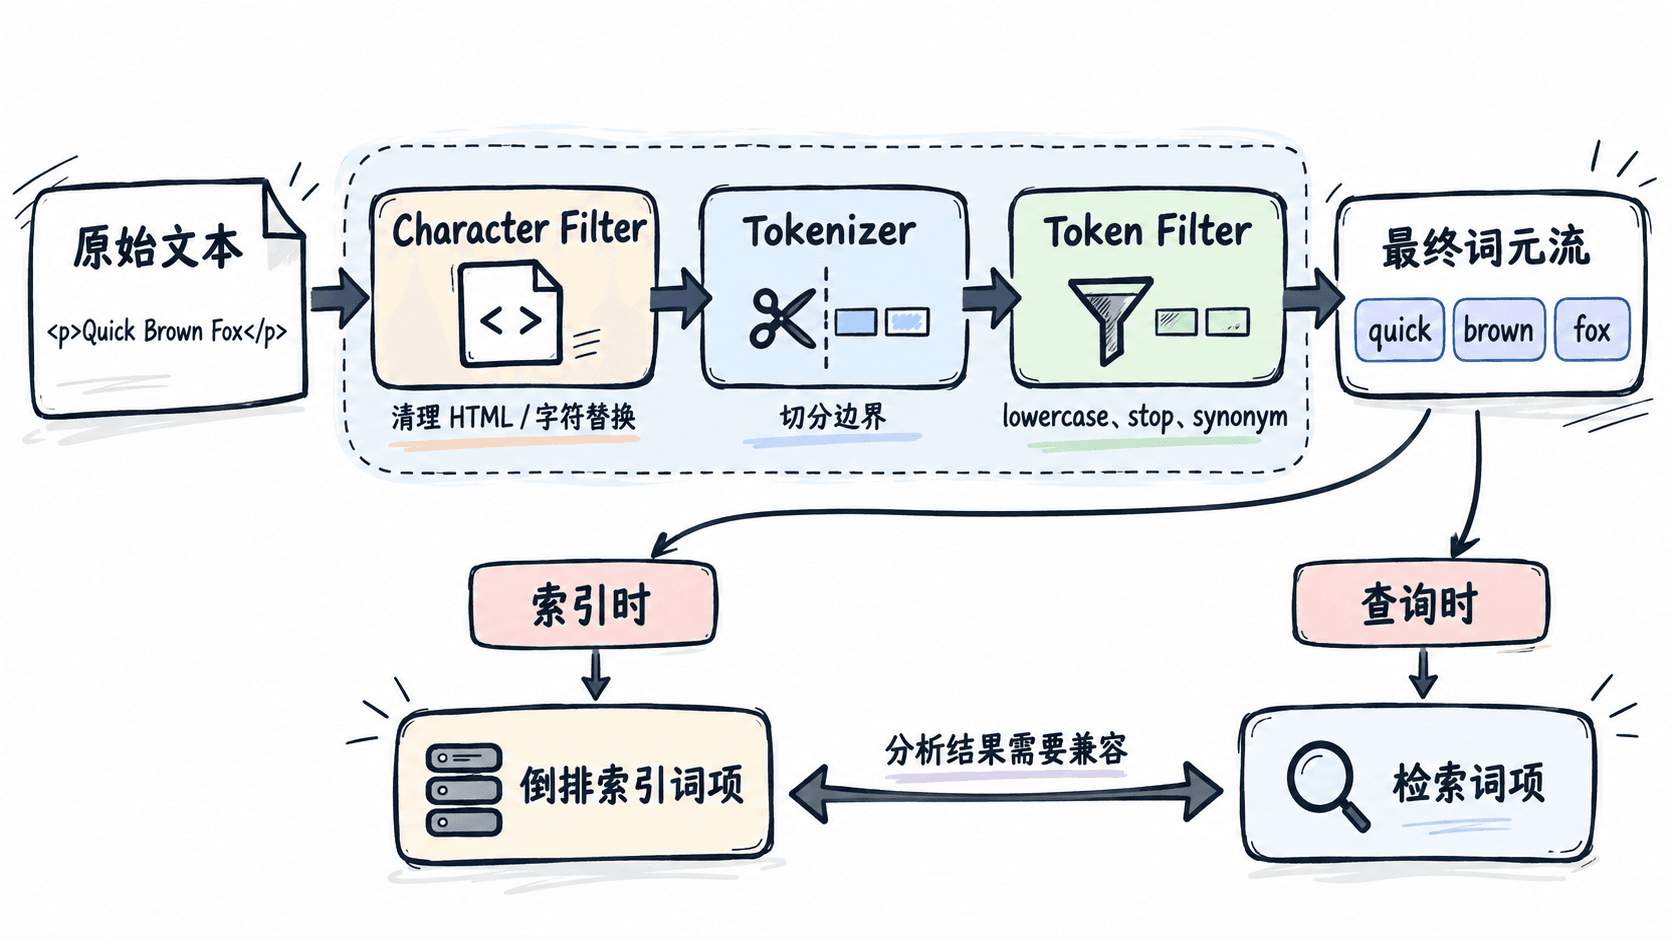
三个阶段如何协作
字符过滤器处理的是分词前的字符。例如把 & 替换为“和”,或删除 HTML 标签。它可能改变文本长度,因此 Elasticsearch 会记录偏移量修正,保证高亮等功能尽量对应原文位置。
分词器接收字符过滤后的文本并生成初始词元。standard 分词器适合多数西文内容,会依据 Unicode 文本边界切分;对中文句子,它通常不能提供符合业务语义的词语切分,因此中文检索往往需要专门的中文分词插件。
词元过滤器按配置顺序逐个执行。lowercase 会统一大小写,stop 会移除停用词,synonym 可扩展同义表达。顺序不可随意交换,例如先做小写化再匹配小写同义词规则,通常比反过来更稳定。
用 Analyze API 验证流程
下面的请求定义一个临时分析器:先把连字符替换为空格,再按标准规则切分,最后统一转为小写。可在 Kibana Dev Tools 中直接执行。
POST /_analyze
{
  "char_filter": [
    {
      "type": "mapping",
      "mappings": [
        "- => "
      ]
    }
  ],
  "tokenizer": "standard",
  "filter": [
    "lowercase"
  ],
  "text": "Quick-Search API"
}
预期结果会得到三个词元,实际响应中的偏移量字段可能随版本细节略有差异,但词元顺序应保持一致。
quick
search
api
这个结果说明:字符过滤器先把 Quick-Search 变成可切分的两部分,分词器生成三个初始词元,词元过滤器再把 Quick、Search 和 API 转为小写。
分析结果如何影响搜索
索引时分析决定倒排索引中真正保存哪些词项,查询时分析决定用户输入会变成哪些检索词项。两者不必完全使用同一个分析器,但结果必须能够匹配。例如索引中保存的是 quick,查询端却保留为 Quick,大小写敏感的词项比较就可能失败。
字段映射中的 analyzer 用于索引阶段,也默认用于查询阶段;search_analyzer 可以单独覆盖查询阶段。常见做法是索引阶段使用较细的切分提高召回,查询阶段使用较保守的切分减少无关匹配。
对于 term 查询要特别注意:它属于词项级查询,不会分析输入文本。若字段写入后保存的是小写词元,直接用大写字符串执行 term 查询通常不会命中;需要改用与字段语义一致的值,或使用会经过分析的 match 查询。
常见配置错误
第一类错误是只检查原文,不检查最终词元。原文看起来包含关键词,不代表分析后仍保留该词,停用词、同义词或字符替换都可能改变结果。
第二类错误是修改分析器后期待旧数据自动生效。分析器只在文档写入时生成词项,已有文档不会被重新分析,通常需要新建索引并执行重建索引。
第三类错误是索引和查询使用互不兼容的分词策略。排查时应分别用 Analyze API 模拟索引分析器与查询分析器,再比较两边词元是否存在交集。
本课总结
- 文本分析固定按字符过滤器、分词器、词元过滤器的顺序执行
- 索引与查询最终比较的是分析后的词元,而不是原始字符串
- 分析器变更不会自动重写旧索引,验证后通常需要重建数据
下一课预告
下一课将专门使用 Analyze API 查看词元、位置、偏移量和词元类型,并据此定位文本未按预期匹配的原因。