
NoSQL 与搜索 / 系统课时
嵌套与多级聚合
嵌套与多级聚合
多级聚合用于按“分类—子对象—属性”逐层统计;当数组中的对象必须保持字段关联时,还要进入 nested 作用域。本课用商品规格数据完成分类、颜色、均价、库存与商品数的联合分析。
学习目标
- 理解父桶、子桶和指标聚合的执行关系
- 使用
nested与reverse_nested切换统计作用域 - 读懂嵌套文档数与根文档数的差异
多级聚合如何逐层收窄数据
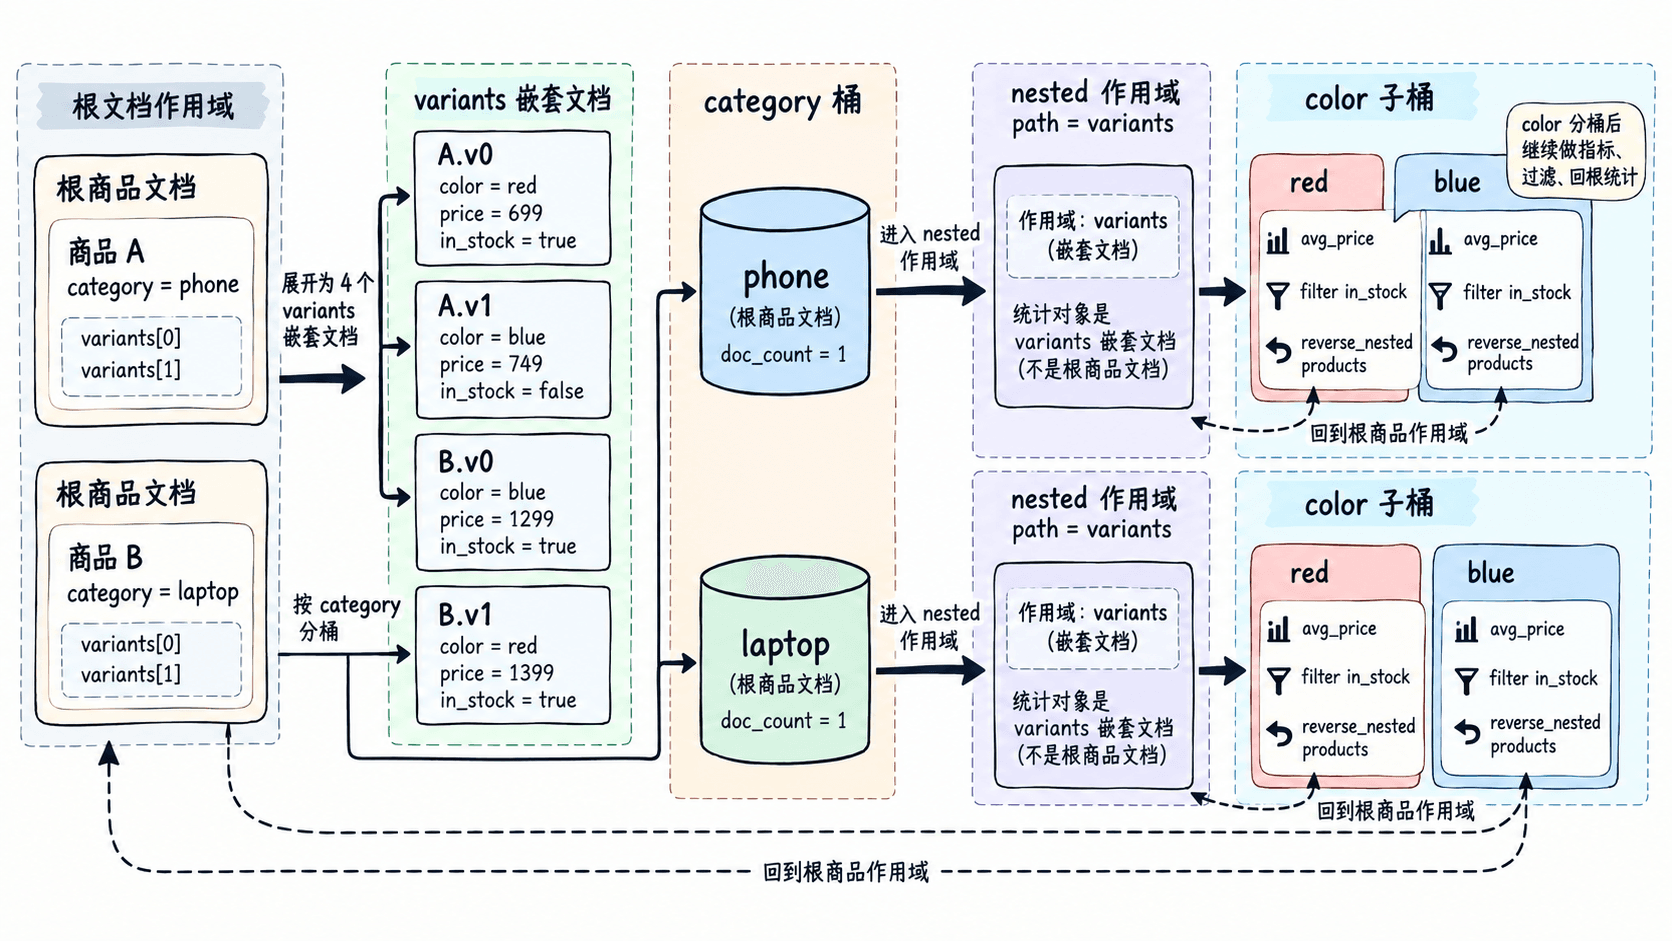
多级聚合不是一次把所有字段分组,而是先由外层桶选出一批文档,再在该批文档内执行子聚合。例如先按商品分类分桶,再进入每个分类中的 variants 嵌套对象,最后按颜色分桶并计算均价。
nested 字段中的每个对象会作为独立的隐藏文档保存。这样可以保证同一个规格对象里的颜色、价格和库存保持对应,避免普通对象数组在倒排索引中发生字段串配。
准备嵌套字段与样例数据
下面的命令创建 products 索引,并写入两个手机商品。请把 <PORT> 替换为 Elasticsearch 实际端口,默认安装通常使用 9200。
# 创建包含 nested 规格数组的索引
curl -s -X PUT "http://localhost:<PORT>/products" \
  -H 'Content-Type: application/json' \
  -d '{
    "mappings": {
      "properties": {
        "category": { "type": "keyword" },
        "brand": { "type": "keyword" },
        "variants": {
          "type": "nested",
          "properties": {
            "color": { "type": "keyword" },
            "price": { "type": "double" },
            "stock": { "type": "integer" }
          }
        }
      }
    }
  }'

# 写入两个根文档,每个根文档包含两个规格对象
curl -s -X PUT "http://localhost:<PORT>/products/_doc/1" \
  -H 'Content-Type: application/json' \
  -d '{
    "category": "phone",
    "brand": "acme",
    "variants": [
      { "color": "red", "price": 699, "stock": 8 },
      { "color": "black", "price": 729, "stock": 0 }
    ]
  }'

curl -s -X PUT "http://localhost:<PORT>/products/_doc/2?refresh=true" \
  -H 'Content-Type: application/json' \
  -d '{
    "category": "phone",
    "brand": "nova",
    "variants": [
      { "color": "red", "price": 799, "stock": 3 },
      { "color": "blue", "price": 819, "stock": 4 }
    ]
  }'
预期结果
索引 products 创建成功,文档 1 和文档 2 的 result 均为 created。
实际响应还会包含分片、版本号和序列号等动态字段。
组合分类桶、嵌套桶与指标
外层 by_category 处理根文档;variants_scope 通过 nested.path 进入规格对象;by_color 再按颜色分桶。avg_price 统计当前颜色的规格均价,in_stock 统计库存大于零的规格数,products 则返回根商品作用域。
curl -s -X POST "http://localhost:<PORT>/products/_search" \
  -H 'Content-Type: application/json' \
  -d '{
    "size": 0,
    "aggs": {
      "by_category": {
        "terms": { "field": "category" },
        "aggs": {
          "variants_scope": {
            "nested": { "path": "variants" },
            "aggs": {
              "by_color": {
                "terms": { "field": "variants.color" },
                "aggs": {
                  "avg_price": {
                    "avg": { "field": "variants.price" }
                  },
                  "in_stock": {
                    "filter": {
                      "range": { "variants.stock": { "gt": 0 } }
                    }
                  },
                  "products": {
                    "reverse_nested": {}
                  }
                }
              }
            }
          }
        }
      }
    }
  }'
预期输出的关键聚合片段如下,响应中的 took、分片统计等动态值可能不同。
{
  "aggregations": {
    "by_category": {
      "buckets": [
        {
          "key": "phone",
          "doc_count": 2,
          "variants_scope": {
            "doc_count": 4,
            "by_color": {
              "buckets": [
                {
                  "key": "red",
                  "doc_count": 2,
                  "avg_price": { "value": 749.0 },
                  "in_stock": { "doc_count": 2 },
                  "products": { "doc_count": 2 }
                }
              ]
            }
          }
        }
      ]
    }
  }
}
读懂计数与常见边界
by_category.doc_count 是根商品数量,因此为 2;variants_scope.doc_count 是进入嵌套作用域后的规格数量,因此为 4。颜色桶中的 doc_count 仍表示规格数,而 reverse_nested 返回的 products.doc_count 才表示包含该颜色的根商品数。
查询嵌套属性时,筛选条件也应放在同一个 nested 路径下。若把 variants.color 与 variants.stock 当作普通对象字段统计,颜色与库存可能来自不同数组元素,结果看似合理却失去业务含义。
多级桶越深,桶数量增长越快。生产查询应限制 terms.size,尽量先用查询条件缩小文档范围,并关注集群的最大桶数量限制,避免一次请求创建过多桶。
本课总结
- 多级聚合按父桶到子桶逐层收窄统计范围
nested统计嵌套对象,reverse_nested返回根文档作用域- 嵌套桶的
doc_count与根文档数量不是同一概念
下一课预告
下一课将使用管道聚合读取已有桶和指标的结果,继续计算环比变化、利润率与移动平均值。