
NoSQL 与搜索 / 系统课时
快照备份与恢复
快照备份与恢复
本课将完成一套可执行的 Elasticsearch 备份恢复流程:注册共享文件系统仓库,验证所有节点均可访问,创建一致性快照,再把索引以新名称恢复并核对结果,避免直接覆盖生产数据。
学习目标
- 配置并验证共享快照仓库
- 创建快照并确认备份成功
- 以隔离方式恢复索引并制定生产切换步骤
快照链路与安全边界
快照由 Elasticsearch 协调各分片写入仓库,不等同于复制节点数据目录。仓库必须位于集群之外的可靠存储中,并且不能由人工脚本直接修改其内部文件;同一个仓库也不应被多个集群同时写入,否则可能破坏仓库元数据。
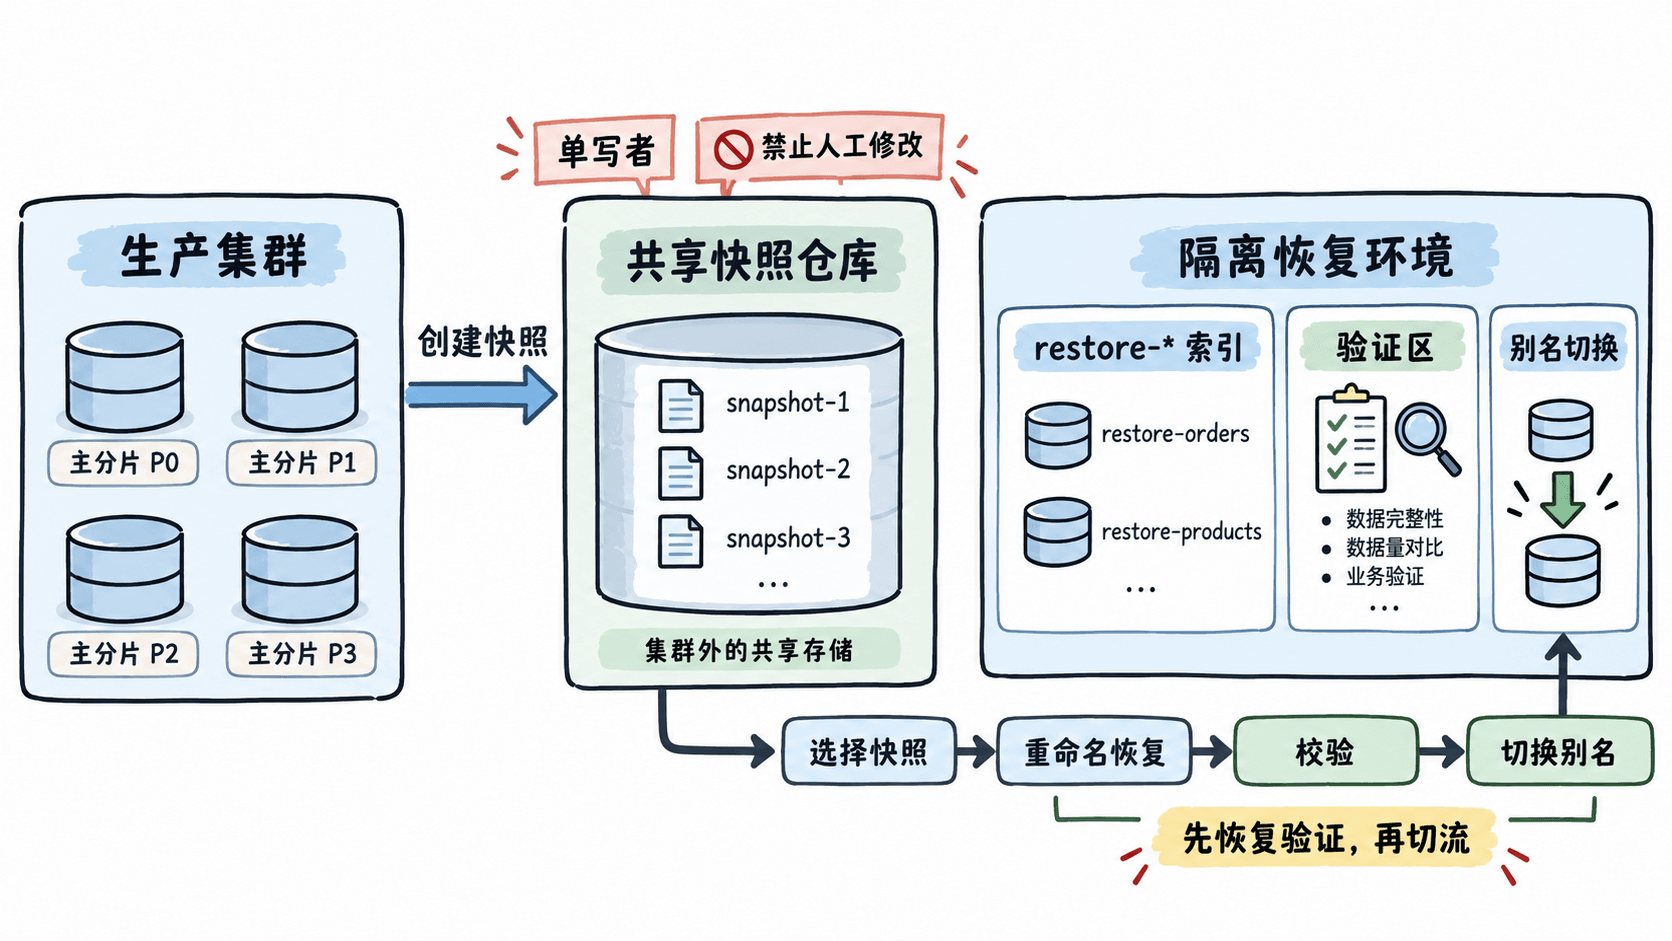
快照支持增量存储:后续快照会复用仓库中已有且未变化的数据块,但每个快照在逻辑上仍可独立恢复。删除旧快照应通过 Elasticsearch API 完成,让系统正确维护共享数据块的引用关系。
配置共享文件系统仓库
在所有主节点和数据节点的 elasticsearch.yml 中加入同一个仓库根目录。该目录必须真实挂载、权限一致,并能被运行 Elasticsearch 的系统用户读写。修改后逐节点重启,再继续注册仓库。
path.repo:
  - /mnt/es-backup
生效行为与验证方法:节点重启后,节点设置中应包含该路径;若任一相关节点未挂载目录或权限不足,注册或验证仓库时会返回节点访问错误。
在 Kibana Dev Tools 中注册仓库。location 必须位于 path.repo 允许的目录之内。
PUT _snapshot/prod-fs-repo
{
  "type": "fs",
  "settings": {
    "location": "/mnt/es-backup/prod",
    "compress": true
  }
}
预期结果:
{
  "acknowledged": true
}
注册成功后再执行显式验证,确认集群节点可以在仓库中创建、读取并清理测试文件。
POST _snapshot/prod-fs-repo/_verify预期结果:
{
  "nodes": {
    "<ID>": {
      "name": "<NODE_NAME>"
    }
  }
}
实际节点 ID 和名称会不同。结果应覆盖需要访问仓库的集群节点;若验证失败,优先检查挂载路径、目录所有者、容器卷映射、网络文件系统权限和各节点配置是否一致。
创建并检查快照
下面只备份 logs-app-* 索引,不包含全局集群状态。执行前把 <DATE> 替换为实际日期,例如 2026.08.03。wait_for_completion=true 便于演练时直接获得最终状态,生产大规模快照可异步执行后再查询状态。
PUT _snapshot/prod-fs-repo/logs-<DATE>?wait_for_completion=true
{
  "indices": "logs-app-*",
  "ignore_unavailable": false,
  "include_global_state": false
}
预期结果的关键字段:
{
  "snapshot": {
    "snapshot": "logs-<DATE>",
    "state": "SUCCESS"
  }
}
只有 state 为 SUCCESS 且失败分片数为 0,才能把本次任务记为成功。若返回 PARTIAL 或失败,应先处理不可用主分片、仓库超时或权限问题,再重新创建新快照,不要只依据 HTTP 请求已提交就判定备份完成。
隔离恢复与结果验证
恢复时不要直接使用原索引名。通过 rename_pattern 和 rename_replacement 生成 restore- 前缀,可以与线上索引并存,先验证文档、映射和查询结果,再决定是否切换别名。
POST _snapshot/prod-fs-repo/logs-<DATE>/_restore
{
  "indices": "logs-app-*",
  "include_global_state": false,
  "rename_pattern": "(.+)",
  "rename_replacement": "restore-$1",
  "index_settings": {
    "index.number_of_replicas": 0
  }
}
预期结果:
{
  "accepted": true
}
accepted: true 只表示恢复任务已被接受,不代表所有分片已经恢复完成。继续检查恢复索引的健康状态和文档数;下面命令中的 <COUNT> 会随实际数据变化。
GET _cluster/health/restore-logs-app-*?wait_for_status=yellow&timeout=60s
GET restore-logs-app-*/_count
预期结果应满足:
恢复索引状态至少达到 yellow,且 timed_out 为 false。
count = <COUNT>,应与备份时记录的源索引基线一致。
验证还应覆盖关键映射、别名、抽样文档和应用查询。将副本数临时设为 0 只是为了加快隔离恢复;正式接管流量前,应恢复生产副本配置并等待集群达到预期健康状态。
生产恢复流程
生产恢复应按固定顺序执行,避免“恢复成功但业务不可用”:
- 冻结相关写入,记录故障时间、目标 RPO、源索引文档数和当前别名。
- 选择故障前最近的成功快照,先验证仓库可用性,再用新名称恢复。
- 检查分片健康、文档数、映射、抽样查询和应用级读写验证。
- 恢复副本数,等待分片分配完成,再通过别名或网关配置切换读流量。
- 观察错误率与查询延迟,确认稳定后再恢复写入,并保留原索引用于回退。
- 记录实际恢复时间,更新 RTO、RPO 和操作手册,定期在非生产集群复演。
常见失败包括目标索引同名且仍处于打开状态、目标集群版本不支持该快照或其中的旧索引、恢复全局状态误覆盖模板与策略,以及多个集群同时写入同一仓库。生产操作前应逐项核对,而不是在故障现场临时决定。
本课总结
- 快照必须由 Elasticsearch API 管理,不能把复制数据目录或手工修改仓库当作备份方案
- 仓库验证和快照
SUCCESS状态是备份验收的最低条件 - 生产恢复应采用重命名隔离、数据核对、别名切换和可回退观察,而不是直接覆盖原索引
下一课预告
下一课将继续围绕集群治理,学习如何把生命周期策略、快照计划和恢复演练纳入日常巡检与容量管理。