
NoSQL 与搜索 / 系统课时
索引生命周期管理
索引生命周期管理
本课将把持续增长的日志索引交给 ILM 自动管理:达到年龄或分片大小阈值后滚动新索引,旧索引迁移到低成本数据层,并在保留期结束后删除,最终形成可验证、可排错的生命周期策略。
学习目标
- 理解滚动、迁移和删除之间的执行关系
- 创建 ILM 策略并通过索引模板绑定到数据流
- 使用 Explain API 验证阶段状态并定位卡住原因
生命周期如何推进
ILM 不是按固定日期创建索引,而是持续检查索引是否满足阶段条件。写入索引先处于 hot 阶段;达到 max_age 或 max_primary_shard_size 后执行 rollover,数据流生成新的写入索引,旧索引再按 min_age 进入 warm、cold 或 delete 阶段。
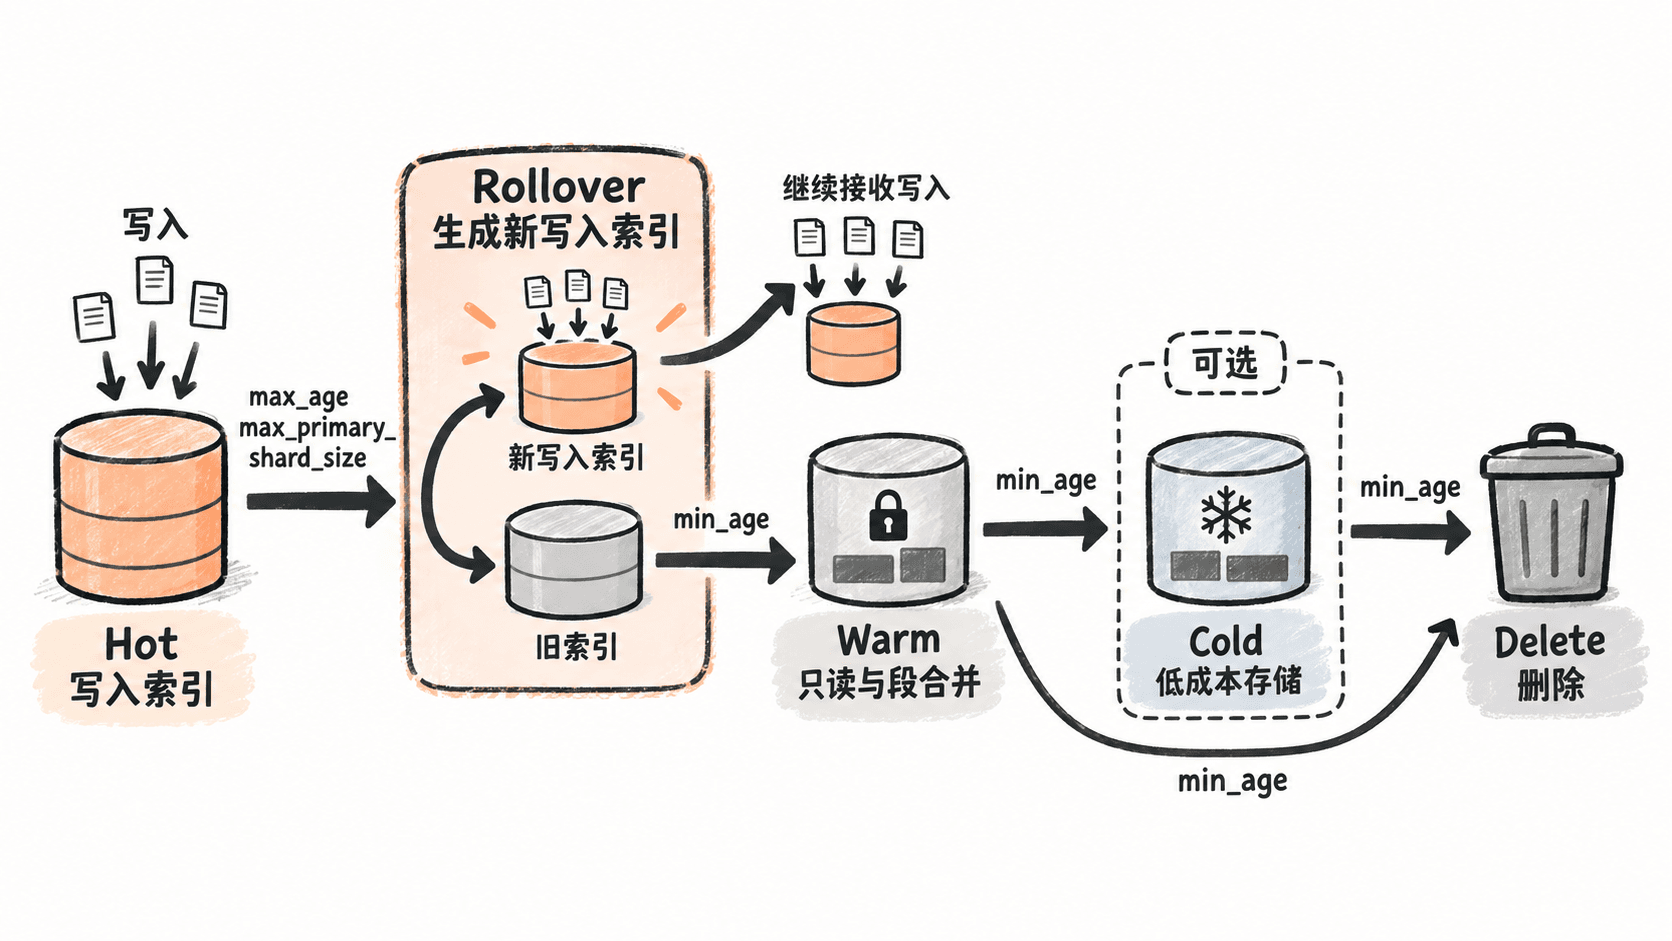
阶段年龄有一个常见边界:发生 rollover 后,后续阶段的 min_age 通常从滚动时间计算,而不是从索引最初创建时间计算。因此“7 天滚动、30 天删除”表示旧索引在滚动后继续保留到删除阈值,而不是简单按自然日文件名判断。
创建 ILM 策略
下面的策略在主分片达到 50 GB 或写入满 7 天时滚动;滚动 7 天后迁移到 warm 数据层并合并为一个段;滚动 30 天后删除。请在 Kibana Dev Tools 中执行。
PUT _ilm/policy/logs-retention-policy
{
  "policy": {
    "phases": {
      "hot": {
        "actions": {
          "rollover": {
            "max_primary_shard_size": "50gb",
            "max_age": "7d"
          }
        }
      },
      "warm": {
        "min_age": "7d",
        "actions": {
          "migrate": {
            "enabled": true
          },
          "forcemerge": {
            "max_num_segments": 1
          }
        }
      },
      "delete": {
        "min_age": "30d",
        "actions": {
          "delete": {}
        }
      }
    }
  }
}
预期结果:
{
  "acknowledged": true
}
migrate 依赖集群中存在承担 data_warm 角色的节点。若只有 hot 节点,应先规划数据层,或暂时删除 warm 阶段,避免索引长期停在迁移步骤。forcemerge 会消耗 I/O 和 CPU,应在写入低峰执行,并避免对大量索引同时触发。
通过模板绑定数据流
策略本身不会自动接管所有索引。需要在可组合索引模板中写入 index.lifecycle.name,并让数据流创建的每个后备索引继承该设置。@timestamp 是数据流文档必须具备的时间字段。
PUT _index_template/app-logs-template
{
  "index_patterns": ["app-logs*"],
  "priority": 200,
  "data_stream": {},
  "template": {
    "settings": {
      "index.lifecycle.name": "logs-retention-policy"
    },
    "mappings": {
      "properties": {
        "@timestamp": {
          "type": "date"
        }
      }
    }
  }
}
预期结果:
{
  "acknowledged": true
}
创建数据流后,应用应始终写入数据流名称 app-logs,不要直接写入 .ds- 开头的后备索引。
PUT _data_stream/app-logs预期结果:
{
  "acknowledged": true
}
验证执行状态
先确认 ILM 服务处于运行状态,再查看目标数据流后备索引当前所在的 phase、action 和 step。Explain API 还会返回失败原因,是排查策略未执行或阶段卡住的首选入口。
GET _ilm/status
GET app-logs/_ilm/explain
预期结果应同时满足:
GET _ilm/status 的 operation_mode 为 RUNNING。
GET app-logs/_ilm/explain 返回 managed: true。
phase、action、step 会随索引年龄和执行进度变化。
若返回 managed: false,通常是模板未命中、索引在绑定模板前已经创建,或策略名称拼写错误。若停在 rollover,应检查写入目标是否确实是数据流、阈值是否达到以及主分片状态;若停在 migrate,应检查 warm 节点角色、磁盘水位和分片分配解释。
本课总结
- ILM 通过 rollover 把“持续写入”与“历史索引治理”拆开,后续迁移和删除只作用于旧索引
- 生命周期策略必须经索引模板绑定,已存在索引不会因为新建模板而自动继承
_ilm/explain是验证托管状态、当前步骤和失败原因的核心接口
下一课预告
下一课将配置快照仓库,完成备份、仓库验证、隔离恢复和生产切换流程,建立可实际演练的数据恢复方案。