
NoSQL 与搜索 / 系统课时
中文分词策略
中文分词策略
中文搜索的关键不是“切得越多越好”,而是让文档入库时的词元与用户查询时的词元能够稳定相遇。本课将用 IK 分词器设计索引与搜索两套粒度,并通过 _analyze 验证结果。
学习目标
- 说明中文分词与英文按空格切词的差异
- 为不同字段选择索引阶段和搜索阶段的分词粒度
- 使用
_analyze对比分词结果并发现词典问题
中文分词为何要分阶段
中文句子通常没有天然空格,同一段文本可能存在多种切法。索引分析器负责把文档词元写入倒排索引,搜索分析器负责把用户输入转换成查询词元;二者可以不同,但必须保证查询词元有机会命中已写入的词元。
Elasticsearch 默认让查询沿用字段的索引分析器,也允许通过 search_analyzer 单独指定搜索分析器。IK 插件提供 ik_max_word 与 ik_smart:前者倾向产生更细的候选词元,后者倾向选择较粗的切分结果,而且两者结果不应被简单理解为严格的包含关系。
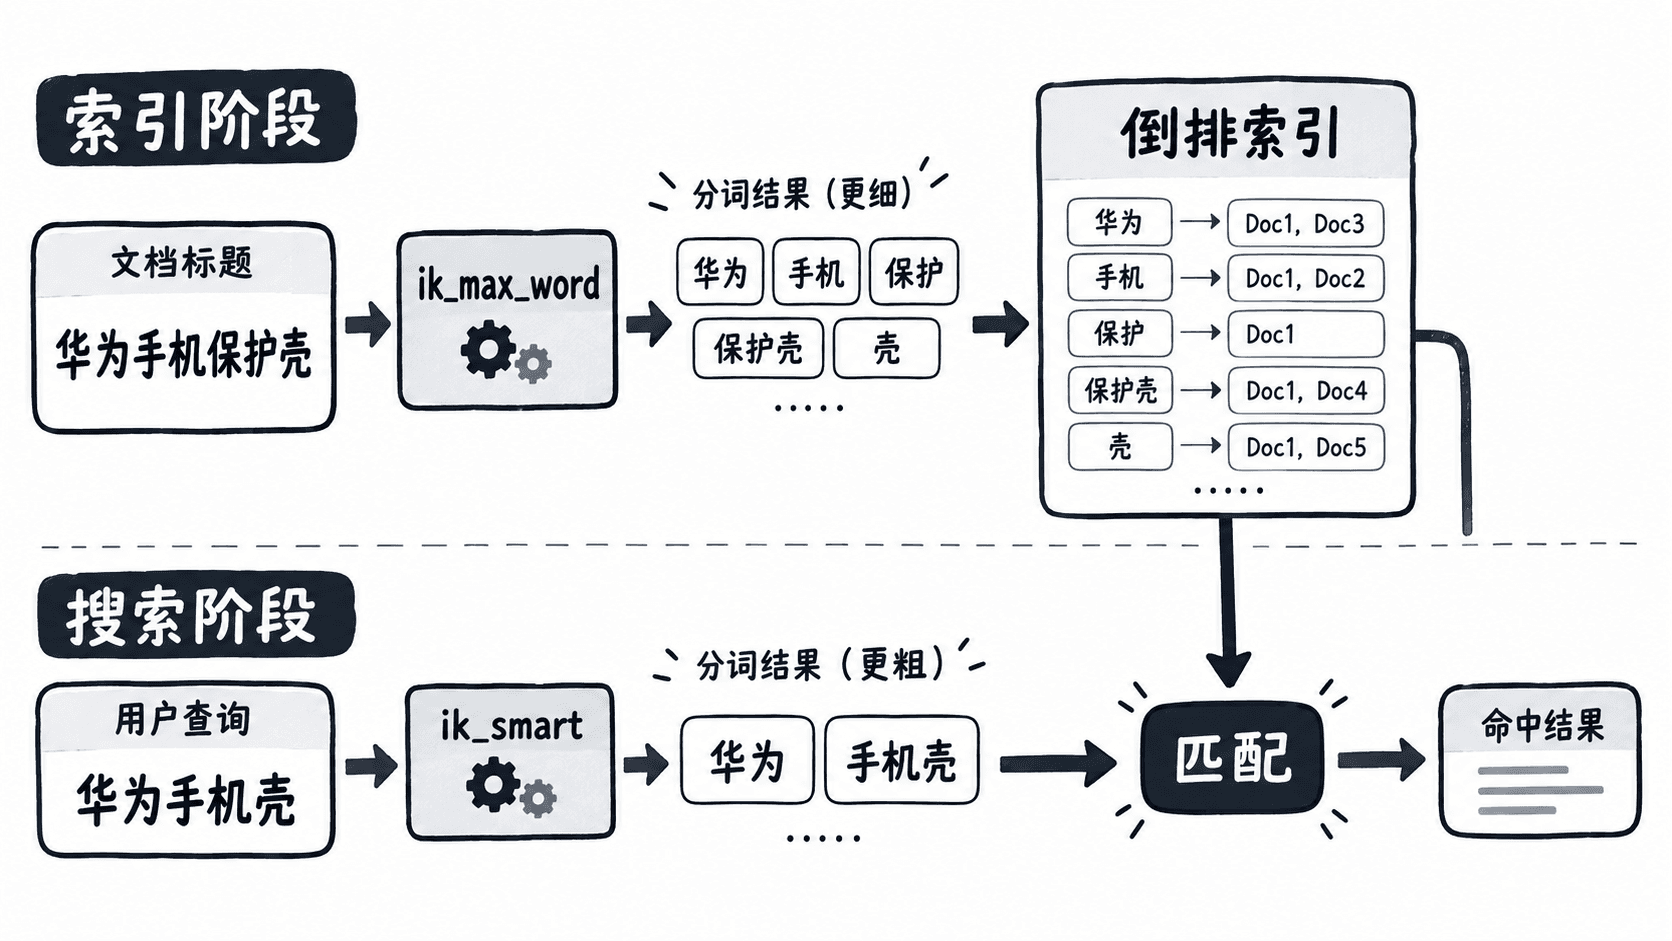
选择索引与搜索粒度
常见商品搜索可以采用“索引较细、搜索较稳”的方案:索引阶段保留更多候选词,提高召回机会;搜索阶段减少过度拆分,避免一个短查询被扩散成大量弱相关词元。这是起点,不是所有字段的固定答案。
| 字段 | 推荐策略 | 原因 |
|---|---|---|
| 商品名称、文章标题 | ik_max_word 索引,ik_smart 搜索 |
兼顾召回率与查询噪声 |
| 商品编码、订单号 | keyword |
标识符必须整体精确匹配 |
| 固定短语、品牌词 | 先测试,再决定两阶段是否一致 | 错切会直接降低精确匹配能力 |
| 长正文 | 结合业务词典评估 | 需要在召回率、索引体积和相关性之间平衡 |
选择粒度时应先收集真实查询词,再观察漏搜、误搜和短语匹配。若品牌、型号或行业术语被拆错,优先补充业务词典,不要仅靠切换到更细粒度掩盖问题。
创建字段并验证
下面示例假设所有 Elasticsearch 节点已经安装兼容版本的 IK 插件,且索引 products-cn 尚未创建。字段 name 在写入时使用 ik_max_word,查询时使用 ik_smart。
ES_URL="${ES_URL:-http://localhost:9200}"

curl -s -X PUT "$ES_URL/products-cn" \
  -H 'Content-Type: application/json' \
  -d '{
    "mappings": {
      "properties": {
        "name": {
          "type": "text",
          "analyzer": "ik_max_word",
          "search_analyzer": "ik_smart"
        }
      }
    }
  }'
预期输出
{"acknowledged":true,"shards_acknowledged":true,"index":"products-cn"}随后分别调用两个分析器。filter_path=tokens.token 只保留词元,便于比较;具体词元会受插件版本和自定义词典影响,因此以下使用占位符表示实际结果。
ES_URL="${ES_URL:-http://localhost:9200}"

echo "index_analyzer"
curl -s -X POST "$ES_URL/products-cn/_analyze?filter_path=tokens.token" \
  -H 'Content-Type: application/json' \
  -d '{"analyzer":"ik_max_word","text":"新能源汽车充电桩"}'

echo
echo "search_analyzer"
curl -s -X POST "$ES_URL/products-cn/_analyze?filter_path=tokens.token" \
  -H 'Content-Type: application/json' \
  -d '{"analyzer":"ik_smart","text":"新能源汽车充电桩"}'
预期输出
index_analyzer
{"tokens":[{"token":"<较细词元1>"},{"token":"<较细词元2>"},{"token":"<更多词元>"}]}

search_analyzer
{"tokens":[{"token":"<较粗词元1>"},{"token":"<较粗词元2>"}]}
实际验证时,不只比较词元数量,还要检查业务短语是否完整、同一型号是否被拆散,以及查询词元能否在索引词元中找到对应项。
关键边界与调优顺序
分词策略会影响新写入文档的倒排词元。修改字段的索引分析逻辑后,旧文档不会自动重新分词;若要让全部数据采用新规则,应建立新索引并执行重建,再通过别名切换流量。
调优应按“真实查询集 → _analyze 验证 → 小规模索引测试 → 相关性评估”的顺序进行。只看一个演示句子容易得到错误结论,尤其是品牌词、地名、型号和组合词。
本课总结
- 索引分析器决定倒排索引中保存什么,搜索分析器决定查询拿什么去匹配
ik_max_word索引配合ik_smart搜索是常见起点,但必须用业务语料验证- 修改索引阶段分词规则不会自动改写旧文档,完整生效通常需要重建索引
下一课预告
下一课将配置同义词与停用词,并区分搜索阶段热更新和索引阶段重建对现有数据的不同影响。