
NoSQL 与搜索 / 系统课时
Elastic Stack 组件关系
Elastic Stack 组件关系
当搜索系统还需要接入日志、指标和业务事件,并把结果展示成可查询的图表时,单独部署 Elasticsearch 往往不够。本课将梳理 Elasticsearch、Kibana、Logstash、Beats 与 Elastic Agent 的职责,建立从数据采集、加工、存储到分析的完整链路。
学习目标
- 说清 Elastic Stack 主要组件各自负责什么
- 理解数据进入 Elasticsearch 的常见路径
- 能按采集、加工和管理需求选择组件
组件职责与系统位置
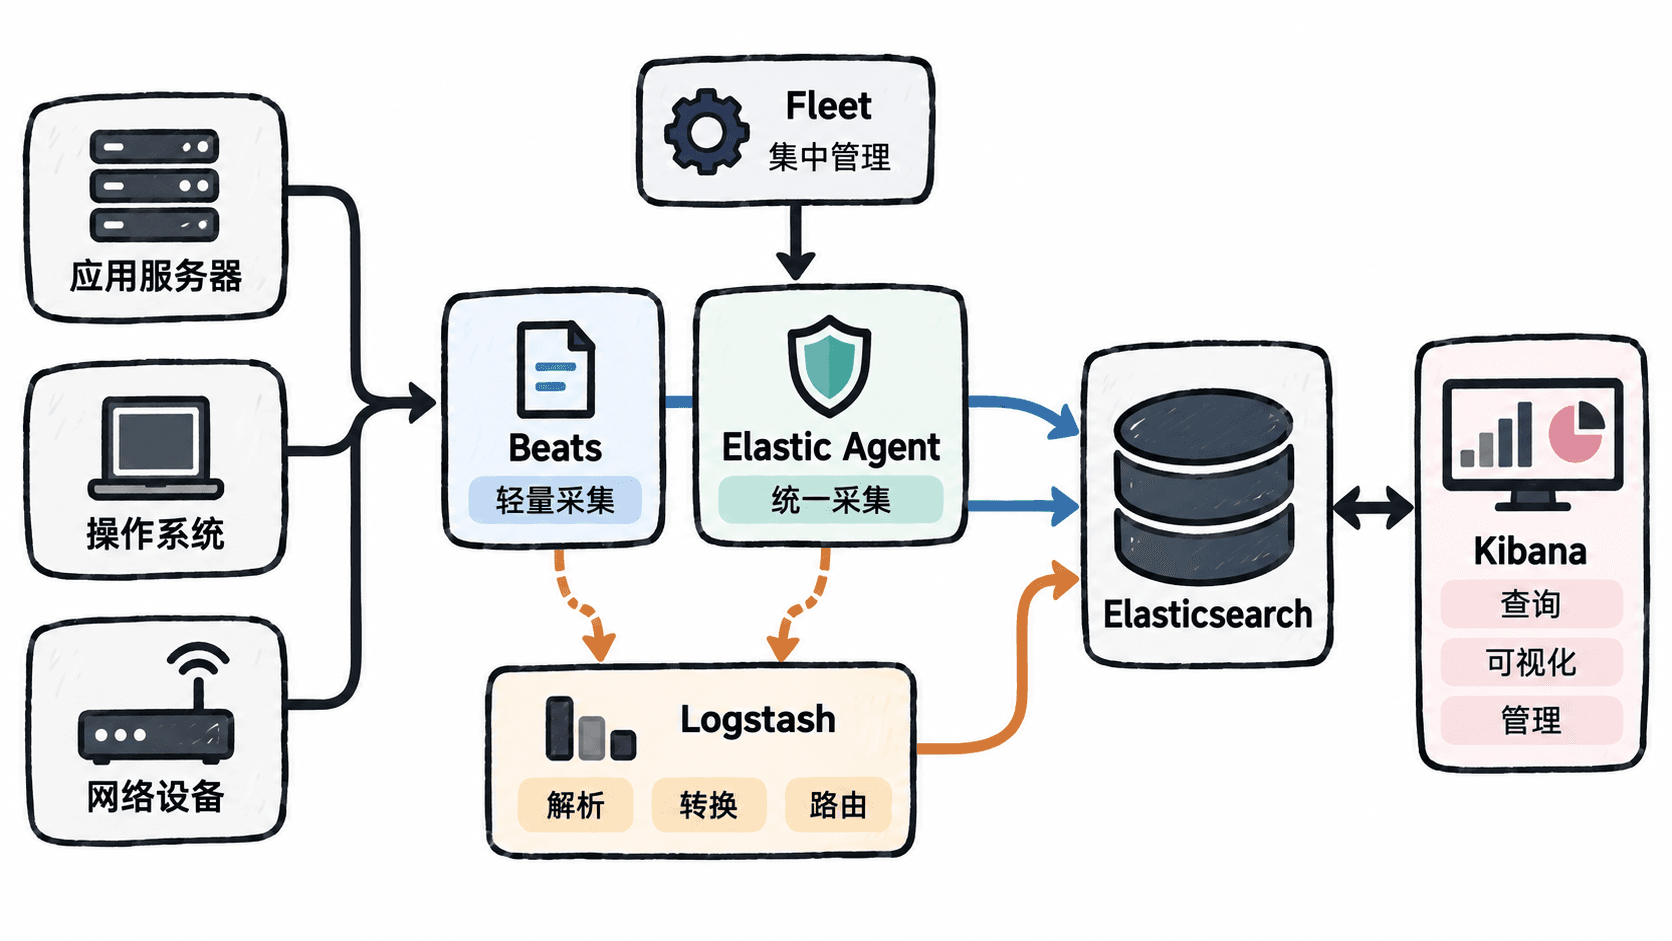
Elasticsearch 是核心存储与搜索引擎。它接收文档、建立索引,并提供全文检索、过滤、排序和聚合分析。业务系统可以通过 API 主动写入数据,其他采集组件也可以把处理后的数据发送给它。
Kibana 是查询、可视化和管理入口。它可以检索文档、制作仪表板、查看日志与指标,并管理数据视图和索引。Kibana 本身不承担业务数据的长期存储,页面中的结果仍来自 Elasticsearch。
Logstash 是独立的数据处理管道。它按照输入、过滤、输出三个阶段接收数据,完成字段解析、格式转换、标签补充、脱敏和条件路由。它适合清洗逻辑复杂、输入来源较多或需要发送到多个目标的场景。
Beats 是一组轻量级采集器,例如 Filebeat 采集日志,Metricbeat 采集主机和服务指标。它们通常部署在数据源附近,可以直接发送到 Elasticsearch,也可以先经过 Logstash。
Elastic Agent 是统一采集代理。一个 Agent 可以通过不同集成采集日志、指标和安全数据,并可配合 Fleet 集中下发策略、查看状态和管理版本,适合需要统一运维大量采集端的团队。
协作链路与选型方法
最短链路是业务系统直接调用 Elasticsearch API,适合应用主动维护搜索文档。采集日志或指标时,常由 Beats 或 Elastic Agent 在数据源附近收集,再直接写入 Elasticsearch。
当原始数据需要复杂解析、跨来源合并或按条件发送到不同目标时,可以在采集端与 Elasticsearch 之间加入 Logstash。此时采集器负责稳定地把数据送出,Logstash 负责集中加工,Elasticsearch 负责索引和查询。
只采集单一类型数据且希望保持轻量时,可以选择对应的 Beat。需要统一采集多类数据并集中管理时,Elastic Agent 更合适。只有确实存在复杂转换、多输入或多输出需求时,才需要引入 Logstash,否则会增加部署链路和运维成本。
容易混淆的职责边界
Elasticsearch 与 Logstash 都能处理数据,但位置不同。Elasticsearch 的 ingest pipeline 适合写入前的标准化转换;Logstash 是独立管道,更适合复杂流程、丰富插件以及多输入多输出。
Beats 与 Elastic Agent 也不是简单的替代关系。Beats 强调单一职责和轻量部署,Elastic Agent 强调统一集成与集中管理。选择时应先回答是否需要采集、是否需要复杂加工、是否需要集中运维,而不是默认部署全部组件。
Kibana 位于查询和管理侧。Elasticsearch 不可用时,Kibana 无法正常检索或展示数据,因此它不能替代后端搜索集群。
本课总结
- Elasticsearch 负责存储、索引与搜索,Kibana 负责查询展示与管理
- Beats 和 Elastic Agent 负责采集,Logstash 负责复杂加工与路由
- 组件应按实际链路组合,不必机械部署完整套件
下一课预告
下一课将进入 Elasticsearch 的分布式基础,理解节点如何组成集群,以及索引如何通过主分片和副本分片分布到不同节点。