
NoSQL 与搜索 / 系统课时
增量同步与删除传播
增量同步与删除传播
增量同步真正困难的不是“查出新数据”,而是保证同一时间点的多条更新不会漏、失败重试不会重复污染索引,并让源库中已经消失的记录也能可靠地从 Elasticsearch 删除。
学习目标
- 设计可连续推进且不会跳过记录的复合游标
- 使用稳定文档 ID 和批次提交实现幂等写入
- 建立可重试、可追踪的删除事件传播机制
为什么单一时间游标会漏数据
只保存 updated_at 看似简单,但数据库时间精度有限,同一毫秒可能出现多条记录。若上一批最后一条与下一批第一条时间相同,而查询条件使用 updated_at > cursor,同时间内尚未读取的记录会被永久跳过。
另一个问题是物理删除。记录被删除后,源表中已经无法再查到它,普通的“按更新时间扫描”也就无从知道 Elasticsearch 里应删除哪个文档。
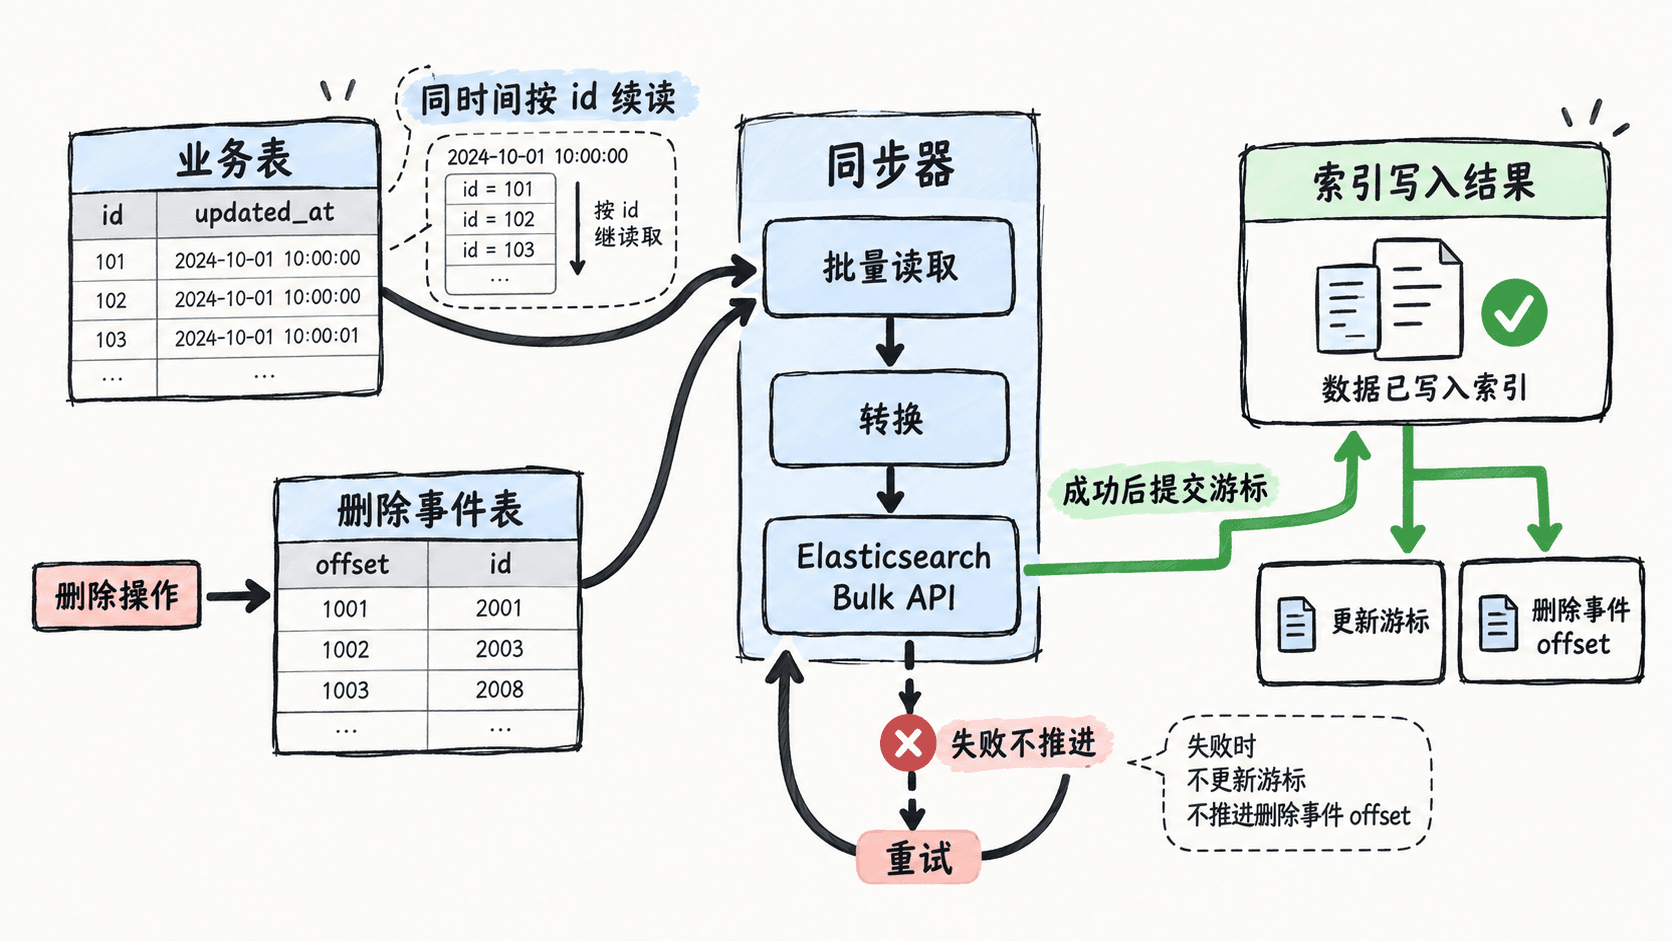
使用复合游标稳定分页
游标应保存最后成功处理记录的 (updated_at, id),查询按同样顺序排序。时间负责定位变化区间,主键负责解决相同时间下的稳定次序。
下面是查询片段示例,依赖业务表存在 id、updated_at 字段,并为两者建立联合索引。
SET @cursor_time = '2026-08-03 10:00:00';
SET @cursor_id = 1024;

-- 相同时间继续按主键推进,避免遗漏同批记录
SELECT id, title, status, updated_at
FROM product
WHERE updated_at > @cursor_time
   OR (updated_at = @cursor_time AND id > @cursor_id)
ORDER BY updated_at ASC, id ASC
LIMIT 500;
预期结果
返回游标之后最多 500 条记录;相同 updated_at 的记录继续按 id 递增返回。
只有整批写入 Elasticsearch 成功后,游标才更新为本批最后一条记录的时间与 id。
数据库侧应建立 (updated_at, id) 联合索引。不要先更新游标再写索引,否则进程在两步之间退出时,会把尚未写入的数据误判为已经完成。
用固定文档 ID 实现幂等写入
Elasticsearch 文档 _id 应直接使用源数据主键,或使用能唯一映射源记录的稳定业务键。这样同一条记录被重复发送时,只会覆盖同一个文档,不会产生重复副本。
批次处理应遵循“读取一批、批量写入、检查每一项结果、成功后提交游标”的顺序。Bulk API 即使返回 HTTP 200,也可能存在单项失败,因此必须同时检查响应中的 errors 和每个 items 状态。
下面的可运行 Python 示例用内存字典模拟索引,演示重复事件、同时间记录和删除事件如何保持一致。
events = [
    {"id": 2, "updated_at": "10:00:00.100", "op": "upsert", "title": "B"},
    {"id": 1, "updated_at": "10:00:00.100", "op": "upsert", "title": "A"},
    {"id": 2, "updated_at": "10:00:00.100", "op": "upsert", "title": "B2"},
    {"id": 1, "updated_at": "10:00:01.000", "op": "delete"},
]

index_store = {}
cursor = ("00:00:00.000", 0)

for event in sorted(events, key=lambda item: (item["updated_at"], item["id"])):
    key = (event["updated_at"], event["id"])
    if key < cursor:
        continue

    # 稳定主键保证重复 upsert 只覆盖同一文档
    if event["op"] == "upsert":
        index_store[event["id"]] = event["title"]
    else:
        index_store.pop(event["id"], None)

    cursor = key

print(index_store)
print(cursor)
预期输出
{2: 'B2'}
('10:00:01.000', 1)
实际系统中,事件必须拥有独立递增序号。示例用时间和主键演示排序,但同一记录在同一时间内连续变更时,仍应依赖 binlog 位点、消息 offset 或事件表自增 ID 区分先后。
让删除成为显式事件
删除传播常见方案有三种:软删除字段、删除事件表、数据库 CDC。业务规模较小时,可在同一事务中删除业务记录并插入 sync_delete_event;已有消息平台时,可通过 outbox 表再投递;数据链路成熟时,可直接消费 binlog 的 delete 事件。
无论使用哪种方案,删除事件至少需要包含源表、业务主键、事件序号和发生时间。同步成功后标记完成或推进 offset;失败事件进入重试队列,超过阈值后转入死信区,不能直接丢弃。
软删除虽然最容易被增量查询发现,但会增加业务表过滤条件和存储成本。物理删除加事件表更干净,却必须保证“删除数据”和“记录删除事件”处于同一事务,否则仍可能出现索引残留。
校验与风险控制
上线前应验证三类场景:同一时间写入多条记录、同一批次重复执行、源记录删除后索引文档消失。运行中持续监控同步延迟、批次失败数、删除积压和死信数量。
游标和事件 offset 应持久化到独立状态表,并记录任务名称、分片编号和最后成功时间。多实例并行时,每个分片只能有一个有效消费者,或通过消息系统的分区机制保证有序处理。
本课总结
- 使用
(updated_at, id)或更强的事件序号,才能稳定推进增量游标 - 固定
_id、检查 Bulk 单项结果并在成功后提交游标,可实现安全重试 - 删除必须转化为可持久化、可重放的显式事件,不能依赖源表扫描推断
下一课预告
下一课将把增量机制接入全量重建流程,完成新索引构建、追平变更、校验、别名切换与快速回滚。