
NoSQL 与搜索 / 系统课时
同义词与停用词
同义词与停用词
同义词用于统一不同表达,停用词用于移除低价值词元;两者都放在分析链路中,却会以不同方式影响召回结果和规则更新。本课将完成可更新的搜索分析器,并明确何时必须重建索引。
学习目标
- 编写等价同义词、定向同义词和停用词规则
- 配置只用于搜索阶段的
synonym_graph过滤器 - 判断规则更新是否需要重新索引现有文档
两类规则的作用边界
同义词解决“用户说法不同但意图相同”的问题,例如把“耳麦”归一为“耳机”。停用词解决“某些词出现频率高但区分度低”的问题,例如在特定商品搜索中移除“的”“了”“和”。
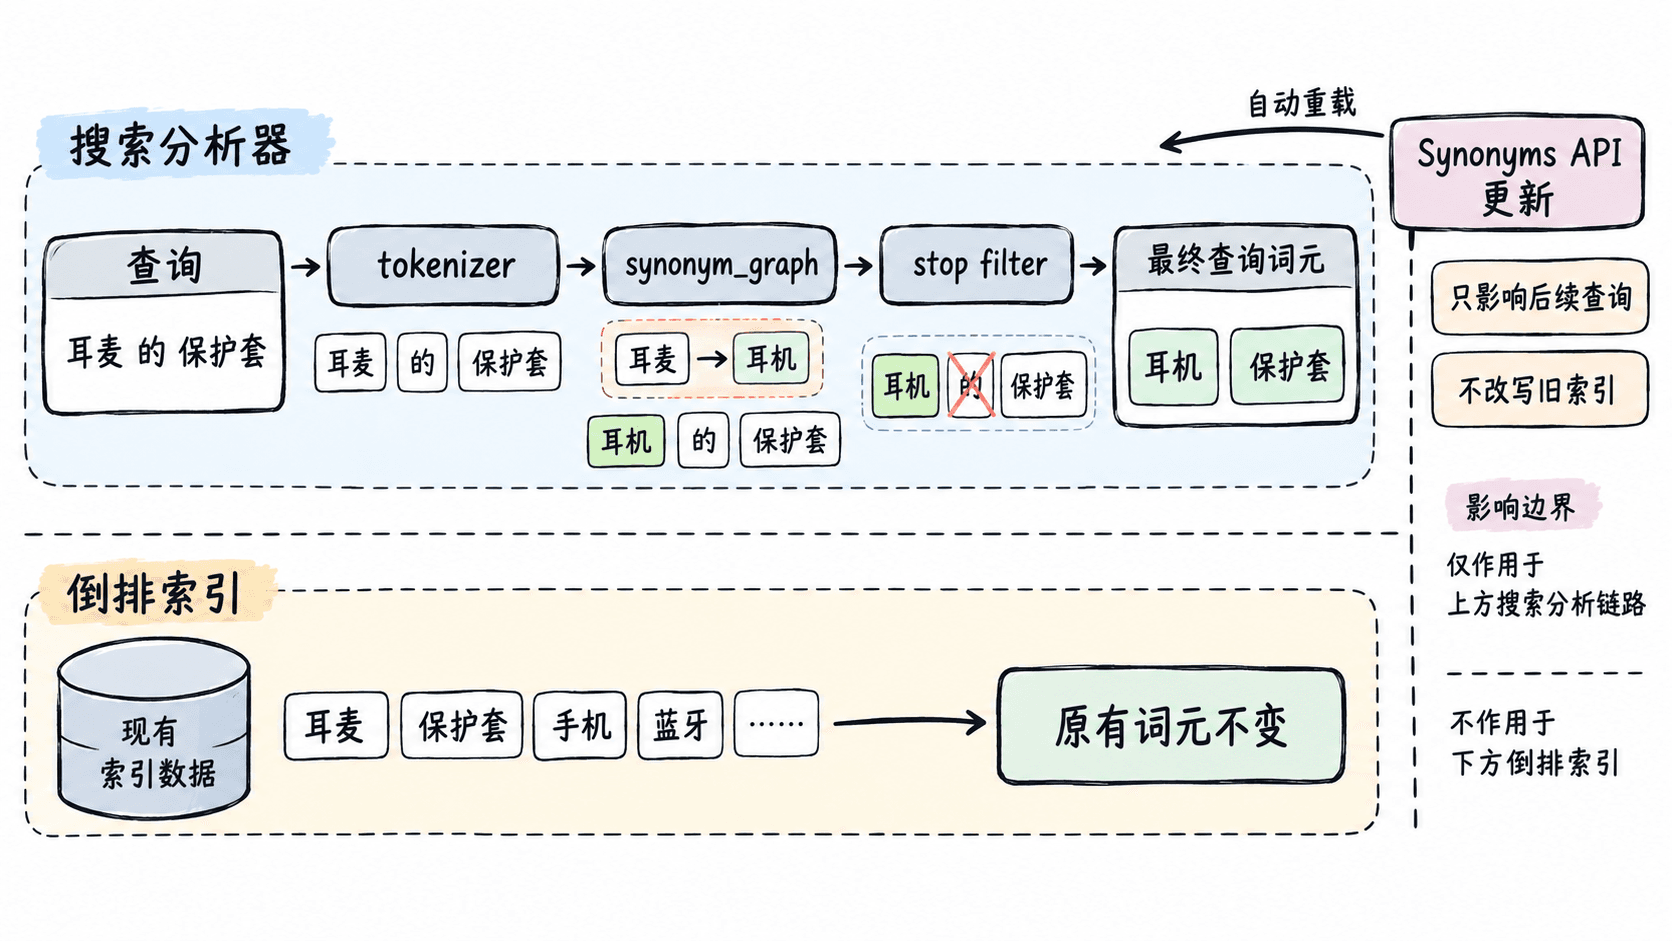
搜索分析链路中的执行顺序很重要。位于同义词过滤器之前的过滤器也会参与解析同义词规则,因此停用词放在前面可能删除规则中的词并导致规则失效;本课把同义词放在停用词之前,先完成归一化,再移除无意义词元。
编写规则并创建同义词集合
同义词规则常用 Solr 格式。逗号表示等价组,例如 手机, 移动电话;箭头表示定向归一,例如 耳麦 => 耳机。搜索系统通常优先使用定向规则,因为结果更可控,也更容易维护标准词。
以下示例适用于 Elasticsearch 8.10 及以上。先创建同义词集合,再创建引用它的索引;若索引先引用一个不存在的集合,索引可能处于不可用的部分创建状态。Synonyms API 管理的集合用于搜索阶段,更新后会自动重载关联的搜索分析器。
ES_URL="${ES_URL:-http://localhost:9200}"

curl -s -X PUT "$ES_URL/_synonyms/shop-cn?filter_path=result" \
  -H 'Content-Type: application/json' \
  -d '{
    "synonyms_set": [
      {"id":"earphone","synonyms":"耳麦 => 耳机"},
      {"id":"mobile-phone","synonyms":"移动电话 => 手机"}
    ]
  }'
首次创建的预期输出
{"result":"created"}若同名集合已经存在,接口会更新它,并返回 {"result":"updated"}。
配置搜索分析器
为了让规则行为可重复,示例使用 whitespace 分词器,并在测试文本中显式加入空格。生产环境应替换为已验证的中文分词器,但同义词集合、过滤器顺序和更新原则保持不变。
ES_URL="${ES_URL:-http://localhost:9200}"

curl -s -X PUT "$ES_URL/products-rules" \
  -H 'Content-Type: application/json' \
  -d '{
    "settings": {
      "analysis": {
        "filter": {
          "shop_synonyms": {
            "type": "synonym_graph",
            "synonyms_set": "shop-cn",
            "updateable": true
          },
          "shop_stop": {
            "type": "stop",
            "stopwords": ["的", "了", "和"]
          }
        },
        "analyzer": {
          "shop_index": {
            "type": "custom",
            "tokenizer": "whitespace",
            "filter": ["lowercase"]
          },
          "shop_search": {
            "type": "custom",
            "tokenizer": "whitespace",
            "filter": ["lowercase", "shop_synonyms", "shop_stop"]
          }
        }
      }
    },
    "mappings": {
      "properties": {
        "name": {
          "type": "text",
          "analyzer": "shop_index",
          "search_analyzer": "shop_search"
        }
      }
    }
  }'
预期输出
{"acknowledged":true,"shards_acknowledged":true,"index":"products-rules"}执行分析测试,确认“耳麦”被归一为“耳机”,停用词“的”被移除。
ES_URL="${ES_URL:-http://localhost:9200}"

curl -s -X POST "$ES_URL/products-rules/_analyze?filter_path=tokens.token" \
  -H 'Content-Type: application/json' \
  -d '{"analyzer":"shop_search","text":"耳麦 的 保护套"}'
预期输出
{"tokens":[{"token":"耳机"},{"token":"保护套"}]}更新规则与现有数据影响
通过 Synonyms API 更新 shop-cn 时,关联的搜索分析器会自动重载,因此后续查询会使用新规则,已写入文档无需重新索引。这个结论只适用于搜索阶段规则,不能推广到索引阶段分析器。
| 规则位置或存储方式 | 更新动作 | 是否重建现有文档 |
|---|---|---|
| Synonyms API,搜索阶段 | 更新集合,关联分析器自动重载 | 否 |
| 同义词文件,搜索阶段 | 所有相关节点同步文件,再调用 _reload_search_analyzers |
否 |
| 同义词或停用词,索引阶段 | 创建新索引并重新写入文档 | 是 |
| 静态分析器配置 | 采用版本化索引和别名切换 | 取决于是否改变索引词元 |
文件型同义词必须在相关节点保持一致,重载搜索分析器后还应清理请求缓存,避免旧缓存继续返回基于旧规则的结果。无论采用哪种方式,都应先调用 _analyze 验证规则,错误规则可能阻止分析器重载。
常见错误
不要把可更新的 synonym_graph 同时用于索引分析器。updateable: true 的过滤器应只服务于搜索分析器,否则索引中不同批次文档可能采用不同规则,结果难以解释。
不要将大量规则直接写在索引设置中。内联规则适合快速测试,生产环境更适合使用 Synonyms API;它便于集中维护,并能避免每次修改都重建索引设置。
本课总结
- 同义词负责归一或扩展表达,停用词负责移除低价值词元,过滤器顺序会改变结果
- 搜索阶段的 Synonyms API 规则可更新且无需重建现有文档
- 任何改变索引阶段词元的规则都不会自动作用于旧文档,完整生效需要重新索引
下一课预告
下一课将把自定义分析器应用到实际字段映射中,并通过查询结果检查召回率、短语匹配和相关性排序。