
NoSQL 与搜索 / 系统课时
慢查询与热点分析
慢查询与热点分析
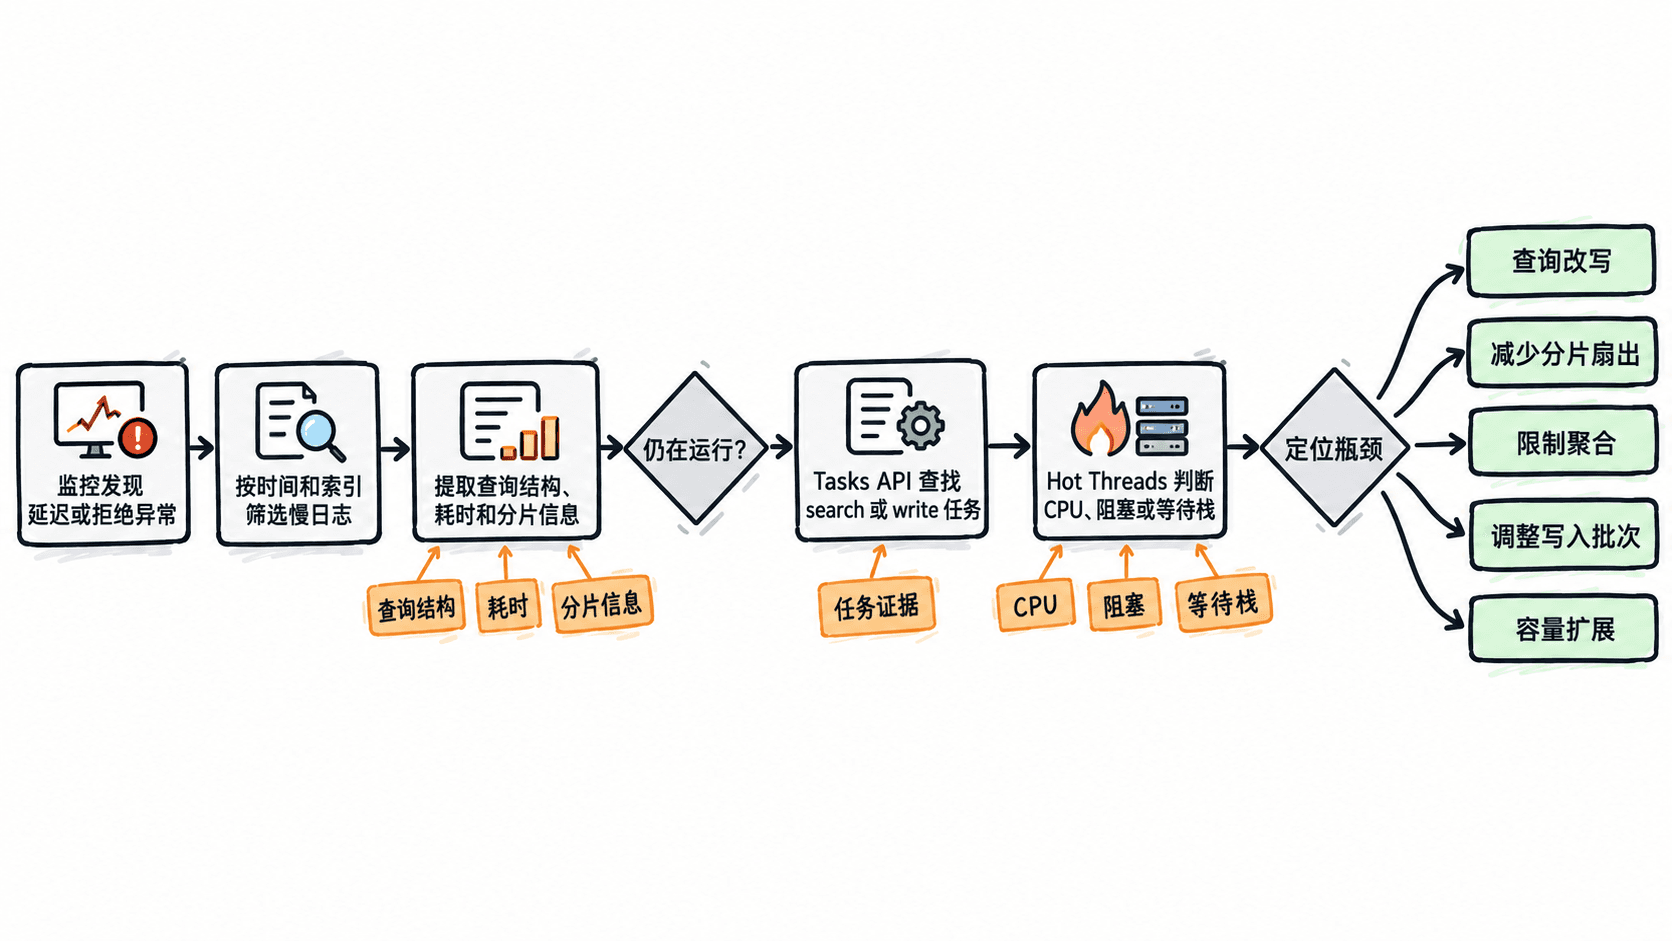
本课给出一条从“请求变慢”到“定位异常工作负载”的排查链路:先用慢日志锁定索引和请求,再借助任务接口与热点线程确认正在消耗 CPU 的查询或写入操作。
学习目标
- 配置并验证搜索慢日志与写入慢日志
- 使用任务接口识别长时间运行的搜索任务
- 结合热点线程判断 CPU 消耗的真实执行位置
先确定异常范围
慢查询分析应先回答三个问题:异常发生在哪个时间窗口、影响哪些索引或接口、主要表现为搜索慢还是写入慢。若跳过这一步直接查看热点线程,容易把正常的合并、GC 或短时高负载误判为根因。
建议先对照监控中的 P95/P99 延迟、搜索与写入线程池队列、拒绝数、CPU 和 GC。只有当这些指标在同一时间段出现关联变化,后续日志和线程证据才具有定位价值。
开启并验证慢日志
慢日志是索引级动态设置。搜索慢日志分别记录 query 和 fetch 阶段,写入慢日志记录单条文档索引耗时。阈值应基于业务延迟目标设置,测试后再逐步收紧,避免阈值过低导致日志量暴增。
下面给 products-* 索引设置示例阈值,并读取配置验证。请替换连接信息;示例阈值仅用于演示,不应直接作为所有生产索引的统一标准。
ES_URL="https://<HOST>:<PORT>"

curl -sS -u "<USER>:<PASSWORD>" -X PUT \
  "$ES_URL/products-*/_settings" \
  -H "Content-Type: application/json" \
  -d '{
    "index.search.slowlog.threshold.query.warn": "2s",
    "index.search.slowlog.threshold.query.info": "1s",
    "index.search.slowlog.threshold.fetch.warn": "500ms",
    "index.indexing.slowlog.threshold.index.warn": "1s"
  }'

curl -sS -u "<USER>:<PASSWORD>" \
  "$ES_URL/products-*/_settings?flat_settings=true&filter_path=*.settings.index.search.slowlog.*,*.settings.index.indexing.slowlog.*"
预期输出
{"acknowledged":true}
{"<INDEX_NAME>":{"settings":{"index.indexing.slowlog.threshold.index.warn":"1s","index.search.slowlog.threshold.fetch.warn":"500ms","index.search.slowlog.threshold.query.info":"1s","index.search.slowlog.threshold.query.warn":"2s"}}}
实际索引名可能不同。第一段返回 acknowledged: true 表示设置已接受,第二段应回显刚配置的阈值。日志文件位置与输出方式由部署形态和日志配置决定;容器、托管服务与自建节点的查看路径可能不同。
阅读慢日志证据
分析慢日志时,优先提取时间、索引、分片、耗时、命中数和查询源。搜索慢要区分 query 阶段与 fetch 阶段:query 慢通常与查询结构、聚合、脚本或分片扇出有关;fetch 慢更多与返回文档数量、_source 体积或存储读取有关。
写入慢则要结合文档大小、动态映射、分析器复杂度、刷新频率、段合并和磁盘 I/O。不要只凭一条慢日志下结论,应查看同类请求是否重复出现,以及它是否与线程池排队、CPU 或磁盘压力同步。
高风险模式通常包括深分页、大范围通配符或正则查询、基数很高的聚合、脚本评分、一次请求访问过多分片,以及批量写入尺寸失控。定位到查询后,应先缩小返回字段、限制聚合桶数、改用 search_after、增加过滤条件或减少分片扇出,再考虑单纯扩容。
检查运行任务
慢日志说明“已经慢过什么”,任务接口则能查看“当前还在运行什么”。下面查询正在执行的搜索任务。默认响应按节点分组,任务对象中的 parent_task_id 可用于追踪父子关系;返回内容取决于当时是否存在长查询。
ES_URL="https://<HOST>:<PORT>"

curl -sS -u "<USER>:<PASSWORD>" \
  "$ES_URL/_tasks?detailed=true&actions=*search"
预期输出
{"nodes":{"<NODE_ID>":{"name":"<NODE_NAME>","tasks":{"<NODE_ID>:<TASK_ID>":{"node":"<NODE_ID>","id":"<TASK_ID>","type":"transport","action":"indices:data/read/search","running_time_in_nanos":"<NANOSECONDS>","cancellable":true,"parent_task_id":"<PARENT_TASK_ID>","headers":{}}}}}}没有正在运行的搜索任务时,nodes 中可能没有对应任务。重点关注 running_time_in_nanos、action、父子任务关系和 cancellable。取消任务前必须确认它是可安全中断的用户请求,并记录请求来源;不要把取消操作当作根因修复。
分析热点线程
当 CPU 持续偏高或任务接口显示长查询时,可查看热点线程。type=cpu 适合定位计算密集型调用栈,ignore_idle_threads=true 可减少空闲线程干扰。
ES_URL="https://<HOST>:<PORT>"

curl -sS -u "<USER>:<PASSWORD>" \
  "$ES_URL/_nodes/hot_threads?threads=5&type=cpu&ignore_idle_threads=true"
预期输出
::: {es-data-01}{<NODE_ID>}{<ADDRESS>}
   Hot threads at <TIME>, interval=500ms, busiestThreads=5, ignoreIdleThreads=true:

   <CPU_PERCENT>% (<CPU_TIME> out of 500ms) cpu usage by thread '<THREAD_NAME>'
     10/10 snapshots sharing following 20 elements
       <STACK_FRAME_1>
       <STACK_FRAME_2>
       <STACK_FRAME_3>
实际线程名、CPU 百分比和调用栈会变化。分析时不要只看第一行线程名,还要观察多个采样是否反复出现同一调用栈。若栈集中在搜索、聚合或脚本执行,应回到对应查询优化;若集中在 GC、段合并或存储等待,则应转向堆压力、写入节奏和磁盘性能。
从证据到修复验证
可靠结论至少需要两类证据互相印证。例如,慢日志反复出现同一聚合查询,任务接口显示它持续运行,热点线程又集中在聚合执行栈,此时才能较有把握地认定异常查询是主要负载。
修复后应使用同一时间窗口和同一请求样本复测,比较 P95/P99、线程池队列、拒绝数、CPU、慢日志数量和任务运行时间。若只看到平均延迟下降,而尾延迟和拒绝数没有改善,说明瓶颈可能仍然存在。
本课总结
- 慢日志用于锁定历史慢请求,任务接口用于查看当前长任务,热点线程用于确认资源消耗位置
- query、fetch 与 indexing 慢日志对应不同瓶颈,必须结合线程池和资源指标判断
- 根因结论应由至少两类证据支持,并在修复后用同一指标窗口复测
下一课预告
下一课将进一步整理常见集群故障的定位顺序,把健康状态、未分配分片、节点离线和资源耗尽纳入统一排查流程。