
NoSQL 与搜索 / 系统课时
分页与结果排序
分页与结果排序
本课通过一个订单索引完成固定排序下的第二页查询,并解释 from、size 与 sort 如何共同决定结果。随后从分片收集过程理解深度分页成本,明确何时继续使用基础分页,何时改用 search_after。
学习目标
- 根据页码和每页数量计算
from与size - 使用多个排序字段获得稳定、可重复的分页结果
- 解释深度分页的资源成本与替代方案
基础分页规则
size 表示本次返回多少条命中,from 表示跳过前多少条。页码从 1 开始时,可使用 from = (page - 1) × size 计算偏移量。例如每页 2 条,第 2 页的 from 为 2。
分页必须配合明确排序。只按一个可能重复的字段排序时,同值文档的先后顺序可能不稳定,翻页过程中就可能出现重复或遗漏。因此通常追加一个唯一且可排序的 keyword 字段作为第二排序键。
查询第二页订单
下面示例创建五条订单,按 createdAt 倒序、orderNo 升序排列,然后读取第 2 页,每页 2 条。第二排序字段 orderNo 在时间相同时负责稳定顺序。
set -euo pipefail
ES="${ES:-http://localhost:9200}"

# 重建索引,避免旧数据影响分页顺序
curl -s -X DELETE "$ES/orders" >/dev/null || true

curl -s -X PUT "$ES/orders" \
  -H 'Content-Type: application/json' \
  -d '{
    "mappings": {
      "properties": {
        "orderNo": { "type": "keyword" },
        "amount": { "type": "integer" },
        "createdAt": { "type": "date" }
      }
    }
  }' >/dev/null

# 写入五条时间连续的订单,便于验证排序结果
curl -s -X POST "$ES/orders/_bulk?refresh=true" \
  -H 'Content-Type: application/x-ndjson' \
  --data-binary $'{"index":{"_id":"1"}}\n{"orderNo":"O001","amount":100,"createdAt":"2026-07-01T10:00:00Z"}\n{"index":{"_id":"2"}}\n{"orderNo":"O002","amount":200,"createdAt":"2026-07-02T10:00:00Z"}\n{"index":{"_id":"3"}}\n{"orderNo":"O003","amount":300,"createdAt":"2026-07-03T10:00:00Z"}\n{"index":{"_id":"4"}}\n{"orderNo":"O004","amount":400,"createdAt":"2026-07-04T10:00:00Z"}\n{"index":{"_id":"5"}}\n{"orderNo":"O005","amount":500,"createdAt":"2026-07-05T10:00:00Z"}\n' >/dev/null

# 读取第 2 页,并使用唯一订单号稳定同值排序
curl -s -X POST \
  "$ES/orders/_search?filter_path=hits.total,hits.hits._id,hits.hits._source" \
  -H 'Content-Type: application/json' \
  -d '{
    "from": 2,
    "size": 2,
    "query": {
      "match_all": {}
    },
    "sort": [
      { "createdAt": { "order": "desc" } },
      { "orderNo": { "order": "asc" } }
    ]
  }'
预期输出
{"hits":{"total":{"value":5,"relation":"eq"},"hits":[{"_id":"3","_source":{"orderNo":"O003","amount":300,"createdAt":"2026-07-03T10:00:00Z"}},{"_id":"2","_source":{"orderNo":"O002","amount":200,"createdAt":"2026-07-02T10:00:00Z"}}]}}完整排序后的顺序是 O005、O004、O003、O002、O001。from: 2 跳过前两条,size: 2 因而返回 O003 和 O002。
深度分页为什么变慢
Elasticsearch 在每个相关分片上收集足够多的候选结果,再由协调节点合并排序。请求 from: 10000, size: 20 时,并不是直接读取第 10001 条;每个分片都可能需要维护前 10020 个候选项,随后再进行跨分片归并。
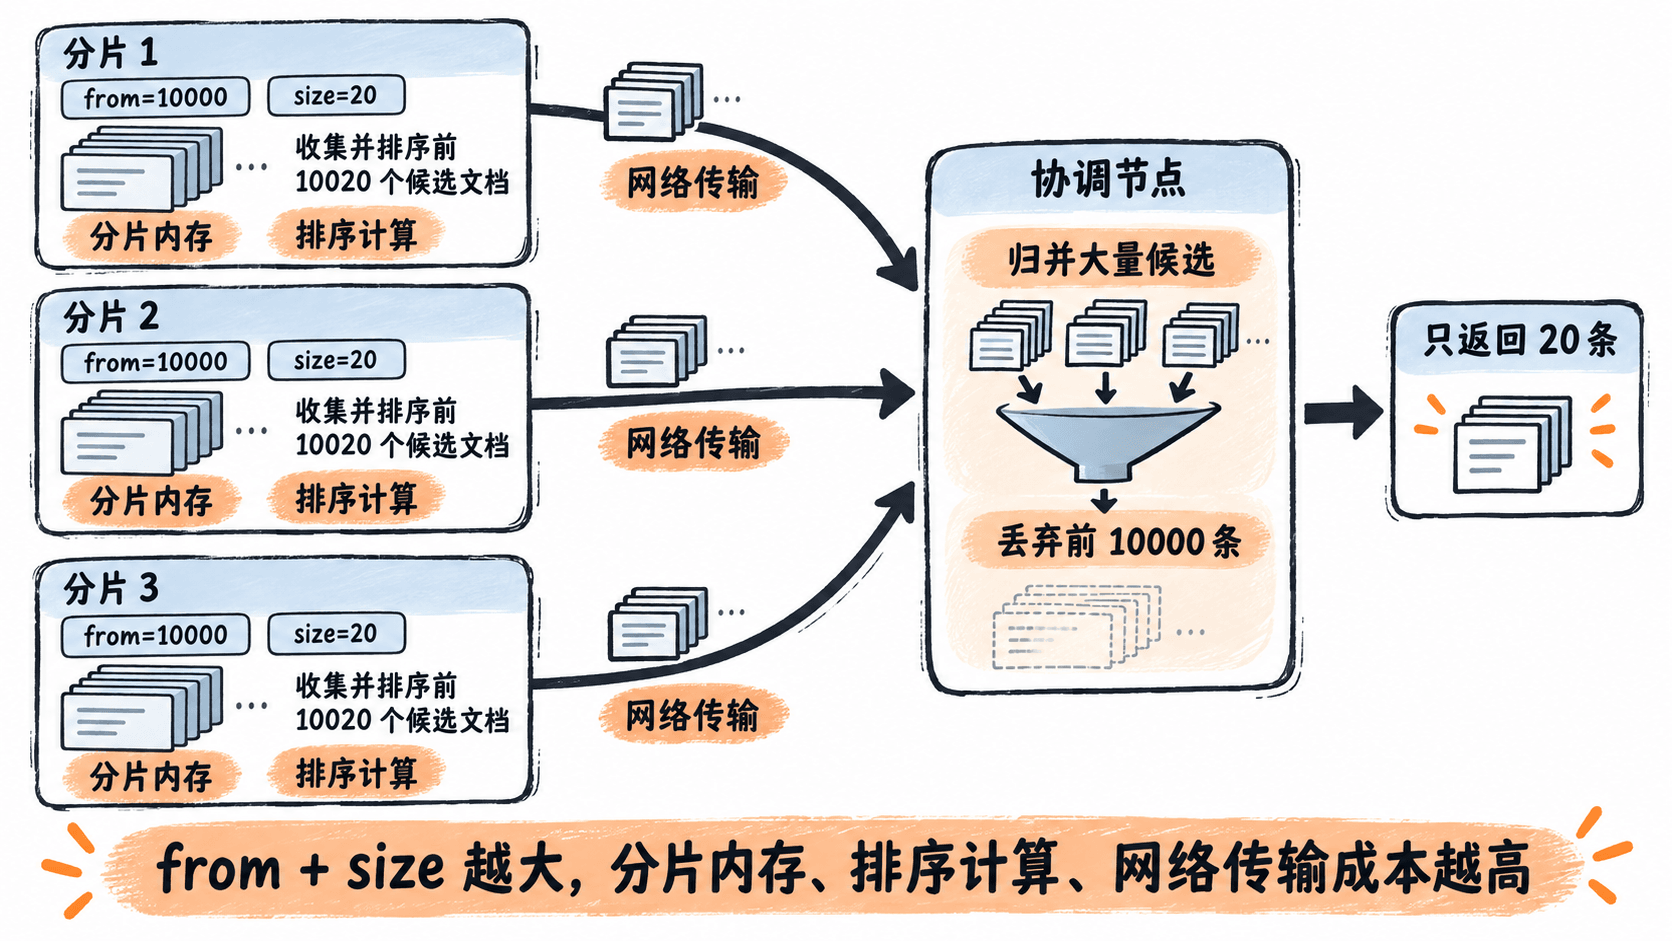
默认情况下,from + size 不能超过索引的 index.max_result_window,常见默认值为 10000。直接调大该设置会扩大可收集结果窗口,但也会增加堆内存和查询时间压力,因此不应把它当作深度分页的首选修复。
选择合适的分页方式
面向用户的前几页、页码跳转和较小结果集,使用 from 与 size 最直观。排序字段应固定,并包含唯一的最终排序键;查询条件或排序规则变化后,应从第一页重新开始。
需要连续遍历大量结果时,使用 search_after。下一页请求携带上一页最后一条命中的 sort 值,不再要求 Elasticsearch 反复跳过越来越多的前置结果。结果集在遍历期间可能变化时,可结合 Point in Time(PIT)保持一致性。
不要使用 _id 作为普通排序字段。更稳妥的做法是在文档中保存具有 doc_values 的唯一 keyword 字段,例如示例中的 orderNo,并把它作为最后一个排序键。
本课总结
from控制跳过数量,size控制返回数量,页码需要换算成偏移量- 稳定分页依赖固定排序,并应使用唯一字段解决同值顺序
- 深度分页会放大分片收集与协调节点归并成本,大量顺序遍历应改用
search_after
下一课预告
下一课将继续学习 Query DSL 的查询组织方式,把分页、排序与业务筛选组合成可复用的搜索接口请求。