
NoSQL 与搜索 / 系统课时
相关性评分原理
相关性评分原理
本课解决“为什么同一查询下某些文档排在前面”的问题。你将从词频、逆文档频率和字段长度三个角度理解 BM25,并能借助 _explain 接口定位基础得分来源。
学习目标
- 说清词频、逆文档频率和字段长度对得分的影响
- 理解 BM25 的词频饱和与长度归一化机制
- 使用
_explain查看一篇文档的评分明细
BM25 如何形成得分
全文检索不能只判断“是否包含关键词”,还要估计“这篇文档与查询有多相关”。Elasticsearch 默认使用 BM25 相似度模型,对查询中的每个词分别计算贡献,再将贡献累加为文档得分 _score。
一个便于理解的简化形式如下:
其中,tf 是词在当前字段中出现的次数,IDF 衡量该词在全部文档中的稀有程度,|d|/avgdl 表示当前字段长度与平均字段长度的比值。默认参数通常为 k1=1.2、b=0.75。
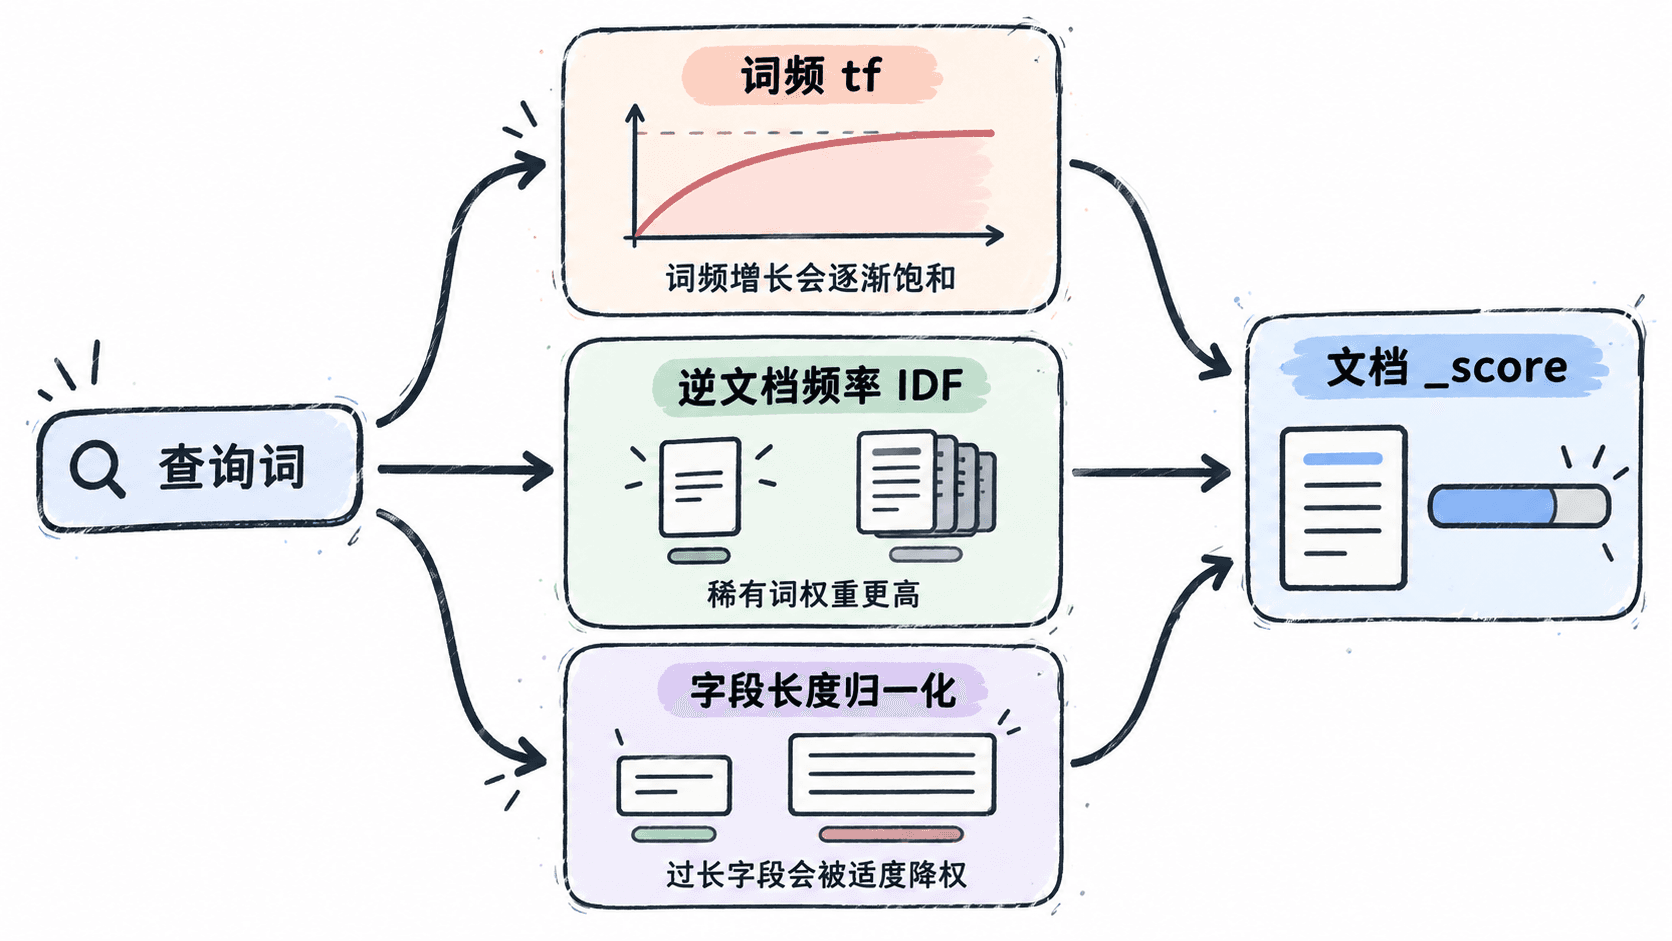
词频越高,通常说明文档更聚焦于查询词,但 BM25 不会让得分无限线性增长。一个词从出现 1 次增加到 2 次,影响较明显;从 20 次增加到 21 次,提升已经很小,这就是词频饱和。
逆文档频率体现“稀有词更有区分度”。若“搜索”出现在几乎所有文档中,它提供的信息有限;若“BM25”只出现在少量文档中,它更能帮助系统识别目标内容,因此贡献通常更高。
字段长度归一化用于避免长文本仅因词多而占优。同样出现 3 次关键词,短标题可能比长正文更集中。参数 b 控制长度影响程度:接近 0 时弱化长度归一化,接近 1 时更重视字段长度差异。
使用 Explain 查看评分明细
下面的请求可直接粘贴到 Kibana Dev Tools。它创建两篇文档,并解释文档 1 对查询“Elasticsearch 搜索”的得分组成。
PUT bm25_demo
{
  "mappings": {
    "properties": {
      "title": {
        "type": "text"
      }
    }
  }
}

POST bm25_demo/_doc/1
{
  "title": "Elasticsearch 搜索入门"
}

POST bm25_demo/_doc/2
{
  "title": "全文搜索系统设计"
}

POST bm25_demo/_refresh

GET bm25_demo/_explain/1
{
  "query": {
    "match": {
      "title": "Elasticsearch 搜索"
    }
  }
}
预期结果:
创建索引:HTTP 200
写入文档:HTTP 201
刷新索引:HTTP 200
Explain 请求:HTTP 200
matched: true
explanation.value: <SCORE>
explanation.details: 包含权重、IDF、词频和字段长度等明细
<SCORE> 会随文档数量、分词结果、Lucene 版本和索引内容变化。阅读 details 时,应从最外层总分向内展开,先确认命中的查询词,再查找 idf、freq、dl 和 avgdl 等信息。
正确解释与使用边界
_score 不是跨索引、跨查询都可直接比较的绝对分数。查询结构、字段权重、分片统计信息、相似度参数和索引数据变化,都会改变最终值。更可靠的做法是比较同一次查询中的排序,并结合 _explain 或 Profile API 分析原因。
BM25 也不会理解业务价值。新品、库存、点击率或商户等级等因素,需要通过 function_score、script_score 或排序规则另行加入。基础相关性负责“文本是否匹配”,业务排序负责“匹配后谁更值得靠前”。
本课总结
- BM25 主要综合词频、逆文档频率和字段长度归一化计算相关性
- 词频贡献会逐渐饱和,稀有词通常比高频通用词更有区分度
_explain适合定位单篇文档的得分来源,但分数应在同一查询内比较
下一课预告
下一课将把相关性原理应用到多个字段,使用 multi_match 同时搜索标题、摘要和正文,并通过字段权重突出更重要的匹配位置。