
NoSQL 与搜索 / 系统课时
搜索索引同步模式
搜索索引同步模式
业务数据通常先写入数据库,再进入 Elasticsearch。同步方案决定了索引的新鲜度、可靠性与维护成本。本课将比较全量导入、定时增量、应用双写和变更数据捕获,并给出可落地的选型与验收方法。
学习目标
- 说明四种索引同步模式的工作方式与主要风险
- 根据实时性、数据规模和团队能力选择合适方案
- 使用复合游标避免增量同步中的遗漏与重复
同步策略解决什么问题
Elasticsearch 通常不是业务事实的唯一来源,数据库中的新增、修改和删除必须持续映射到搜索索引。同步设计需要同时回答三个问题:数据多久可见、失败后如何补偿、历史数据如何重建。
只追求“能写进去”是不够的。生产方案还要处理乱序更新、重复投递、删除事件、字段变更和索引重建,否则搜索结果会逐渐偏离业务数据。
四种模式如何工作
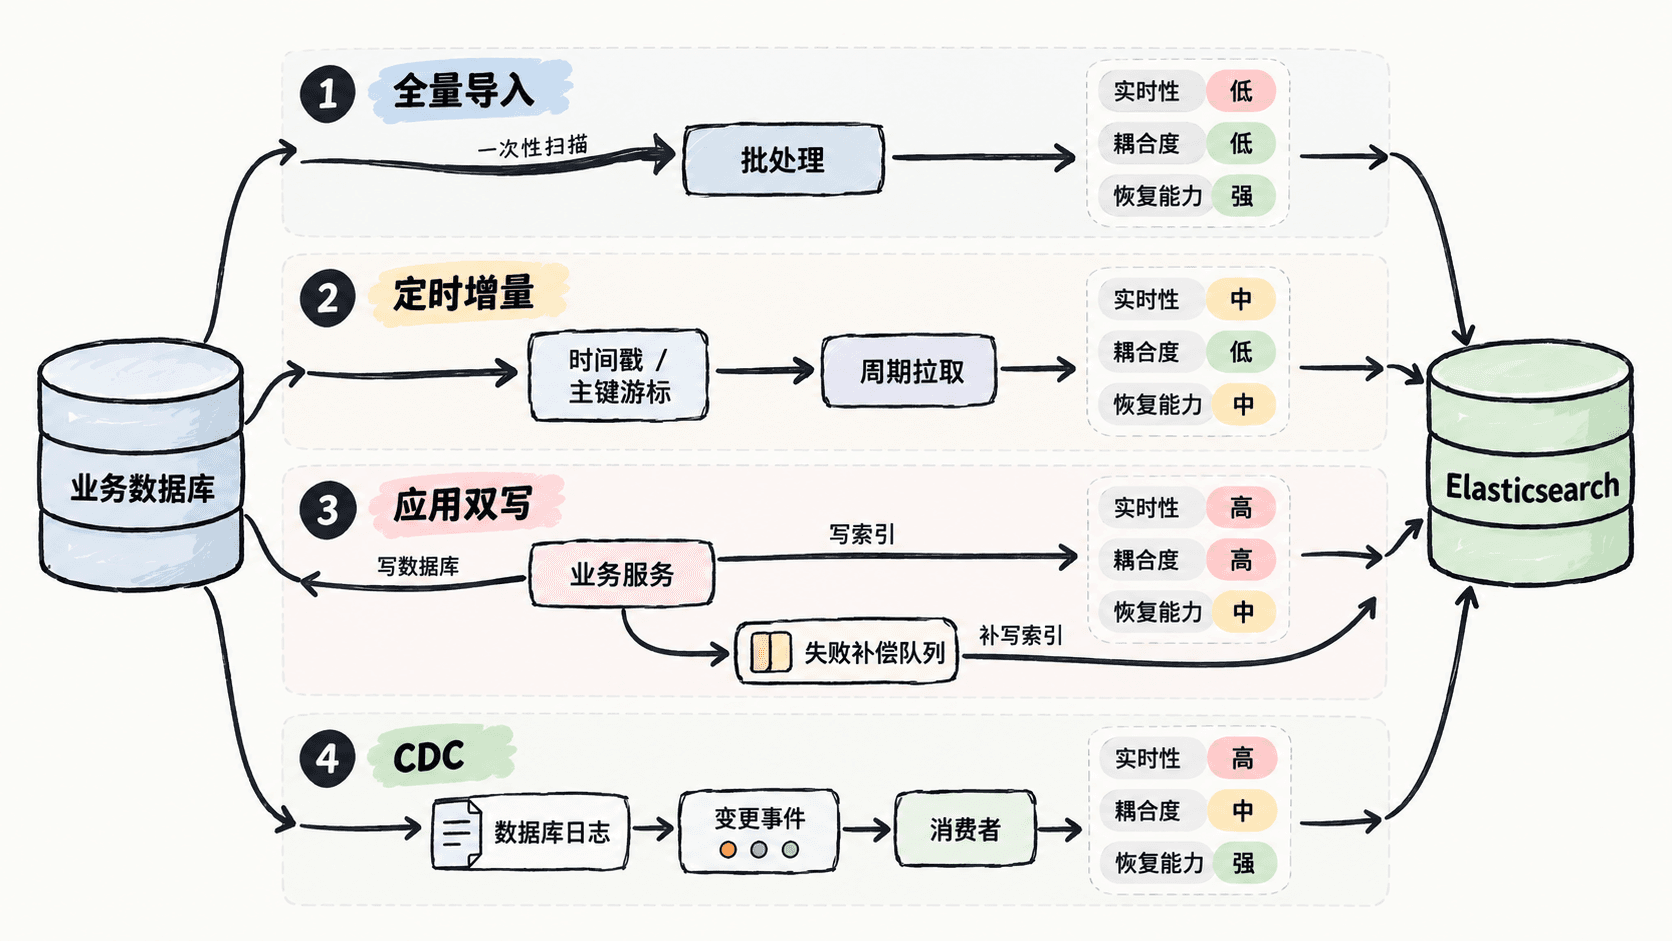
全量导入
全量导入会扫描全部源数据并重新写入索引。它实现简单,适合首次建索引、数据量较小或离线更新场景,但执行时间长,频繁运行会给数据库和集群带来明显压力。
生产环境常配合“新索引加别名切换”:先写入新索引,校验完成后原子切换别名,再删除旧索引。这样可以避免重建期间用户读到半成品数据。
定时增量
定时增量按更新时间、递增主键或业务游标拉取变化数据。它比全量导入轻量,适合允许分钟级延迟的系统,但必须正确处理同一时间戳内的多条记录、任务重跑和物理删除。
单独使用 updated_at > last_time 容易漏掉边界数据。更稳妥的做法是使用“更新时间加主键”的复合游标,并让写入 Elasticsearch 的操作保持幂等。
应用双写
应用双写在业务请求中同时更新数据库和 Elasticsearch,数据延迟低,逻辑也直观。问题是两个系统无法天然处于同一个本地事务中,一端成功、另一端失败时会产生不一致。
可靠实现通常不是简单地连续调用两次,而是数据库事务内写业务表和本地事件表,提交后由异步任务投递并重试。搜索索引仍可按文档 ID 覆盖写入,以承受重复消息。
变更数据捕获
变更数据捕获(CDC)读取数据库事务日志,将插入、更新和删除转换为事件,再由消费者同步到 Elasticsearch。它与业务代码解耦,实时性高,也便于多个下游复用同一份变更流。
CDC 的成本主要在基础设施和事件治理:必须管理日志保留、消费位点、表结构变更、乱序事件和失败重放。团队缺少消息系统运维能力时,不宜仅为了“更实时”而贸然引入。
如何选择同步模式
| 判断维度 | 全量导入 | 定时增量 | 应用双写 | CDC |
|---|---|---|---|---|
| 常见延迟 | 小时级或按需 | 秒级到分钟级 | 毫秒级到秒级 | 秒级以内 |
| 业务耦合 | 低 | 低 | 高 | 低 |
| 实现成本 | 低 | 中 | 中 | 高 |
| 删除同步 | 需额外比对 | 需软删除标记 | 业务代码处理 | 可读取删除事件 |
| 适合场景 | 初始化、重建 | 中小系统、报表搜索 | 强实时且业务可控 | 大规模实时同步 |
实际项目常采用组合方案:CDC 或增量任务负责日常同步,全量导入负责首次初始化和灾难重建。无论主方案是什么,都应保留可重复执行的全量重建能力。
用复合游标实现安全增量
下面的 MySQL 脚本使用固定数据演示复合游标。查询条件先比较 updated_at,时间相同时再比较 id,从而避免同一时间戳内的数据被跳过。
CREATE TEMPORARY TABLE sync_demo_orders (
    id BIGINT PRIMARY KEY,
    status VARCHAR(20) NOT NULL,
    updated_at DATETIME(6) NOT NULL
);

INSERT INTO sync_demo_orders (id, status, updated_at) VALUES
(1001, 'PAID', '2026-08-03 09:00:00.000000'),
(1002, 'REFUNDED', '2026-08-03 09:00:00.000000'),
(1003, 'PAID', '2026-08-03 09:00:01.000000');

SET @last_sync_time = '2026-08-03 09:00:00.000000';
SET @last_id = 1001;

SELECT id, status, updated_at
FROM sync_demo_orders
WHERE updated_at > @last_sync_time
   OR (updated_at = @last_sync_time AND id > @last_id)
ORDER BY updated_at, id
LIMIT 100;
预期结果
+------+----------+----------------------------+
| id   | status   | updated_at                 |
+------+----------+----------------------------+
| 1002 | REFUNDED | 2026-08-03 09:00:00.000000 |
| 1003 | PAID     | 2026-08-03 09:00:01.000000 |
+------+----------+----------------------------+
批次成功写入 Elasticsearch 后,再把最后一行的 updated_at 和 id 保存为新游标。若批次失败,不推进游标,重跑时依靠固定文档 ID 覆盖旧值。
验收同步结果
同步任务至少要记录批次范围、读取条数、成功条数、失败条数、当前游标和处理耗时。监控不能只看任务是否启动,还要关注数据库与索引的数量差异、关键字段差异和同步延迟。
删除数据应有明确策略:使用软删除字段时,同步任务把文档删除或标记为不可搜索;使用 CDC 时消费删除事件。定期抽样比对源数据与索引,可以尽早发现长期漂移。
本课总结
- 全量、增量、双写和 CDC 分别在实时性、耦合度与运维成本之间做取舍
- 日常同步方案之外,仍应保留可验证、可切换的全量重建能力
- 增量任务应使用复合游标、幂等写入和失败重试保证边界安全
下一课预告
下一课将进入 Elasticsearch 写入端,创建 Ingest Pipeline,并在文档入库前完成字段清洗、类型转换和默认值补充。