
NoSQL 与搜索 / 系统课时
集群健康故障排查
集群健康故障排查
当集群出现黄色或红色状态时,本课将用“健康状态 → 未分配分片 → 分配解释 → 日志与磁盘 → 修复验证”的顺序定位问题,避免一上来就重启节点或强制分配分片。
学习目标
- 能区分
green、yellow、red对业务可用性的影响。 - 能使用分片列表和分配解释 API 找到未分配原因。
- 能依据磁盘、节点日志和分配规则选择安全修复方式。
从健康状态确定影响范围
green 表示主分片和副本都已分配;yellow 通常表示主分片可用但至少一个副本未分配;red 表示至少一个主分片未分配,相关索引可能无法完整读写。先看索引级状态,不要只盯着集群总状态。
curl -s "http://<HOST>:9200/_cluster/health?level=indices&filter_path=status,unassigned_shards,active_primary_shards,indices.*.status,indices.*.unassigned_shards"预期结果:HTTP 200,响应体如下。
{"status":"yellow","active_primary_shards":5,"unassigned_shards":1,"indices":{"orders-v1":{"status":"yellow","unassigned_shards":1}}}<HOST> 替换为实际节点地址;数字会随集群变化。黄色状态下应继续确认未分配的是副本还是主分片,红色状态则优先保护数据并检查主分片来源。
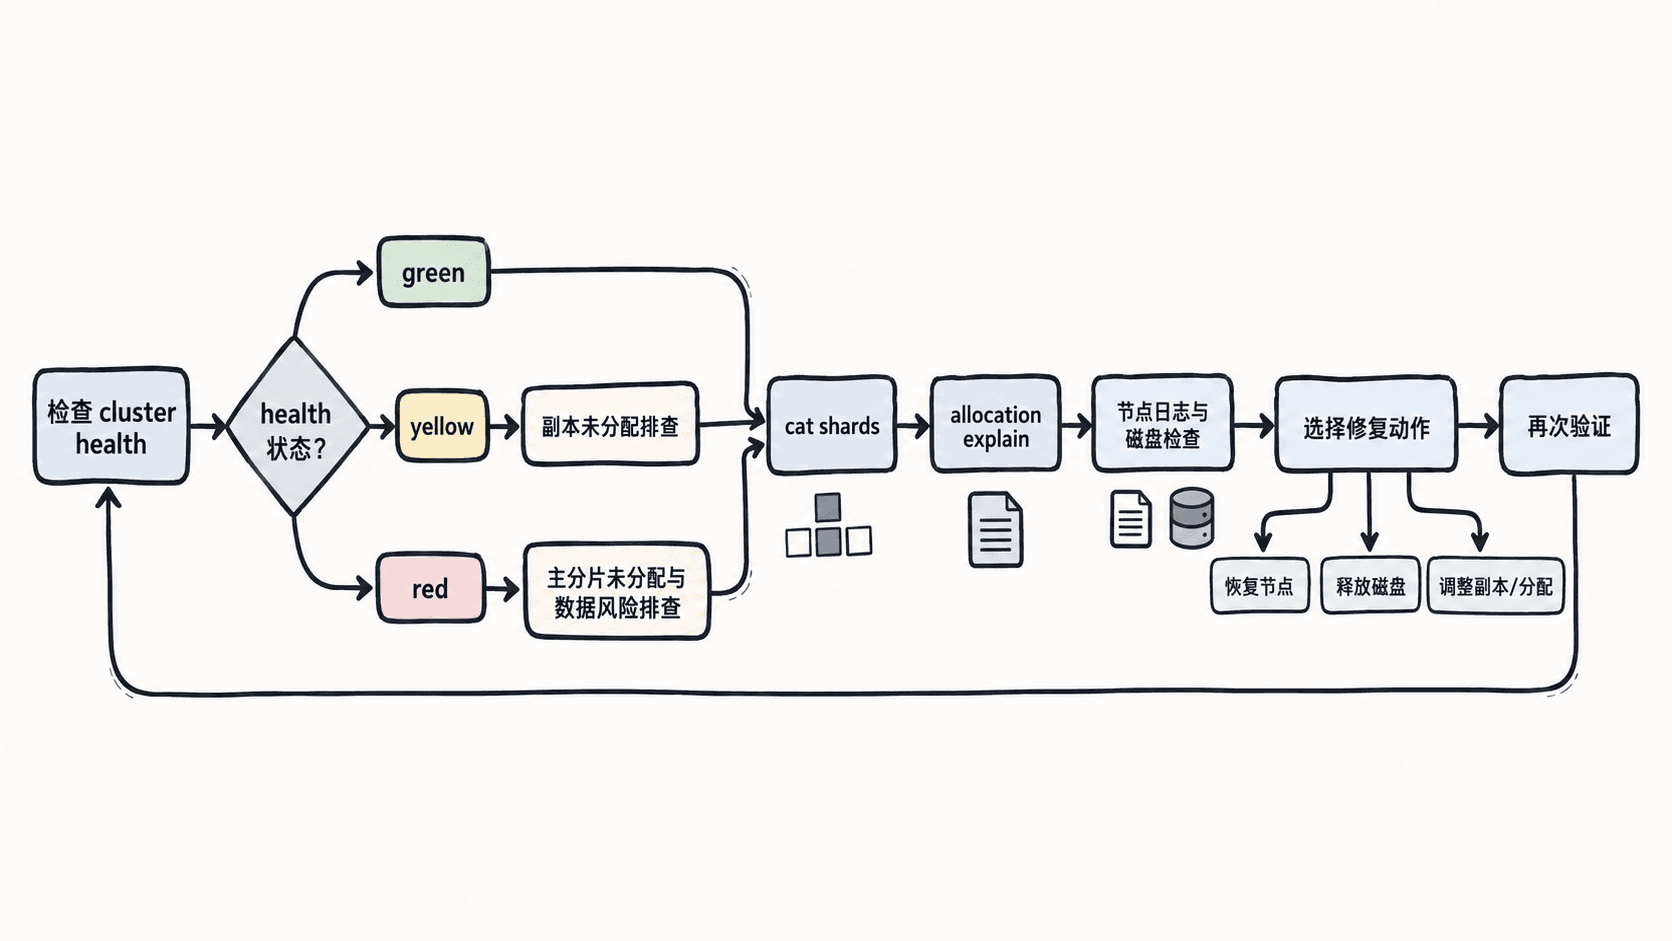
用分片列表锁定对象
通过 _cat/shards 找出 UNASSIGNED 行,重点记录索引名、分片号、p 或 r 类型以及未分配原因。p 代表主分片,r 代表副本。
curl -s "http://<HOST>:9200/_cat/shards?v&h=index,shard,prirep,state,unassigned.reason,node" | grep UNASSIGNED预期结果:HTTP 200,响应体如下。
orders-v1 0 r UNASSIGNED NODE_LEFT若没有输出,说明当前没有未分配分片;此时应转向慢查询、线程池拒绝或节点抖动等问题,而不是继续做分片分配排查。
用分配解释确认根因
将索引、分片号和主副本类型传给 _cluster/allocation/explain。结果中的 can_allocate 给出总体判断,deciders 列出每个分配规则的具体理由。
curl -s -X POST "http://<HOST>:9200/_cluster/allocation/explain" \
  -H "Content-Type: application/json" \
  -d '{
    "index": "orders-v1",
    "shard": 0,
    "primary": false
  }'
预期结果:HTTP 200,响应体如下。
{"index":"orders-v1","shard":0,"primary":false,"current_state":"unassigned","can_allocate":"no","allocate_explanation":"Elasticsearch cannot allocate this shard to any node in the cluster.","node_allocation_decisions":[{"node_name":"es-data-1","deciders":[{"decider":"disk_threshold","decision":"NO","explanation":"the node is above the low watermark"}]}]}常见根因包括磁盘水位超限、同一分片副本不能与主分片位于同一节点、节点角色不匹配、分配过滤条件冲突,以及副本数大于可用数据节点数。应修复根因,不要只复制一条强制分配命令。
结合日志和磁盘选择修复
先确认节点是否有足够磁盘,并从 Elasticsearch 日志中搜索分片、磁盘水位、断连和异常退出记录。
df -h
journalctl -u elasticsearch --since "<TIME>" | grep -E "watermark|shard|disconnect|exception"
预期输出
Filesystem      Size  Used Avail Use% Mounted on
/dev/sda1       <SIZE> <USED> <FREE> <PERCENT> /
<TIME> WARN ... disk usage exceeded flood-stage watermark ...<TIME>、容量和百分比以实际环境为准。若磁盘超限,应先清理无用索引、扩容或迁移分片;若只有一个数据节点却配置了副本,可把副本数临时调为 0;若节点离线,应先恢复原节点或确认已有可靠快照。主分片丢失时,强制分配陈旧副本可能造成数据回退,必须在明确接受数据损失后才使用。
修复后验证闭环
修复后先等待集群恢复到至少黄色,再检查是否仍有未分配分片。生产环境通常还应观察一段时间的节点日志和磁盘趋势,确认问题没有立即复发。
curl -s "http://<HOST>:9200/_cluster/health?wait_for_status=yellow&timeout=30s&filter_path=status,timed_out,unassigned_shards"预期结果:HTTP 200,响应体如下。
{"status":"green","timed_out":false,"unassigned_shards":0}如果仍为黄色,可再次执行分配解释,确认剩余问题是否只是副本不足;如果仍为红色,不要继续写入高风险索引,应优先恢复主分片或从快照重建。
本课总结
- 健康状态只说明结果,真正的根因要从未分配分片和分配解释中确认。
- 磁盘水位、节点离线、角色限制和副本数不匹配是最常见的未分配原因。
- 修复后必须重新检查健康状态、未分配数量和日志,形成验证闭环。
下一课预告
下一课将从字段映射、分片设计、写入方式、查询结构和缓存命中五个层面建立 Elasticsearch 性能优化方案。