
NoSQL 与搜索 / 系统课时
搜索建议
搜索建议
搜索建议用于在用户输入存在拼写错误时给出更可能的查询词。本课将建立可运行的索引,同时调用 term 与 phrase suggester,观察候选词如何生成、逐词排序以及如何结合上下文选出整句修正。
学习目标
- 区分
termsuggester 与phrasesuggester 的输出粒度 - 理解编辑距离候选、词频排序与 n-gram 句子评分
- 配置候选范围,避免建议过多、过慢或缺乏相关性
两类建议解决什么问题
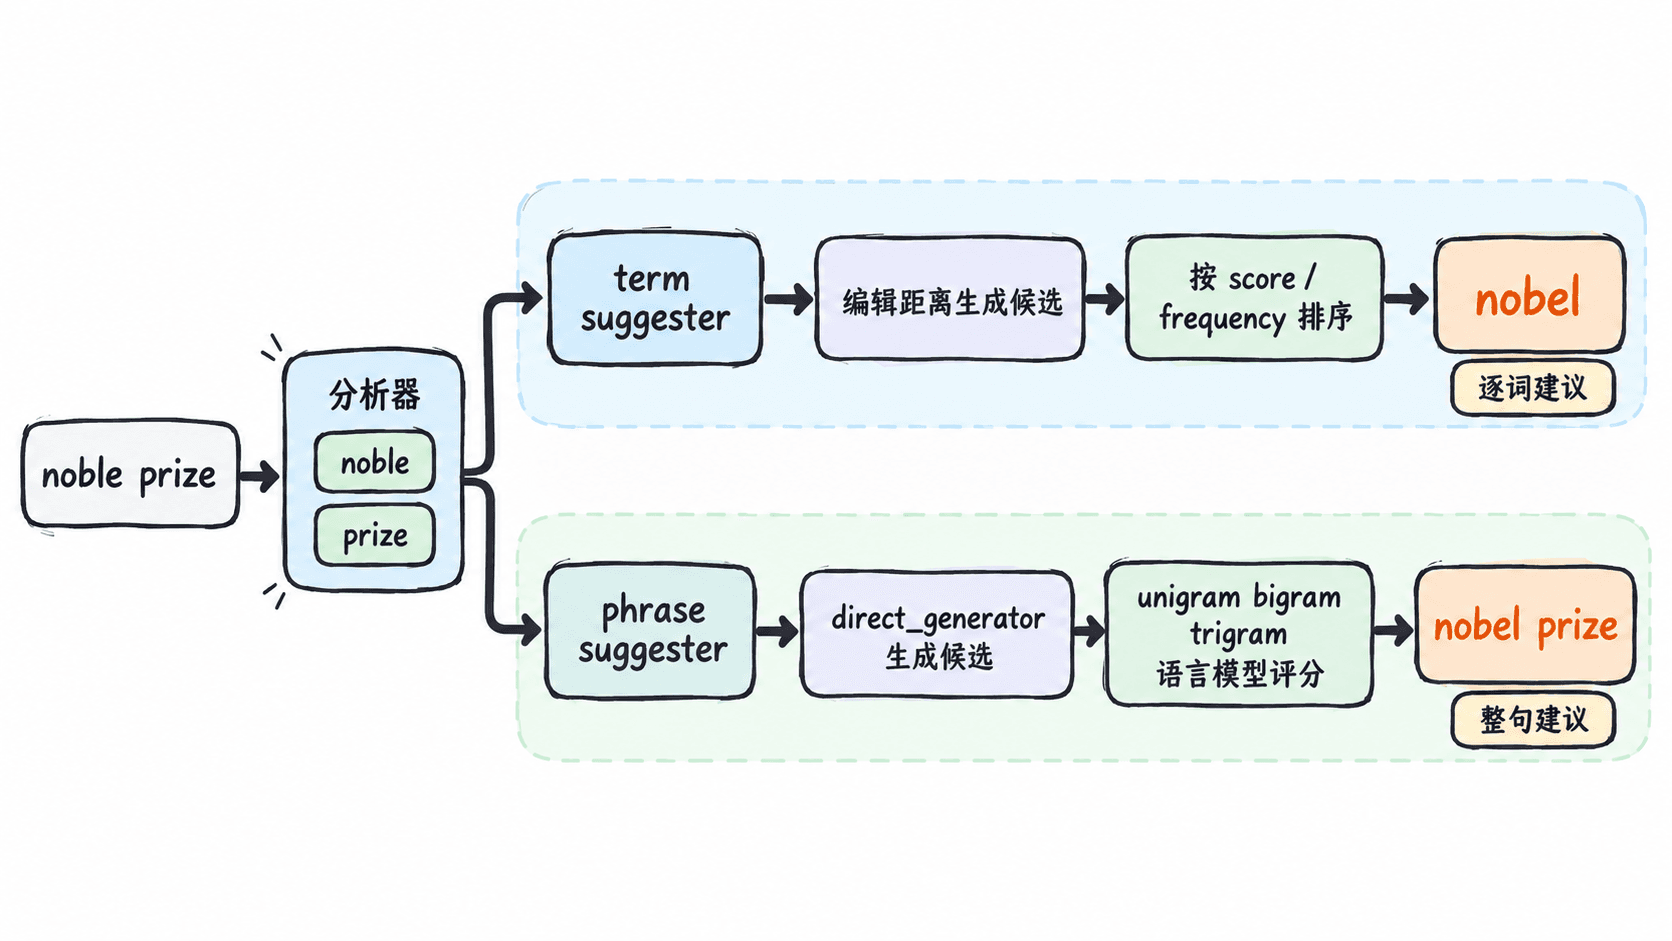
term suggester 会先分析输入文本,再对每个词元独立查找相似词。它适合展示逐词纠错候选,但不会判断多个候选组合成一句话后是否自然。
phrase suggester 会先为各词元生成候选,再利用相邻词的共现统计为完整短语评分。它更适合实现“你是不是想搜”一类整句纠错,但需要提前索引 shingle 形式的二元和三元词组。
准备建议索引
下面建立单分片索引,减少示例中分片词频差异。title.trigram 使用 shingle 过滤器,同时保留单词、二元词组和三元词组,供短语模型统计上下文。
curl -sS -w '\nHTTP_STATUS:%{http_code}\n' -X PUT 'http://localhost:9200/articles-suggest?filter_path=acknowledged' -H 'Content-Type: application/json' -d '{
  "settings": {
    "number_of_shards": 1,
    "analysis": {
      "filter": {
        "trigram_shingle": {
          "type": "shingle",
          "min_shingle_size": 2,
          "max_shingle_size": 3
        }
      },
      "analyzer": {
        "trigram": {
          "type": "custom",
          "tokenizer": "standard",
          "filter": ["lowercase", "trigram_shingle"]
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "title": {
        "type": "text",
        "fields": {
          "trigram": {
            "type": "text",
            "analyzer": "trigram"
          }
        }
      }
    }
  }
}'

curl -sS -w '\nHTTP_STATUS:%{http_code}\n' -X POST 'http://localhost:9200/articles-suggest/_bulk?refresh=true&filter_path=items.*.result' -H 'Content-Type: application/x-ndjson' --data-binary $'{"index":{"_id":"1"}}\n{"title":"nobel prize winners"}\n{"index":{"_id":"2"}}\n{"title":"nobel prize history"}\n{"index":{"_id":"3"}}\n{"title":"noble gases"}\n'
预期结果
{"acknowledged":true}
HTTP_STATUS:200
{"items":[{"index":{"result":"created"}},{"index":{"result":"created"}},{"index":{"result":"created"}}]}
HTTP_STATUS:200
同时请求逐词与整句建议
请求中的输入是 noble prize。term_by_token 按文档频率优先排列相似词;phrase_correction 把候选词放回完整短语中评分,并用标签标出发生变化的部分。
curl -sS -w '\nHTTP_STATUS:%{http_code}\n' -X POST 'http://localhost:9200/articles-suggest/_search?filter_path=suggest' -H 'Content-Type: application/json' -d '{
  "suggest": {
    "term_by_token": {
      "text": "noble prize",
      "term": {
        "field": "title",
        "suggest_mode": "always",
        "sort": "frequency",
        "size": 3,
        "max_edits": 2
      }
    },
    "phrase_correction": {
      "text": "noble prize",
      "phrase": {
        "field": "title.trigram",
        "gram_size": 3,
        "size": 1,
        "confidence": 0,
        "direct_generator": [
          {
            "field": "title.trigram",
            "suggest_mode": "always",
            "min_word_length": 1
          }
        ],
        "highlight": {
          "pre_tag": "<mark>",
          "post_tag": "</mark>"
        }
      }
    }
  }
}'
预期输出
HTTP_STATUS:200
term_by_token:
  输入词 noble 的候选中包含 nobel,freq 为 2
  输入词 prize 通常没有需要替换的高频候选
phrase_correction:
  排名第一的 text 为 nobel prize
  highlighted 为 <mark>nobel</mark> prize
  score 的具体小数可能因 Elasticsearch 版本而不同
实际响应会为每个输入词返回 text、offset、length 和 options。逐词建议的 score 表示字符串相似度;短语建议的 score 表示候选短语在语言模型下的相对得分,二者不能直接比较。
候选生成与排序参数
term suggester 的 suggest_mode 决定何时产生候选:missing 只处理索引中不存在的词,popular 只返回比原词更常见的候选,always 则尽可能生成候选。生产环境通常从 missing 或 popular 开始,减少无意义修正。
sort 设为 score 时优先考虑字符串相似度,再参考文档频率;设为 frequency 时优先返回更常见的词。max_edits 只能取 1 或 2,值越大候选越多、计算成本也越高。提高 prefix_length 可以减少候选搜索范围,但会漏掉开头拼错的输入。
phrase suggester 的 direct_generator 负责逐词生成候选,gram_size 应与字段中的最大 shingle 大小一致。confidence 控制候选必须比原短语好多少;设为 0 便于调试,线上应结合样本逐步提高,避免把正确输入强行改写。
边界与选型
搜索建议依赖索引中已有词项和频率,因此冷启动、专业缩写或低频专有名词可能得不到理想候选。应使用真实查询日志和业务词典构造测试集,分别统计有错输入的召回率与正确输入的误改率。
term 和 phrase 都面向拼写纠错,不是输入即搜的自动补全。自动补全通常使用 completion suggester 或前缀检索。多分片索引中的候选频率先在分片内计算,结果不稳定时可适当提高 shard_size,但要同时观察延迟和响应体大小。
本课总结
termsuggester 按词元生成相似候选,适合逐词纠错phrasesuggester 结合候选与 n-gram 上下文,适合返回完整短语修正- 候选质量由词频、编辑距离、分词方式和语料共同决定,参数必须用真实错词样本验证
下一课预告
接下来可以继续学习自动补全,比较 completion suggester 与前缀查询在响应速度、内存占用和结果控制上的差异。