
NoSQL 与搜索 / 系统课时
多字段搜索
多字段搜索
本课完成一个可运行的多字段检索示例:同一关键词同时搜索标题、摘要和正文,并通过字段权重让标题命中更重要。完成后,你能选择合适的 multi_match 类型并验证排序结果。
学习目标
- 使用
multi_match同时查询多个文本字段 - 通过
^设置字段相对权重 - 根据字段含义选择
best_fields、most_fields或cross_fields
multi_match 与字段权重
multi_match 可以看作对多个字段发起匹配查询,再按指定类型合并各字段得分。最常见的写法是在 fields 中列出字段,并用 title^4 这样的语法将标题权重设置为普通字段的 4 倍。
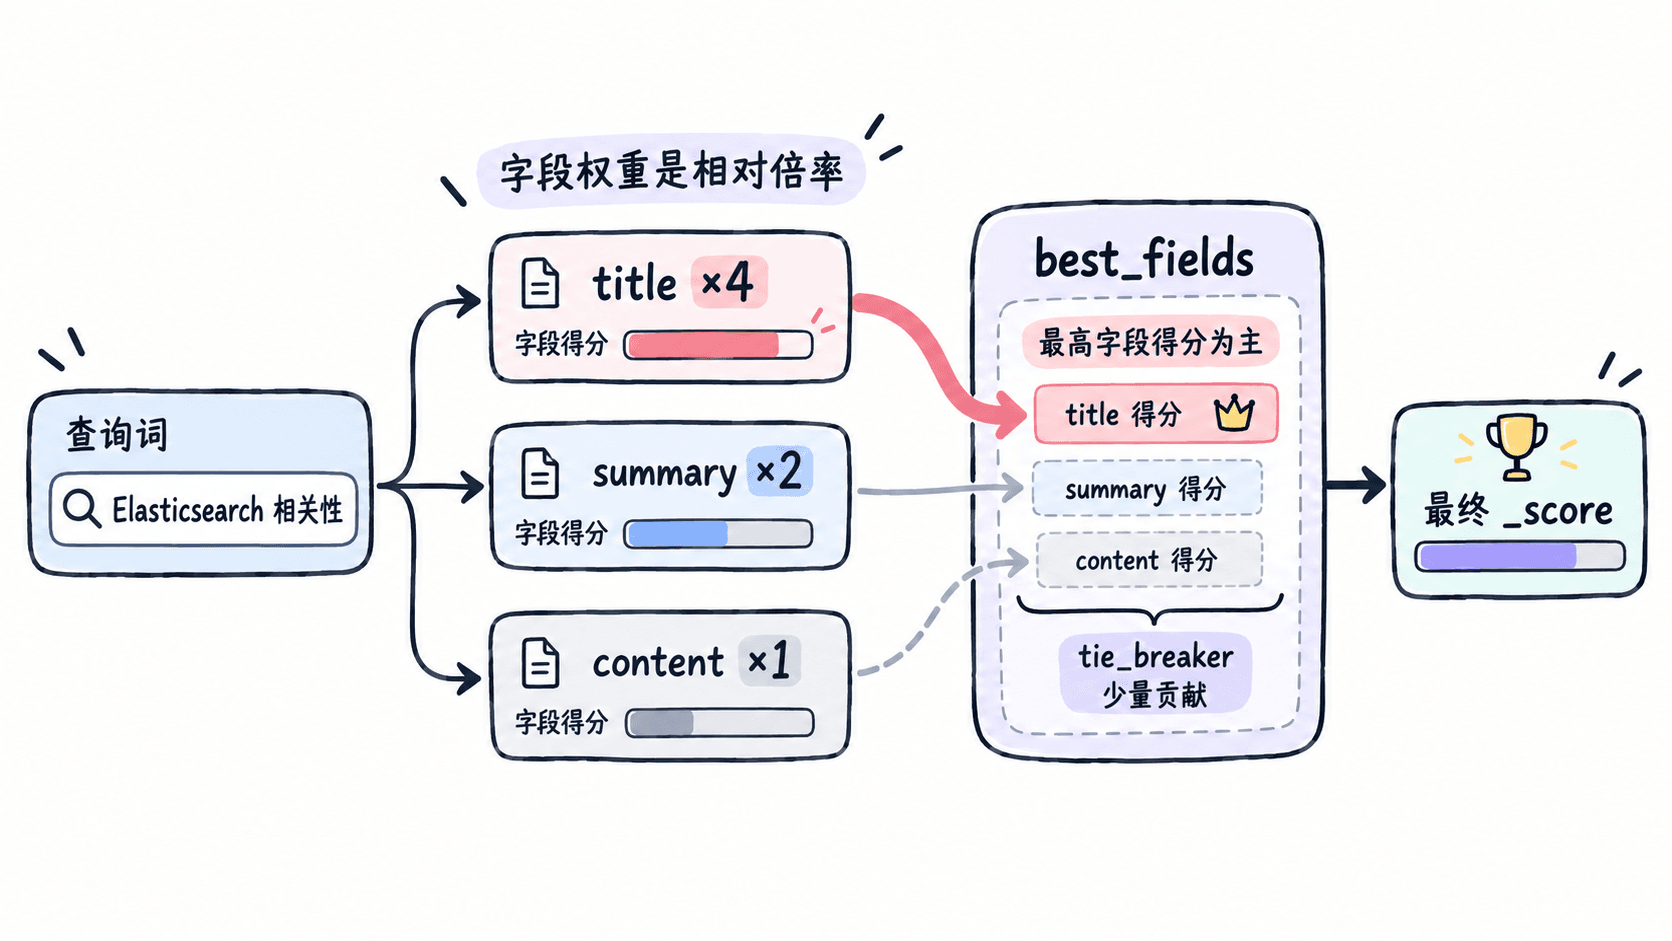
字段权重不会保证某个字段命中后一定排第一,它只是放大该字段产生的相关性贡献。最终排序仍受分词结果、词频、逆文档频率、字段长度以及其他查询条件影响。
构建并执行主示例
下面的请求可直接粘贴到 Kibana Dev Tools。示例创建索引、写入两篇文档,再使用 multi_match 查询三个字段。
PUT article_search_demo
{
  "mappings": {
    "properties": {
      "title": {
        "type": "text"
      },
      "summary": {
        "type": "text"
      },
      "content": {
        "type": "text"
      }
    }
  }
}

POST article_search_demo/_bulk
{"index":{"_id":"1"}}
{"title":"Elasticsearch 相关性评分","summary":"介绍 BM25 的核心因素","content":"学习词频、逆文档频率和字段长度归一化"}
{"index":{"_id":"2"}}
{"title":"搜索系统入门","summary":"理解 Elasticsearch 查询流程","content":"相关性通常由 BM25 模型计算"}

POST article_search_demo/_refresh

GET article_search_demo/_search
{
  "query": {
    "multi_match": {
      "query": "Elasticsearch 相关性",
      "fields": [
        "title^4",
        "summary^2",
        "content"
      ],
      "type": "best_fields",
      "tie_breaker": 0.2
    }
  }
}
预期结果:
创建索引:HTTP 200
批量写入:HTTP 200,errors=false
刷新索引:HTTP 200
搜索请求:HTTP 200
hits.hits[0]._id: "1"
hits.hits[0]._score: <SCORE_1>
hits.hits[1]._id: "2"
hits.hits[1]._score: <SCORE_2>
且 <SCORE_1> 大于 <SCORE_2>
文档 1 的标题同时包含两个查询词,并获得 title^4 的加权,因此在这组数据中应排在文档 2 之前。实际分数会随 Elasticsearch 版本、分词器和索引统计信息变化。
选择查询类型与处理边界
| 类型 | 得分合并方式 | 适用场景 |
|---|---|---|
best_fields |
以最佳匹配字段为主,可用 tie_breaker 接收其他字段的部分贡献 |
标题、摘要、正文表达相似内容 |
most_fields |
累加多个字段的匹配贡献 | 同一内容使用不同分析器或不同子字段建立索引 |
cross_fields |
将多个字段按同一逻辑文本处理 | 姓与名、品牌与型号等被拆分到多个字段的内容 |
best_fields 是通用起点。查询词可能分散在多个字段且这些字段共同组成一个语义整体时,再考虑 cross_fields。若多个字段只是同一文本的不同分析方式,例如标准分词与同义词分词,通常更适合 most_fields。
权重应先体现产品语义,再通过离线评测或真实搜索日志调整。例如标题可从 ^2 或 ^3 起步,而不是直接设置极端倍率。倍率过大可能让标题中的弱匹配压过正文中的完整匹配。
多字段查询不会自动统一各字段的分析器。若标题使用标准分词、正文使用自定义同义词分析器,同一查询词可能产生不同 Token。排查异常排序时,应先用 _analyze 验证分词,再用 _explain 查看每个字段的得分贡献。
本课总结
multi_match用一个查询同时搜索多个文本字段,并按类型合并得分field^N表示相对权重,不是固定加分,也不保证绝对排序best_fields适合通用多字段搜索,其他类型应根据字段之间的语义关系选择
下一课预告
下一课可以继续学习短语匹配与邻近度,理解词序和词间距离如何进一步影响全文检索结果。