
NoSQL 与搜索 / 系统课时
Logstash 导入关系数据
Logstash 导入关系数据
本课完成一条可运行的关系数据导入链路:Logstash 通过 JDBC 定时读取 MySQL 商品表,转换字段类型后按主键写入 Elasticsearch。完成后,你可以验证配置、启动任务,并确认检查点能够支持后续增量同步。
学习目标
- 配置 Logstash JDBC 输入和增量检查点
- 使用过滤器统一字段类型与格式
- 通过固定文档 ID 写入并验证 Elasticsearch 数据
准备数据源与导入链路
开始前需要可访问的 MySQL、Elasticsearch 和 Logstash,并把 MySQL Connector/J 驱动放到 /usr/share/logstash/config/mysql-connector-j.jar。JDBC 账号至少需要源表的 SELECT 权限,Elasticsearch 账号需要目标索引的创建和写入权限。
目标索引应提前声明关键字段类型,避免第一批数据触发错误的动态映射。下面在 Kibana Dev Tools 中创建商品索引。
PUT products
{
  "mappings": {
    "properties": {
      "id": {
        "type": "long"
      },
      "name": {
        "type": "text",
        "fields": {
          "keyword": {
            "type": "keyword",
            "ignore_above": 256
          }
        }
      },
      "category": {
        "type": "keyword"
      },
      "price": {
        "type": "double"
      },
      "updated_at": {
        "type": "date"
      }
    }
  }
}
预期输出
{
  "acknowledged": true,
  "shards_acknowledged": true,
  "index": "products"
}
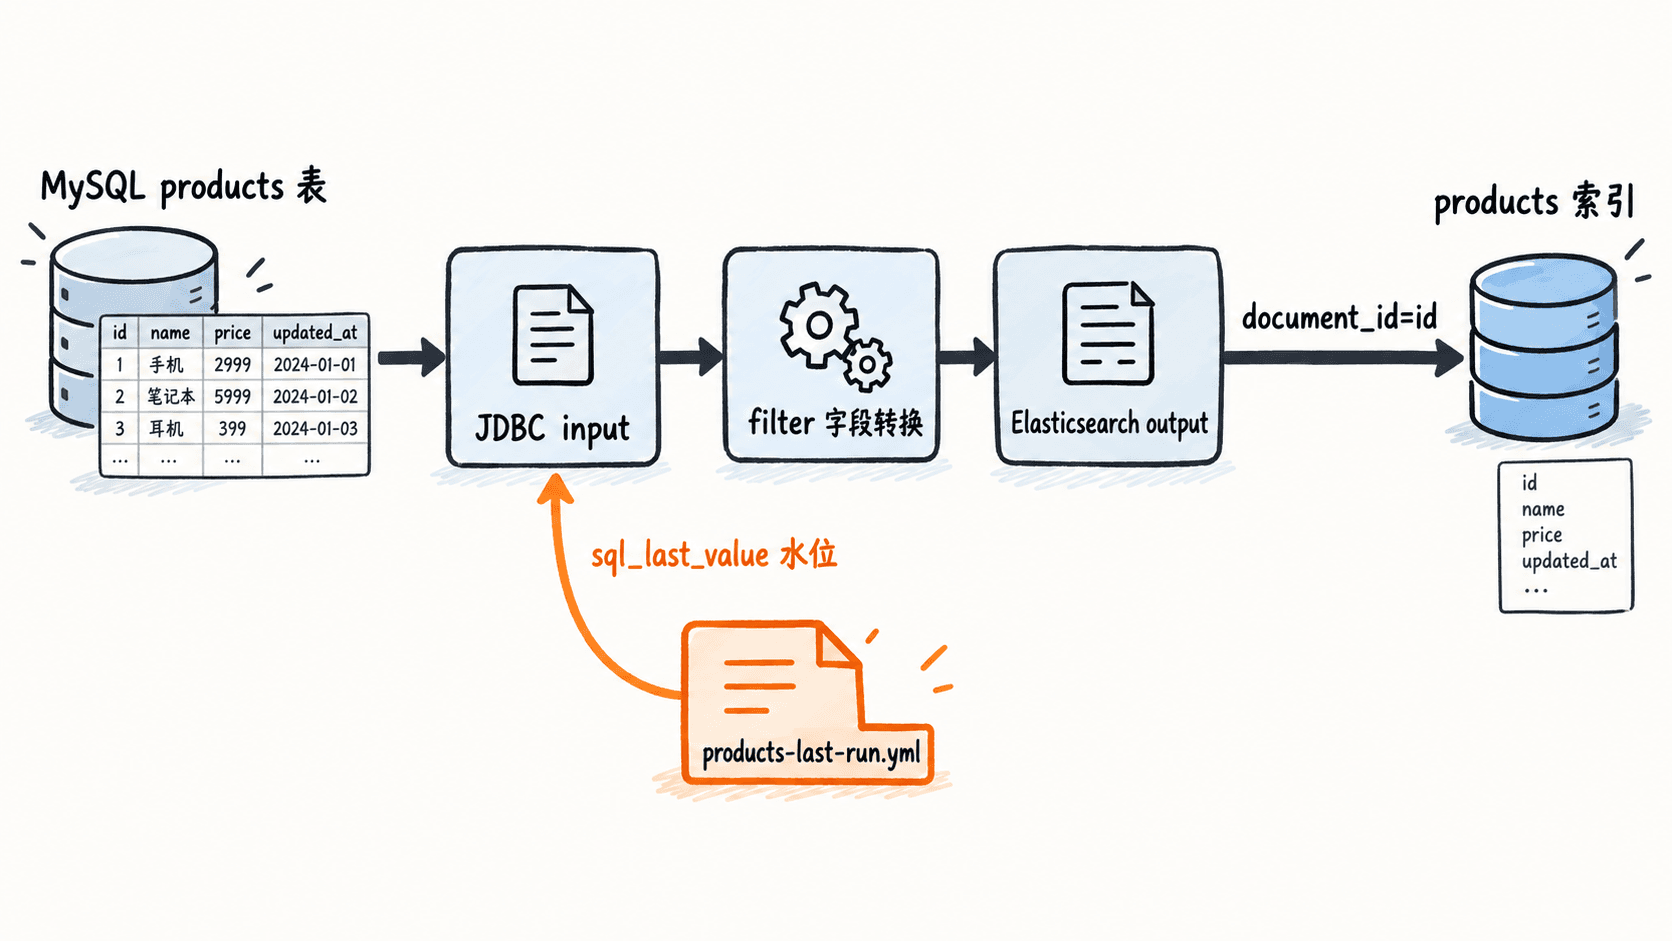
JDBC 输入负责执行 SQL,Filter 负责字段转换,Elasticsearch 输出负责写入索引。last_run_metadata_path 保存上次成功读取的水位值;下次任务把它作为 :sql_last_value 传入 SQL,从而只读取更新的数据。
编写 Logstash 配置
保存以下配置为 /usr/share/logstash/pipeline/products.conf。环境变量用于注入连接地址和密码,避免把凭据直接写入文件。
input {
  jdbc {
    jdbc_driver_library => "/usr/share/logstash/config/mysql-connector-j.jar"
    jdbc_driver_class => "com.mysql.cj.jdbc.Driver"
    jdbc_connection_string => "jdbc:mysql://${MYSQL_HOST}:3306/${MYSQL_DATABASE}?useSSL=false&serverTimezone=UTC"
    jdbc_user => "${MYSQL_USER}"
    jdbc_password => "${MYSQL_PASSWORD}"

    schedule => "* * * * *"
    statement => "SELECT id, name, category, price, updated_at FROM products WHERE updated_at > :sql_last_value ORDER BY updated_at ASC, id ASC"

    use_column_value => true
    tracking_column => "updated_at"
    tracking_column_type => "timestamp"
    last_run_metadata_path => "/usr/share/logstash/data/products-last-run.yml"

    jdbc_paging_enabled => true
    jdbc_page_size => 1000
  }
}

filter {
  mutate {
    convert => {
      "id" => "integer"
      "price" => "float"
    }
    lowercase => ["category"]
    remove_field => ["@version"]
  }

  date {
    match => ["updated_at", "ISO8601"]
    target => "updated_at"
  }
}

output {
  elasticsearch {
    hosts => ["${ES_HOSTS}"]
    index => "products"
    document_id => "%{id}"
    user => "${ES_USER}"
    password => "${ES_PASSWORD}"
    ssl_certificate_authorities => ["/usr/share/logstash/config/certs/http_ca.crt"]
  }

  stdout {
    codec => rubydebug
  }
}这份配置每分钟执行一次查询。document_id => "%{id}" 让同一数据库主键覆盖同一 Elasticsearch 文档,而不是重复新增。若开发环境使用 HTTP 且未启用安全功能,应相应删除账号、密码和 CA 配置。
验证、启动与检查增量
先设置实际环境变量,再执行语法检查。<MYSQL_PASSWORD>、<ES_PASSWORD> 等占位符必须替换为真实值。
export MYSQL_HOST="<MYSQL_HOST>"
export MYSQL_DATABASE="shop"
export MYSQL_USER="logstash_reader"
export MYSQL_PASSWORD="<MYSQL_PASSWORD>"
export ES_HOSTS="https://localhost:9200"
export ES_USER="logstash_writer"
export ES_PASSWORD="<ES_PASSWORD>"

/usr/share/logstash/bin/logstash \
  --config.test_and_exit \
  -f /usr/share/logstash/pipeline/products.conf
预期输出
<TIME> Configuration OK配置通过后启动管道。首次执行会读取符合水位条件的数据,并在终端打印转换后的事件。
/usr/share/logstash/bin/logstash \
  -f /usr/share/logstash/pipeline/products.conf
预期结果
<TIME> Pipeline started
{
            "id" => 101,
          "name" => "Wireless Mouse",
      "category" => "accessories",
         "price" => 19.9,
    "updated_at" => <TIME>
}
实际记录数量、字段值和时间会随数据库内容变化。若终端没有事件,优先检查 SQL 是否返回数据、检查点文件中的水位是否过新,以及 JDBC 账号是否具有读取权限。
导入后查询目标索引,确认主键、类型和字段格式正确。
GET products/_search
{
  "size": 1,
  "sort": [
    {
      "updated_at": "desc"
    }
  ],
  "_source": [
    "id",
    "name",
    "category",
    "price",
    "updated_at"
  ]
}
预期结果
HTTP 200
hits.hits 中返回最近更新的一条商品文档;id 为数值,category 为小写关键字,price 为浮点数,updated_at 为日期。
updated_at > :sql_last_value 要求时间字段可靠递增。若多条记录可能共享同一时间戳,生产环境应使用单调递增的版本号作为水位,或设计能够同时比较时间和主键的同步方案。源表删除也不会自动删除 Elasticsearch 文档,需要软删除字段或独立的删除同步流程。
本课总结
- JDBC 输入通过
:sql_last_value和检查点文件实现增量读取 - Filter 统一字段类型,固定
document_id避免重复文档 - 正式运行前应先验证映射、配置语法、首批数据和增量边界
下一课预告
下一课将继续完善同步链路,处理断点续传、重复写入、删除传播和失败重试等生产环境问题。