
NoSQL 与搜索 / 系统课时
查看集群运行状态
查看集群运行状态
本课建立一套可重复的 Elasticsearch 巡检顺序:先确认服务可访问,再检查集群健康、节点角色和分片分配。完成后,你能够区分正常的单节点黄色状态与真正的数据不可用问题,并快速确定下一步应查看哪个接口。
学习目标
- 使用集群健康、节点和分片接口完成基础巡检
- 正确理解
green、yellow、red三种健康状态 - 根据未分配分片和主节点信息确定排查方向
按层检查集群
一次有效巡检应按“服务响应 → 集群健康 → 节点状态 → 分片位置”的顺序进行。这样可以避免看到 yellow 就直接重启节点,也能区分连接失败、主节点异常和副本不足。
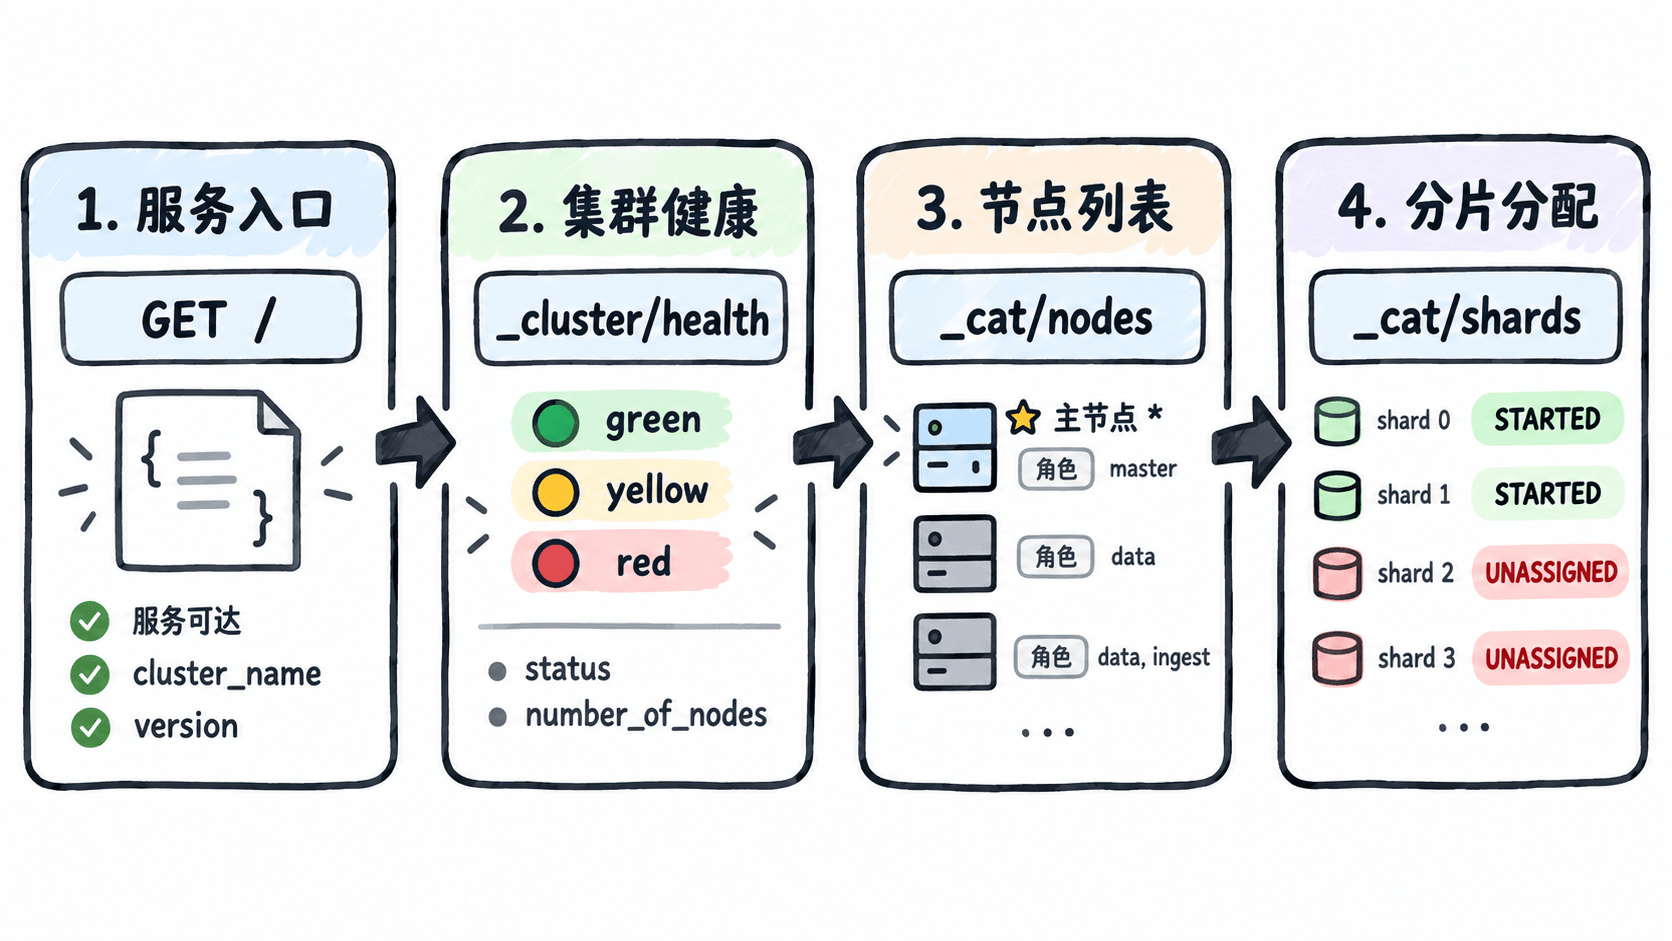
下文以关闭安全功能的本地实验环境 http://localhost:9200 为例。若集群启用了安全功能,应改用 HTTPS,并为 curl 增加 -u elastic:<PASSWORD> 和 --cacert <PATH>。
ES_URL=${ES_URL:-http://localhost:9200}

curl -fsS "$ES_URL/"
curl -fsS "$ES_URL/_cluster/health?pretty"
curl -fsS "$ES_URL/_cat/nodes?v&h=name,ip,node.role,master,cpu,heap.percent,ram.percent"
curl -fsS "$ES_URL/_cat/shards?v&h=index,shard,prirep,state,node,unassigned.reason"
预期结果如下,节点名、版本、地址和资源占用会因环境不同而变化。
{
  "name": "<NODE_NAME>",
  "cluster_name": "<CLUSTER_NAME>",
  "cluster_uuid": "<CLUSTER_UUID>",
  "version": {
    "number": "<VERSION>"
  }
}

{
  "cluster_name": "<CLUSTER_NAME>",
  "status": "<STATUS>",
  "number_of_nodes": <NODE_COUNT>,
  "active_primary_shards": <PRIMARY_COUNT>,
  "unassigned_shards": <UNASSIGNED_COUNT>
}

name        ip          node.role  master  cpu  heap.percent  ram.percent
<NODE_NAME> <NODE_IP>   <ROLES>    <*>     <N>  <N>           <N>

index        shard  prirep  state       node         unassigned.reason
<INDEX_NAME> <N>    <p|r>   <STATE>     <NODE_NAME>  <REASON>
第一条请求证明 HTTP 服务可访问,并返回当前响应节点与集群标识。后续三个接口分别回答“集群整体是否可用”“有哪些节点在工作”“每个主分片和副本位于哪里”。
读懂健康状态
| 状态 | 含义 | 处理重点 |
|---|---|---|
green |
所有主分片和副本都已分配 | 继续关注资源占用和任务积压 |
yellow |
主分片可用,但至少一个副本未分配 | 检查节点数量、副本数和分配规则 |
red |
至少一个主分片未分配 | 优先确认受影响索引和数据可用性 |
单节点集群出现 yellow 很常见:索引若配置了一个副本,Elasticsearch 不会把副本放到与主分片相同的节点,因此副本只能保持未分配。此时数据仍可查询,但节点故障后没有副本接管。
unassigned_primary_shards 大于零比普通的 unassigned_shards 更紧急;number_of_pending_tasks 持续增长则说明集群状态更新可能发生阻塞。健康颜色只是入口,不能代替节点与分片检查。
从节点下钻到分片
在节点表中,master 列的 * 表示当前当选主节点,node.role 展示节点承担的角色。CPU、堆内存和系统内存应结合趋势观察,单次瞬时值只能用于发现明显异常。
在分片表中,p 表示主分片,r 表示副本;正常运行的分片通常处于 STARTED。若出现 UNASSIGNED,先记录索引、分片编号和 unassigned.reason,再使用 POST /_cluster/allocation/explain 获取拒绝分配的具体原因。
CAT 接口适合人在终端中快速阅读,不应作为应用程序长期解析的稳定数据格式。自动监控应优先使用返回 JSON 的集群健康、节点信息和节点统计接口。
常见误判
yellow不等于数据已经丢失,应先判断未分配的是主分片还是副本。- 节点列表少一台时,不要只看进程;还要核对
cluster.name、发现配置和节点日志。 - 分片正在
INITIALIZING或RELOCATING时,短暂波动可能是恢复过程,应结合数量是否持续下降判断。
本课总结
- 基础巡检应按服务、集群、节点、分片四层逐步下钻。
red代表主分片不可用,yellow通常代表副本不足,两者处理优先级不同。- CAT 接口便于人工查看,程序化监控应使用结构化 JSON API。
下一课预告
下一课将用 Docker Compose 搭建三个 Elasticsearch 节点,实际观察节点加入、主节点选举以及主分片和副本在不同节点间的分配过程。