
NoSQL 与搜索 / 系统课时
解析搜索响应
解析搜索响应
本课解决 Java 客户端返回对象难以直接交给前端的问题。完成后,你能够从 SearchResponse 中安全提取命中、总数、评分、高亮和聚合结果,并组装成与 Elasticsearch 类型解耦的应用层 DTO。
学习目标
- 识别搜索响应中命中、总数、高亮和聚合的层次
- 将客户端对象转换为稳定的应用层响应结构
- 正确处理空
_source、近似总数和聚合类型不匹配
先识别响应层次
一个搜索响应至少包含执行信息、命中集合和可选聚合。每个命中又包含文档 ID、_source、评分和高亮片段;聚合结果则按请求中的名称保存,并根据聚合类型提供不同的桶或指标结构。
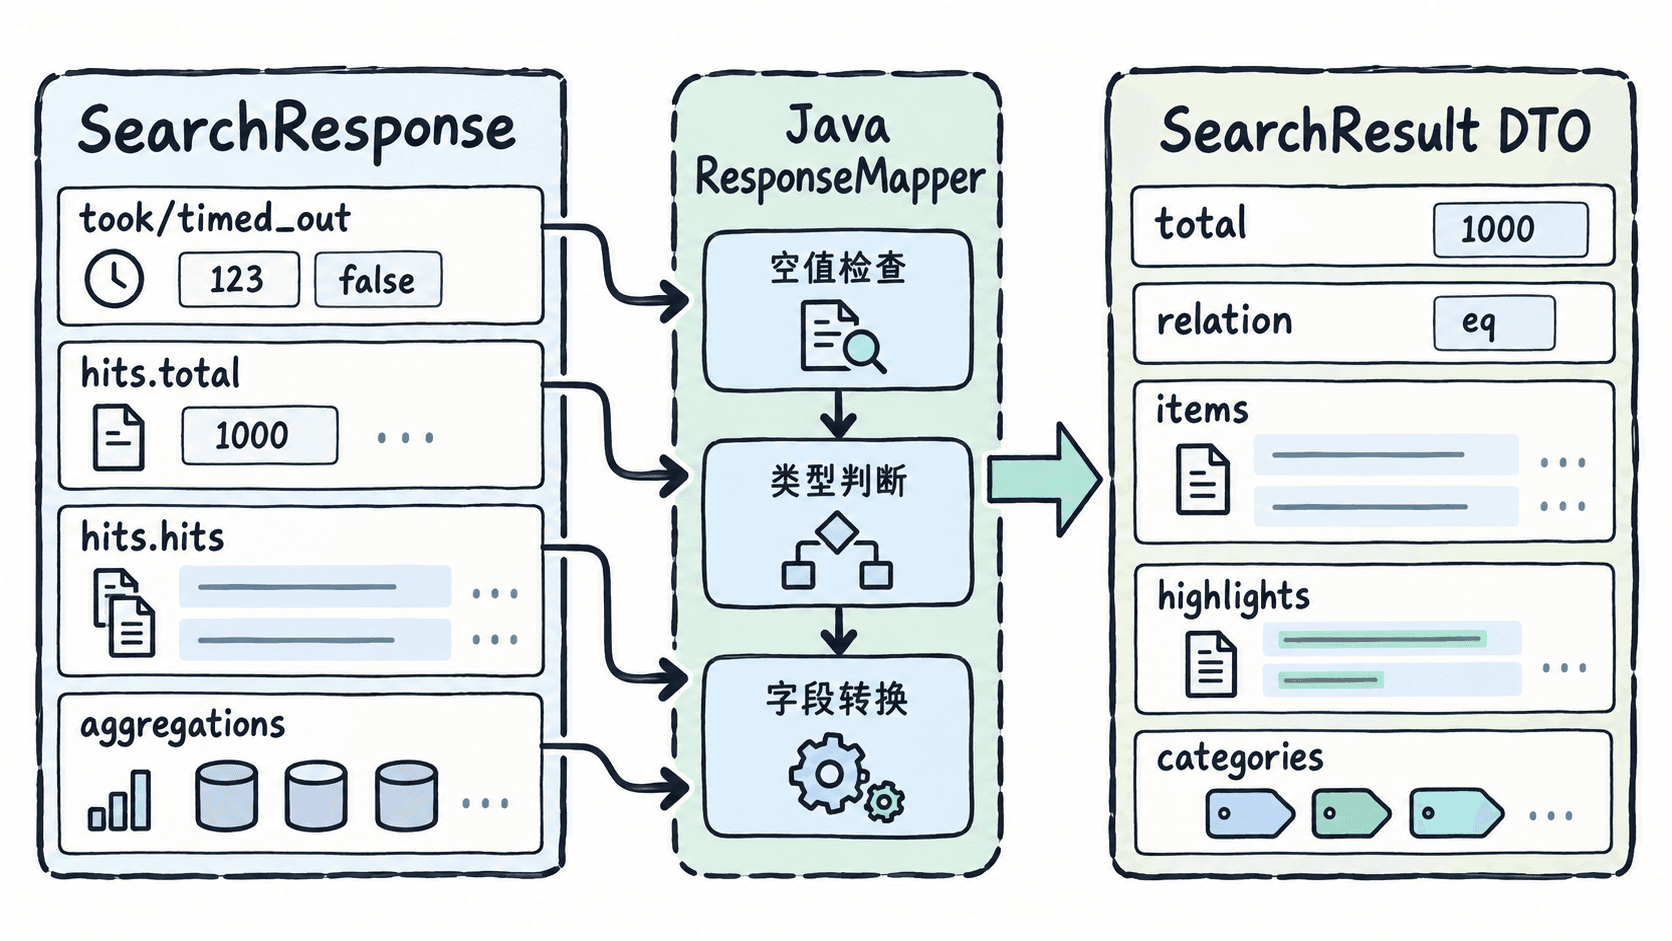
不要把整个 SearchResponse 原样返回给控制器。客户端类型会把索引细节暴露到接口层,也会让前端依赖聚合变体、总数关系等内部概念,后续升级客户端时改动范围更大。
定义并执行响应映射
下面是片段示例,依赖上一课已经执行 client.search(request, ProductDocument.class) 并获得 SearchResponse<ProductDocument>。代码完整展示 DTO 定义、命中映射、高亮提取和字符串分组聚合解析。
package example.search;

import co.elastic.clients.elasticsearch._types.aggregations.Aggregate;
import co.elastic.clients.elasticsearch._types.aggregations.StringTermsBucket;
import co.elastic.clients.elasticsearch.core.SearchResponse;
import co.elastic.clients.elasticsearch.core.search.Hit;
import co.elastic.clients.elasticsearch.core.search.TotalHits;

import java.util.ArrayList;
import java.util.List;

public final class SearchResponseMapper {

    public record ProductDocument(String name, String category, Double price) {
    }

    public record SearchItem(
            String id,
            ProductDocument source,
            Double score,
            List<String> nameHighlights,
            List<String> descriptionHighlights) {
    }

    public record BucketItem(String key, long count) {
    }

    public record SearchResult(
            long total,
            String totalRelation,
            long tookMillis,
            boolean timedOut,
            List<SearchItem> items,
            List<BucketItem> categories) {
    }

    public SearchResult map(SearchResponse<ProductDocument> response) {
        TotalHits totalHits = response.hits().total();
        long total = totalHits == null ? 0L : totalHits.value();
        String relation = totalHits == null
                ? "unknown"
                : totalHits.relation().jsonValue();

        List<SearchItem> items = response.hits().hits().stream()
                .map(SearchResponseMapper::mapHit)
                .toList();

        Aggregate categoryAggregation = response.aggregations().get("by_category");
        List<BucketItem> categories = parseStringTerms(categoryAggregation);

        return new SearchResult(
                total,
                relation,
                response.took(),
                response.timedOut(),
                items,
                categories);
    }

    private static SearchItem mapHit(Hit<ProductDocument> hit) {
        ProductDocument source = hit.source();
        if (source == null) {
            throw new IllegalStateException("_source is missing for document " + hit.id());
        }

        return new SearchItem(
                hit.id(),
                source,
                hit.score(),
                fragments(hit, "name"),
                fragments(hit, "description"));
    }

    private static List<String> fragments(Hit<?> hit, String field) {
        return List.copyOf(hit.highlight().getOrDefault(field, List.of()));
    }

    private static List<BucketItem> parseStringTerms(Aggregate aggregate) {
        if (aggregate == null || !aggregate.isSterms()) {
            return List.of();
        }

        List<BucketItem> result = new ArrayList<>();
        for (StringTermsBucket bucket : aggregate.sterms().buckets().array()) {
            result.add(new BucketItem(
                    bucket.key().stringValue(),
                    bucket.docCount()));
        }
        return List.copyOf(result);
    }
}
假设 Elasticsearch 返回一个命中文档和名为 by_category 的字符串分组聚合,映射后的预期结果如下。耗时、评分、文档 ID 和数量属于动态值,实际结果可能不同。
{
  "total": 128,
  "totalRelation": "eq",
  "tookMillis": 7,
  "timedOut": false,
  "items": [
    {
      "id": "p-1001",
      "source": {
        "name": "Java 搜索实战",
        "category": "book",
        "price": 89.0
      },
      "score": 4.23,
      "nameHighlights": [
        "<mark>Java</mark> 搜索实战"
      ],
      "descriptionHighlights": []
    }
  ],
  "categories": [
    {
      "key": "book",
      "count": 96
    }
  ]
}
应用层 DTO 只保留接口真正需要的字段。这样控制器无需理解 Hit、Aggregate 等客户端类型,单元测试也可以直接围绕映射结果编写断言。
正确解释总数、评分与高亮
hits.total 可能不存在,也可能带有 eq 或 gte 关系。eq 表示当前值是精确总数,gte 表示真实数量至少达到该值,因此接口同时返回数值和关系比只返回一个整数更准确。
评分只有在查询和排序策略需要时才有业务意义。按普通字段排序后,如果没有启用评分跟踪,评分可能不可用;应用层不应把空评分强制替换成零,否则会混淆“没有计算”和“评分为零”。
高亮是字段到片段列表的映射,一个字段可能有多个片段,也可能完全没有高亮。代码使用空列表而不是 null,能减少前端分支;其中的标签仍应按页面安全规则处理。
解析聚合并处理类型边界
聚合名称必须与请求中的名称完全一致,聚合变体也必须匹配。示例中的 by_category 是字符串 terms 聚合,因此使用 sterms();如果请求改成日期直方图或数值指标,解析器也必须改用对应变体。
解析前先判断聚合是否存在以及 isSterms() 是否成立,可以避免名称拼错或查询版本变化时直接抛出类型异常。对于业务必需的聚合,也可以把“返回空列表”改成抛出明确异常,让监控尽早发现请求与解析器不一致。
当 _source 被关闭或请求只返回部分字段时,hit.source() 可能为空。示例选择快速失败;另一种方案是改为解析 fields,但请求和 DTO 必须同时调整,不能悄悄返回内容不完整的对象。
本课总结
- 搜索响应应在服务层转换为应用 DTO,而不是直接暴露客户端对象
- 总数关系、空评分、高亮列表和空
_source都需要显式处理 - 聚合解析必须同时校验名称与类型,并与请求定义保持一致
下一课预告
下一课将把请求构建与响应解析组合进搜索服务,并补充异常转换、超时处理和可测试的接口封装。