
NoSQL 与搜索 / 系统课时
评分解释与查询分析
评分解释与查询分析
搜索结果“为什么排在这里”和“为什么查询很慢”是两个不同问题。本课分别使用 explain 查看单个文档的评分计算树,使用 profile 分析查询阶段与聚合阶段的执行开销,建立可复用的定位顺序。
学习目标
- 使用
_explainAPI 追踪单个文档的评分组成 - 使用
profile查看查询执行树和耗时明细 - 区分相关性问题与性能问题,避免选错分析工具
explain 与 profile 的分工
explain 面向一个指定文档,回答它是否匹配、每一层评分如何计算以及最终 _score 从哪里来。它适合排查字段权重、词频、布尔子句和 function_score 组合是否符合预期。
profile 面向一次完整搜索,记录查询在各分片上的执行结构、组件耗时和调用次数。它适合发现代价较高的查询子句、脚本、聚合或重写过程,但不会直接告诉你业务排序是否合理。
| 工具 | 主要问题 | 分析范围 | 典型输出 |
|---|---|---|---|
_explain |
为什么这个文档得分高或低 | 单个文档 | 匹配结果与评分解释树 |
profile |
时间花在了哪个执行阶段 | 整次搜索、逐分片 | 查询树、耗时和调用次数 |
使用 explain 拆解单文档评分
先从普通搜索结果中取得待分析文档的 _id,再把完全相同的查询提交到 /{index}/_explain/{id}。下面的 <ID> 需要替换为真实文档 ID。
GET products/_explain/<ID>
{
  "query": {
    "multi_match": {
      "query": "无线耳机",
      "fields": ["name^3", "description"]
    }
  }
}
预期结果
HTTP/1.1 200 OK
响应体包含 matched、explanation.value、explanation.description 和 details。
matched 为 true 时,details 会按树形结构展示字段权重、词频、逆文档频率等评分来源。
实际数值取决于目标文档和索引统计信息。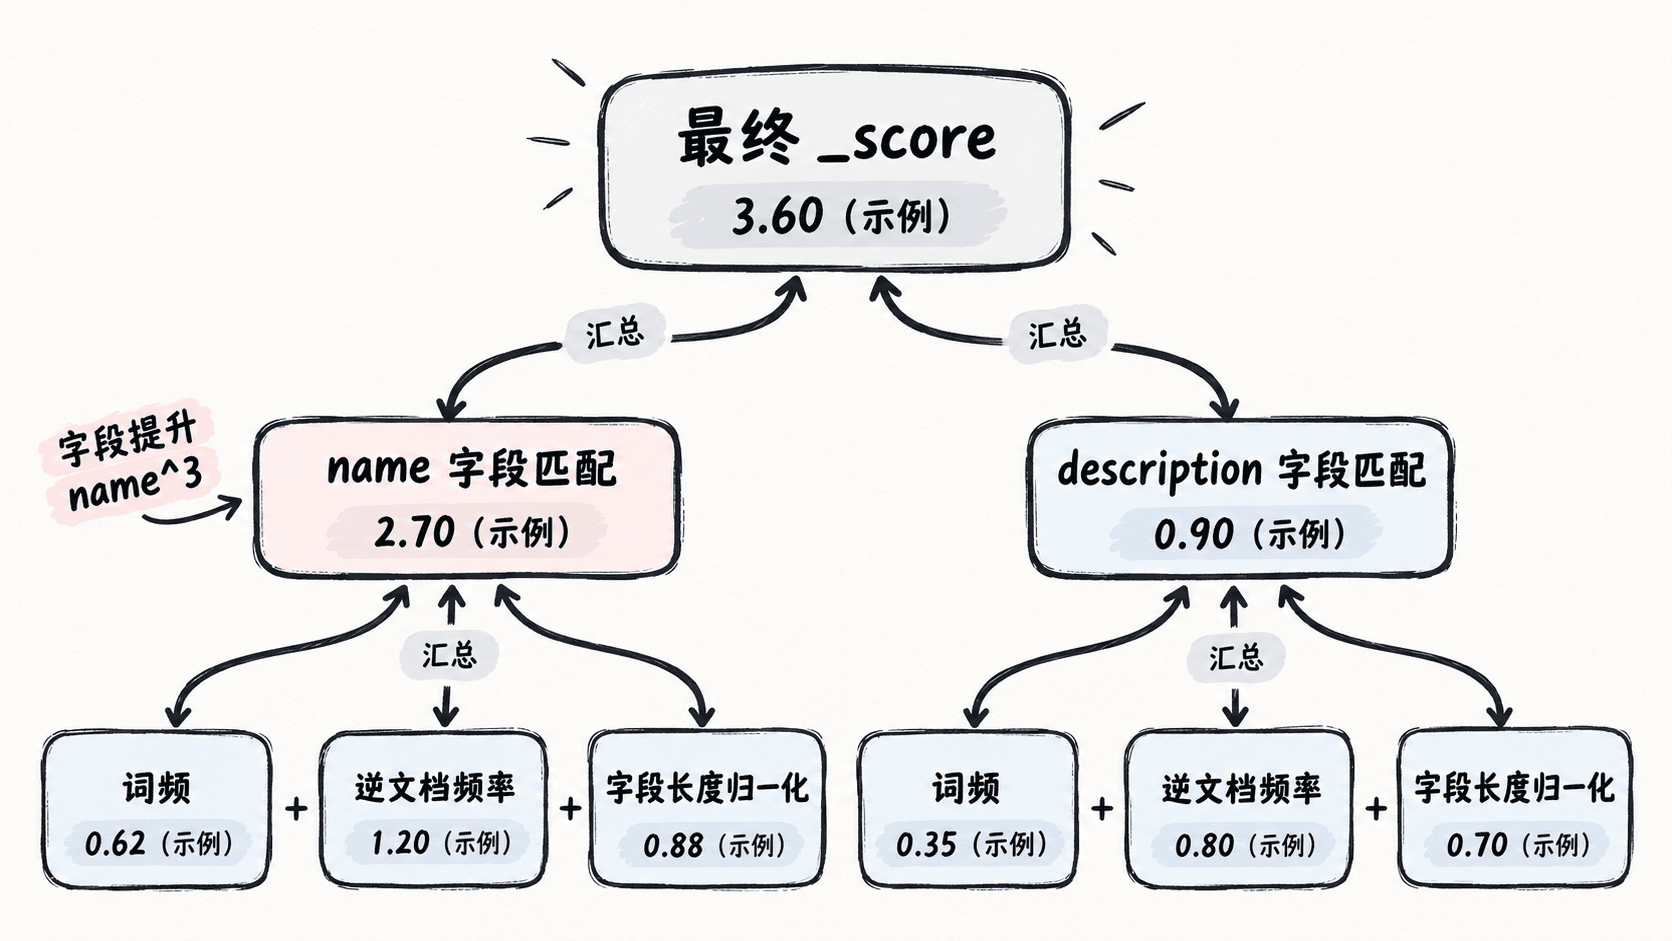
阅读解释树时从最外层开始,不要直接钻到叶节点。先确认查询类型和组合方式,再查看哪一个字段或子句贡献最大,最后检查词频、字段长度等底层统计。如果使用了 function_score,还要确认业务函数是相加、相乘还是替换了原始分数。
使用 profile 查看执行开销
在搜索请求顶层加入 "profile": true 即可启用分析。分析数据会增加额外开销,因此适合测试环境或受控请求,不应作为普通线上查询的固定配置。
POST products/_search
{
  "profile": true,
  "query": {
    "bool": {
      "must": {
        "match": {
          "name": "无线耳机"
        }
      },
      "filter": {
        "term": {
          "in_stock": true
        }
      }
    }
  }
}
预期结果
HTTP/1.1 200 OK
响应体除 hits 外,还包含 profile.shards。
每个分片下的 searches.query 会展示查询组件类型、time_in_nanos、breakdown 和 children。
实际耗时与分片数量、缓存状态、数据规模和运行环境有关。
重点先看 time_in_nanos 较高的节点,再结合 breakdown 中的调用次数判断原因。单次耗时高可能来自脚本或复杂计算;调用次数异常高则可能说明查询结构导致大量文档被访问。
一套可复用的定位顺序
发现结果不合理时,先固定索引、查询条件和目标文档,避免边调边变。确认文档是否匹配后,用 _explain 检查字段提升、布尔组合、业务函数和最终分数。
发现响应变慢时,先用普通监控确认问题确实发生在搜索请求,再对代表性请求启用 profile。从最耗时的查询节点开始缩小范围,修改后使用相同数据和相同请求重复测量。
相关性和性能可能互相影响,但不要混在同一步处理。例如,为了提权加入脚本评分后,排序更合理却变慢,此时先用 _explain 验证评分逻辑,再用 profile 判断脚本的执行成本。
常见误区与生产注意
_explain 展示的是指定文档在当前索引统计下的评分,不代表所有文档都遵循完全相同的贡献比例。分析排序问题时,应同时选取一个“应该更高”和一个“应该更低”的文档做对照。
profile 的耗时包含分析本身带来的额外成本,不能直接当作真实线上延迟。它更适合比较节点之间的相对开销,以及同一请求优化前后的结构变化。
本课总结
_explain用于回答单个文档为什么匹配以及分数如何组成profile用于定位完整搜索在各分片和执行节点上的开销- 先固定样本与请求,再分别分析相关性和性能,结论才具有可比性
下一课预告
下一课将进入相关性调优实践,把查询样本、人工标注和离线评估组合成可重复的验证流程。