
NoSQL 与搜索 / 系统课时
短语与邻近匹配
短语与邻近匹配
普通 match 查询只要求词元出现,无法保证它们保持顺序或彼此接近。本课通过一组可复现数据,掌握 match_phrase 的位置匹配逻辑,并用 slop 在精确短语和宽松邻近搜索之间取得平衡。
学习目标
- 理解
match_phrase如何依据词元位置判断短语 - 使用
slop控制词元间隔与换位容忍度 - 通过查询结果选择适合业务的邻近范围
match_phrase 判断的是词元位置
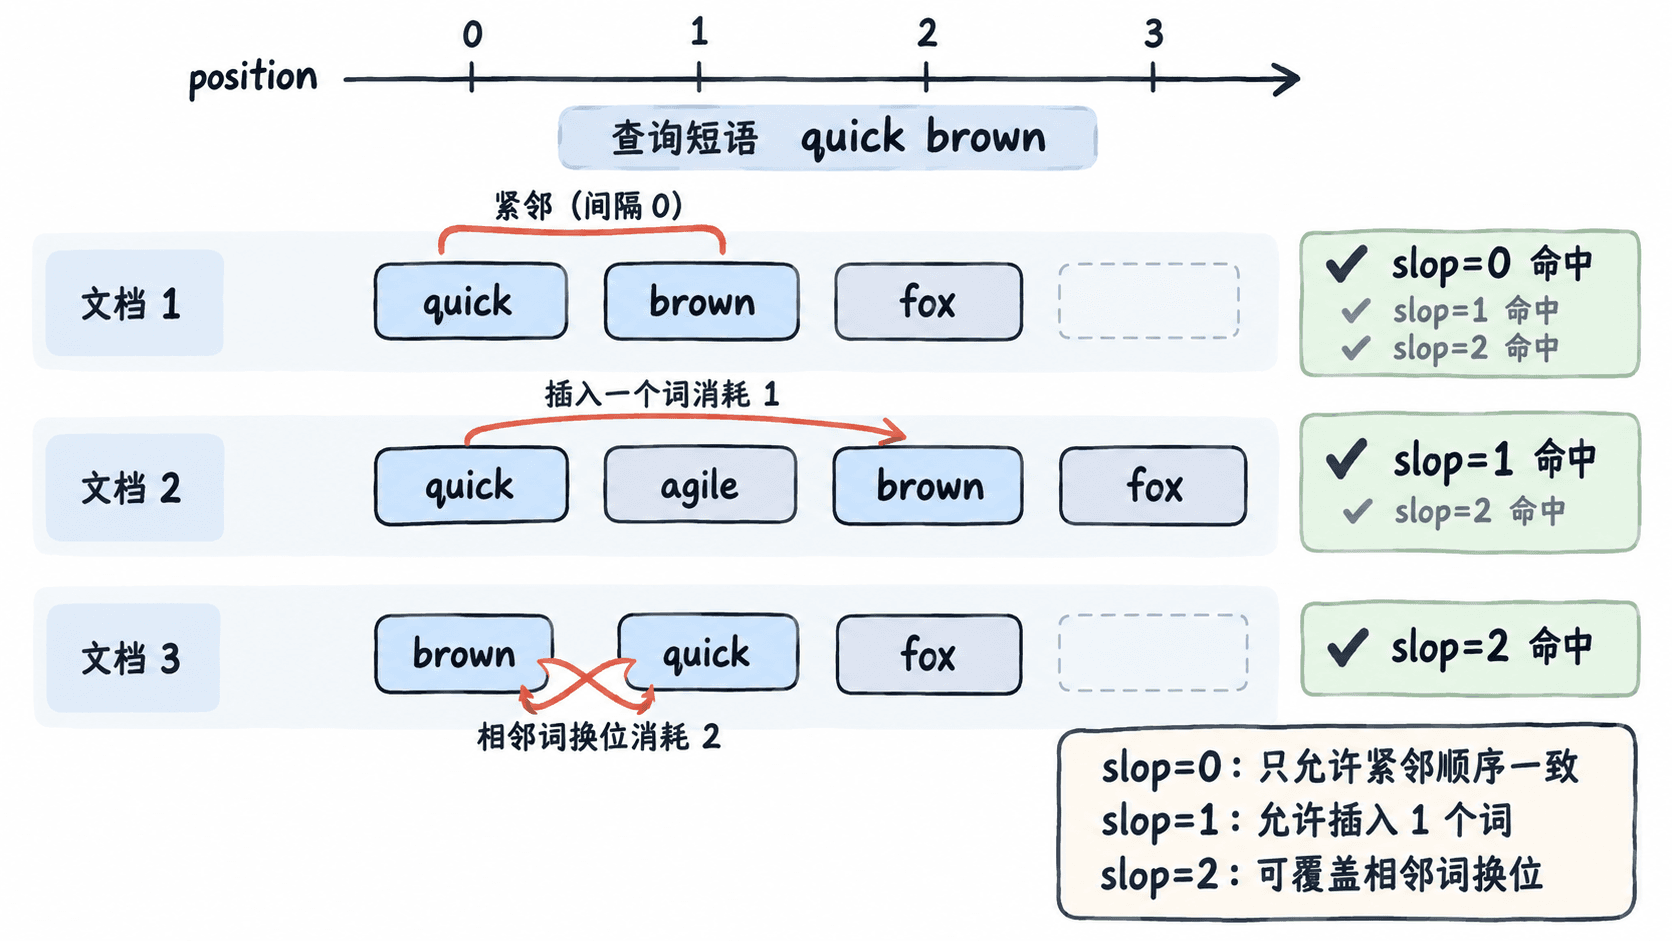
match_phrase 会先使用字段对应的分析器处理查询文本,再按词元的位置关系执行短语查询。slop 默认为 0,表示各词元必须以分析后的顺序连续出现;词元换位需要消耗 2 个位置移动量。:contentReference[oaicite:0]{index=0}
因此,它不是对原始字符串做简单的子串比较。大小写归一化、停用词过滤、同义词和分词方式都会改变词元或位置,排查异常时应同时检查索引时与查询时使用的分析器。
准备可验证的数据
下面的请求可直接在 Kibana Dev Tools 或兼容 Elasticsearch REST 语法的控制台中执行。示例使用 standard 分析器,使英文单词及其位置关系容易观察。
PUT /phrase-demo
{
  "mappings": {
    "properties": {
      "content": {
        "type": "text",
        "analyzer": "standard"
      }
    }
  }
}

PUT /phrase-demo/_doc/1
{
  "content": "quick brown fox"
}

PUT /phrase-demo/_doc/2
{
  "content": "quick agile brown fox"
}

PUT /phrase-demo/_doc/3
{
  "content": "brown quick fox"
}

POST /phrase-demo/_refresh
预期结果
索引创建成功;三次写入分别返回 201 Created;刷新请求返回 200 OK。
响应中的耗时、分片统计等动态值可能不同。
比较不同 slop 的命中范围
依次执行三次查询,只改变 slop。过滤响应字段是为了让结果更容易核对,不影响查询本身。
GET /phrase-demo/_search?filter_path=hits.total.value,hits.hits._id
{
  "query": {
    "match_phrase": {
      "content": {
        "query": "quick brown",
        "slop": 0
      }
    }
  }
}

GET /phrase-demo/_search?filter_path=hits.total.value,hits.hits._id
{
  "query": {
    "match_phrase": {
      "content": {
        "query": "quick brown",
        "slop": 1
      }
    }
  }
}

GET /phrase-demo/_search?filter_path=hits.total.value,hits.hits._id
{
  "query": {
    "match_phrase": {
      "content": {
        "query": "quick brown",
        "slop": 2
      }
    }
  }
}
预期结果
slop=0:命中文档 1。
slop=1:命中文档 1、2。
slop=2:命中文档 1、2、3。
命中顺序和 _score 可能因版本及索引统计信息不同。
slop=1 允许 quick 与 brown 之间多出一个位置,因此文档 2 被召回。文档 3 中两个词发生换位,需要 slop=2 才能匹配。这里的数值表示位置移动预算,不是允许插入的字符数。
设置 slop 的实际原则
商品全名、固定术语、法规名称等强调原始顺序时,从 0 开始。用户自然语言、地址或标题检索需要容忍少量修饰词时,可以逐步提高到 1 或 2,再通过离线样本观察误召回。
不要仅为了提高召回率无限增大 slop。范围越宽,越可能让语义关系较弱的词元组合进入结果,也会增加位置匹配工作量。若业务同时需要“短语优先、普通匹配兜底”,通常可在 bool.should 中组合高权重 match_phrase 与低权重 match。
Tips:短语查询结果异常时,先调用
_analyze检查词元和位置,再调整slop;直接反复改参数容易掩盖分词器不一致的问题。
本课总结
match_phrase依据分析后的词元顺序和位置匹配,不是原始字符串比较slop=0要求连续短语,间隔与换位会消耗位置移动预算- 邻近范围应通过真实查询样本校准,而不是一味增大
下一课预告
下一课将使用 fuzziness 处理输入拼写错误,并分析模糊扩展带来的召回收益与查询成本。