
NoSQL 与搜索 / 系统课时
文本与关键字字段
文本与关键字字段
字符串字段并不只有一种建模方式。text 面向全文检索,keyword 面向精确匹配、排序和聚合。本课将通过多字段映射和一组可执行请求,完成同时支持搜索与统计的字段设计。
学习目标
- 区分
text与keyword的索引方式 - 为同一业务字段设计多字段映射
- 正确选择全文查询、精确查询、排序和聚合字段
两种字段的索引方式
text 会经过分析器处理,原始字符串通常被拆成多个词项并标准化,因此适合按内容相关性检索。keyword 默认不分词,整个字符串作为一个词项写入索引,因此适合精确过滤、去重、排序和分组统计。
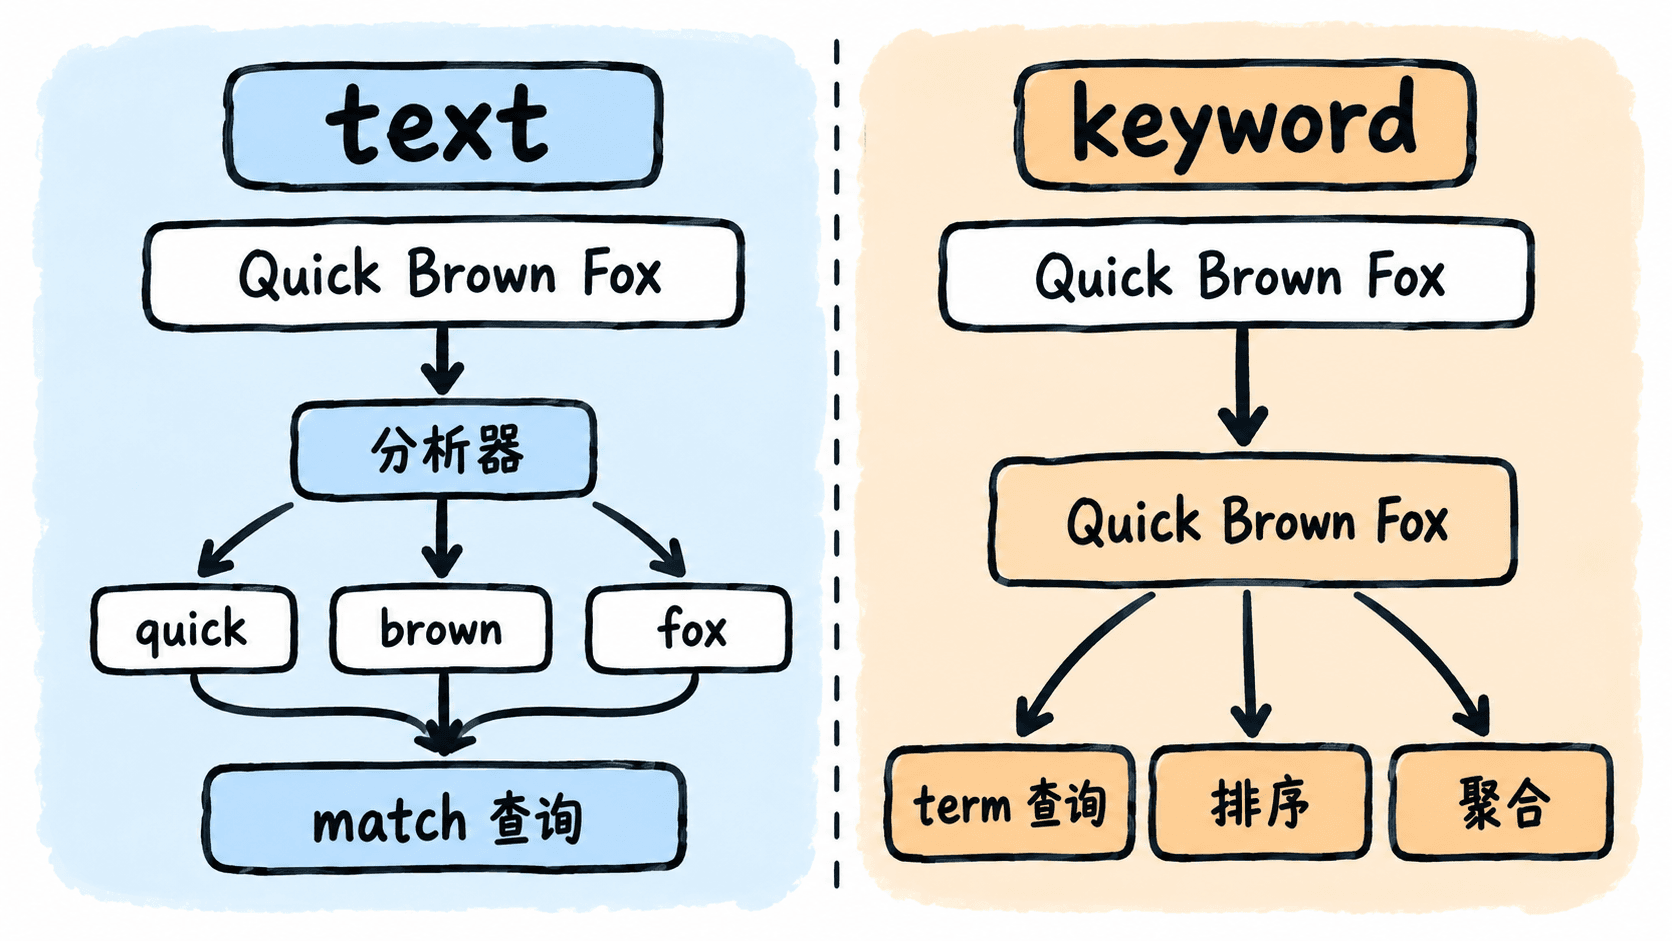
| 需求 | 推荐字段 | 常用方式 |
|---|---|---|
| 按标题内容搜索 | text |
match、multi_match |
| 按状态或编码精确过滤 | keyword |
term、terms |
| 字典序排序 | keyword |
sort |
| 分组统计 | keyword |
terms 聚合 |
对 text 字段直接排序或聚合通常不可取,因为它保存的是分析后的词项。虽然可以开启 fielddata,但会增加堆内存压力;更常见的做法是为文本字段增加一个 keyword 子字段。
使用多字段同时满足搜索与排序
下面创建 articles 索引。title 主字段用于全文检索,title.raw 子字段保留完整标题,用于排序;category 本身不需要分词,因此直接使用 keyword。
# 1. 创建多字段映射
curl -s -X PUT "http://localhost:9200/articles?filter_path=acknowledged,shards_acknowledged,index" \
  -H "Content-Type: application/json" \
  -d '{
    "mappings": {
      "properties": {
        "title": {
          "type": "text",
          "fields": {
            "raw": {
              "type": "keyword",
              "ignore_above": 256
            }
          }
        },
        "category": {
          "type": "keyword"
        }
      }
    }
  }'
echo

# 2. 写入三篇文档,并等待刷新完成
curl -s -X POST "http://localhost:9200/articles/_bulk?refresh=wait_for&filter_path=errors" \
  -H "Content-Type: application/x-ndjson" \
  --data-binary $'{"index":{"_id":"1"}}
{"title":"Quick Brown Fox","category":"search"}
{"index":{"_id":"2"}}
{"title":"Brown Dog","category":"database"}
{"index":{"_id":"3"}}
{"title":"Quick Search Guide","category":"search"}
'
echo

# 3. title 做全文匹配,title.raw 排序,category 聚合
curl -s -X POST "http://localhost:9200/articles/_search?filter_path=hits.hits._source.title,aggregations.by_category.buckets" \
  -H "Content-Type: application/json" \
  -d '{
    "query": {
      "match": {
        "title": "Quick"
      }
    },
    "sort": [
      {
        "title.raw": {
          "order": "asc"
        }
      }
    ],
    "aggs": {
      "by_category": {
        "terms": {
          "field": "category"
        }
      }
    }
  }'
echo
预期输出:
{"acknowledged":true,"shards_acknowledged":true,"index":"articles"}
{"errors":false}
{"hits":{"hits":[{"_source":{"title":"Quick Brown Fox"}},{"_source":{"title":"Quick Search Guide"}}]},"aggregations":{"by_category":{"buckets":[{"key":"search","doc_count":2}]}}}
搜索命中依赖 title 的分词结果,排序读取 title.raw 的完整值,聚合则按 category 的精确词项统计。三个操作分别使用最适合的字段,互不冲突。
选择字段与查询的边界
全文搜索通常使用 match,因为它会按照字段分析器处理查询文本。精确值查询通常使用 term,它不会再分析输入,适合状态码、订单号、标签和枚举值。不要用 term 查询普通 text 字段的原始句子,也不要用 match 代替需要严格相等的编码过滤。
ignore_above: 256 表示超过该长度的字符串不会写入 title.raw 子字段,但仍可保留在 _source 并进入 title 的全文索引。设计该阈值时,应确认超长标题是否仍需要排序或聚合。
建模时先判断业务含义:名称、标题、描述通常需要 text;状态、国家代码、用户编号、标签通常需要 keyword。一个字符串字段同时承担“按内容搜索”和“按完整值排序”时,优先使用多字段,而不是复制两份业务数据。
本课总结
text通过分词支持全文检索,keyword以完整词项支持精确操作- 多字段可以让同一原始值同时服务搜索、排序和聚合
- 查询类型、排序字段和聚合字段必须与 Mapping 的语义保持一致
下一课预告
下一课将继续学习数值、日期与布尔字段的建模方法,并处理范围查询、时间格式和空值边界。