
机器学习与深度学习 / 系统课时
排查训练与部署故障
排查训练与部署故障
训练或上线后出现 OOM、张量形状不匹配、权重加载失败或预测结果异常时,最有效的方法是先固定输入、模型版本和运行设备,再沿着“资源→形状→权重→推理状态”逐层缩小范围。本文给出可直接执行的定位顺序和验证标准。
学习目标
- 按固定顺序定位显存不足、形状不匹配、权重加载失败和预测异常。
- 使用 PyTorch 的真实 API 输出关键诊断信息,而不是依赖模糊日志。
- 修复后用最小输入做回归验证,确认问题没有转移到下一环节。
先建立固定的排查顺序
不要同时改 batch size、模型结构和权重文件。先保存一份能稳定复现问题的最小输入,例如分类模型固定为 N=2、C=3、H=W=224,然后按资源、形状、权重、推理四层检查。
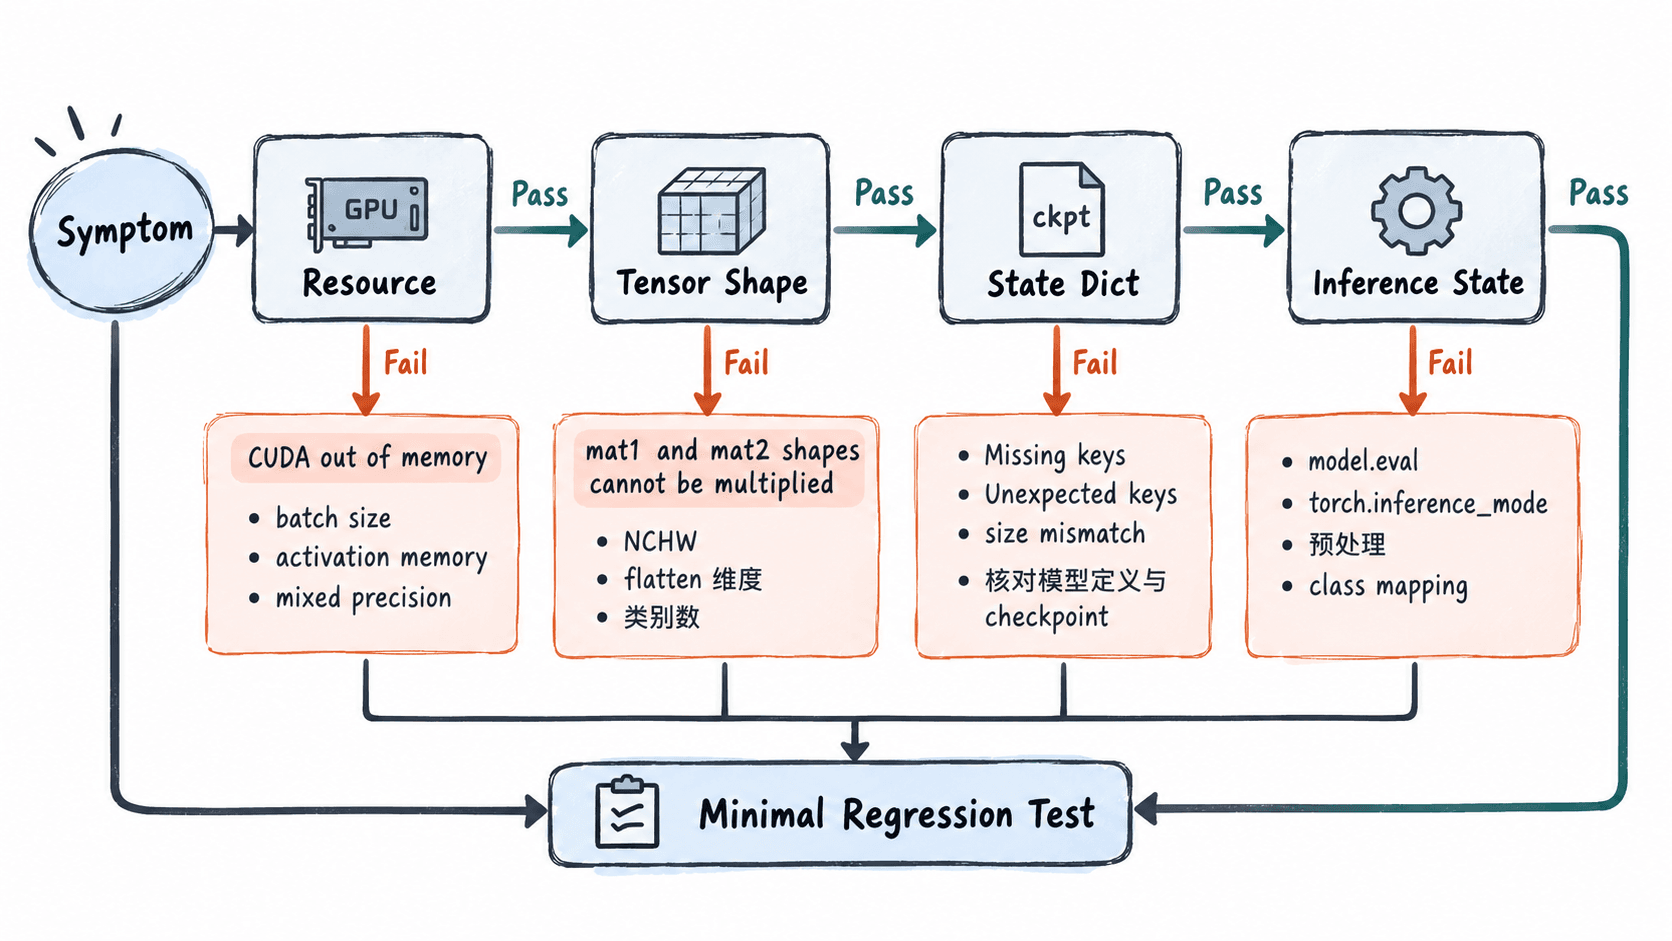
下面的诊断脚本用一个最小分类器同时检查输入形状、权重兼容性和推理输出。它不依赖 GPU,因此适合作为部署前的基线检查。
import torch
from torch import nn

class TinyClassifier(nn.Module):
    def __init__(self, num_classes: int = 5):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 8, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.AdaptiveAvgPool2d((1, 1)),
        )
        self.head = nn.Linear(8, num_classes)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = self.features(x)
        x = torch.flatten(x, 1)
        return self.head(x)

model = TinyClassifier(num_classes=5)
checkpoint = {"model_state": model.state_dict()}
model.load_state_dict(checkpoint["model_state"], strict=True)

x = torch.zeros(2, 3, 224, 224)
model.eval()
with torch.inference_mode():
    logits = model(x)

assert logits.shape == (2, 5)
assert torch.isfinite(logits).all()
print("input:", tuple(x.shape))
print("output:", tuple(logits.shape))
print("finite:", bool(torch.isfinite(logits).all()))
预期输出:
input: (2, 3, 224, 224)
output: (2, 5)
finite: True
如果这份最小检查能通过,而真实任务失败,问题通常在真实数据、真实 checkpoint 或运行环境,不要继续怀疑基础前向路径。
显存不足先找峰值来源
典型报错包含 CUDA out of memory。先区分“模型放不下”和“训练峰值过高”:模型刚搬到 GPU 就失败,多半是参数本身过大;执行 loss.backward() 才失败,则常见于激活、梯度和优化器状态叠加。
修复顺序建议固定为:
- 把
batch_size从 64 降到 32,再降到 16,观察是否能稳定跑完一个完整 step。 - 使用自动混合精度时,在 CUDA 上将前向放进
torch.autocast(device_type="cuda", dtype=torch.float16),并配合梯度缩放。 - 只在确实需要时保留中间张量;不要把带计算图的
loss或output直接追加到长期列表,记录标量时使用loss.item()。 - 每次实验前记录
torch.cuda.max_memory_allocated(),比较修复前后的峰值,而不是只看瞬时占用。
形状不匹配沿边界逐层核对
出现 mat1 and mat2 shapes cannot be multiplied、卷积通道数不匹配或损失函数维度异常时,不要只改最后一个数字。先在模块边界打印或断言形状,并统一采用 NCHW 约定。
以五分类为例,关键边界应满足:输入 (N, 3, 224, 224),分类 logits (N, 5),给 nn.CrossEntropyLoss 的标签是 (N,) 且 dtype 为 torch.long。若数据是 NHWC,应在进入模型前显式调整为 x.permute(0, 3, 1, 2);若分类头原来是 1000 类,迁移到 5 类后应把最后的 Linear 输出改为 5。
权重加载失败看三类键差异
load_state_dict 报错通常只属于三类:Missing key(s) 表示当前模型需要但 checkpoint 没有;Unexpected key(s) 表示 checkpoint 多了当前模型不存在的参数;size mismatch 表示键名相同但张量形状不同。
优先使用 strict=True 暴露不一致,不要一开始就改成 strict=False。迁移学习只更换分类头时,可以先删除旧头部权重,再检查其余主干是否完全匹配;如果连主干也出现大量缺失键,往往是模型版本或命名规则变了,应回到生成该 checkpoint 的代码版本核对。
部署交付时至少记录模型类名、类别数、输入尺寸、PyTorch 版本和 checkpoint 的 SHA-256。这样遇到加载失败时,可以先判断“文件错了”还是“代码错了”。
预测异常检查推理状态和预处理
没有报错但预测全部落在同一类、概率异常或离线与服务结果不一致时,先检查四项:调用 model.eval()、使用 torch.inference_mode()、训练与部署预处理完全一致、类别索引映射未被重排。
例如训练使用 RGB、缩放到 224×224、按指定 mean/std 归一化,部署就必须做同样处理;如果服务读取图像后仍是 BGR,数值范围仍是 0~255,模型虽然能运行,结果也可能完全失真。最后固定 3~10 个已知样本做“黄金样本”回归,记录 logits 或预测类别。修复只有在这些样本重新通过后才算完成。