
机器学习与深度学习 / 系统课时
认识 PyTorch 生态
认识 PyTorch 生态
PyTorch 不只是一个神经网络库。实际项目通常还会使用视觉、音频、数据处理、模型导出和端侧运行等配套组件。本篇把这些组件放进一条完整工作链中,并说明新项目应该怎样选择它们。
学习目标
- 区分 PyTorch 核心库与 TorchVision、TorchAudio、TorchText 的职责
- 理解训练、优化、导出与部署组件之间的关系
- 根据图像、音频和文本任务选择合适的生态组件
PyTorch 核心负责什么
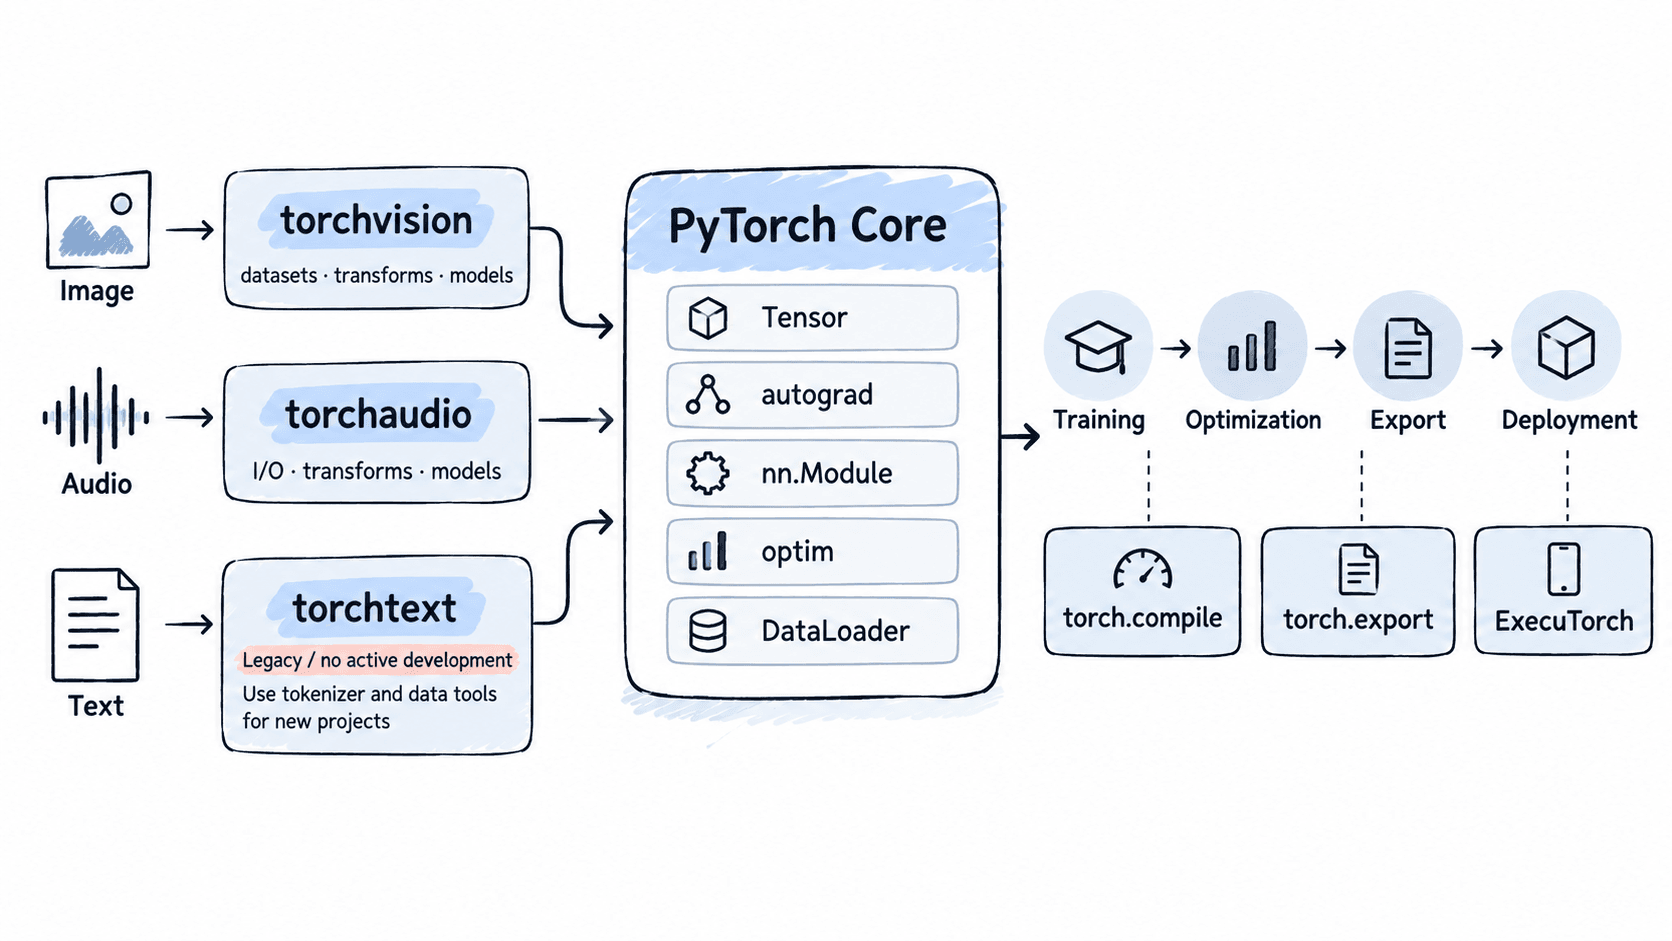
torch 是核心包,主要承担张量计算、自动微分、神经网络层、优化器、数据加载和设备管理。训练一个模型时常见的核心接口包括 torch.Tensor、torch.nn、torch.optim、torch.utils.data 和 torch.autograd。
一个典型训练项目可以把职责压缩成四层:数据由 Dataset 和 DataLoader 提供,模型继承 nn.Module,损失函数计算误差,优化器根据梯度更新参数。GPU 可用时再把模型与张量移动到 CUDA 设备,而不需要换一套训练 API。
视觉、音频与文本扩展库
torchvision 面向计算机视觉,常用能力包括数据集、图像变换以及 ResNet、MobileNet、Vision Transformer 等预训练模型。做图片分类时,通常优先检查 torchvision.datasets、torchvision.transforms 和 torchvision.models 是否已有可复用实现。
torchaudio 面向音频处理,覆盖音频读取、波形与频谱变换以及部分音频模型。音频项目要特别检查 PyTorch 与 TorchAudio 的版本兼容关系,不要随意混装不同发布周期的二进制包。
torchtext 曾承担文本数据集、词表和文本变换等职责,但已经不再作为活跃发展的 PyTorch 文本栈。维护旧项目时仍可能遇到它;新项目不应默认依赖 TorchText,应根据模型选择 Hugging Face Tokenizers、SentencePiece 或项目自身的数据流水线。
从训练到部署怎样衔接
PyTorch 2.x 中,torch.compile 用于优化模型执行,它仍然运行 PyTorch 模型,并不等于导出部署格式。需要把模型转换成可进一步处理的程序表示时,可关注 torch.export;面向移动端或嵌入式设备时,ExecuTorch 提供针对端侧推理的工具链。
可以按实际交付目标区分:研究和服务器训练阶段以 torch 为中心;需要提高训练或推理执行效率时评估 torch.compile;需要跨运行环境交付模型时再考虑导出格式及目标运行时。不要把“保存权重”“导出计算图”和“部署服务”当成同一个步骤。
例如,一个服务器端图像分类项目可以使用 torch 完成训练、torchvision 提供预训练骨干网络,再根据性能测试决定是否启用 torch.compile。若同一模型还要运行到手机设备,则需要额外验证导出算子是否受目标端运行时支持。
按任务选择最小组件集合
| 项目类型 | 优先组件 | 典型用途 |
|---|---|---|
| 图像分类或检测 | torch、torchvision |
训练、图像变换、预训练视觉模型 |
| 语音或声音分类 | torch、torchaudio |
波形处理、频谱特征、音频模型 |
| 新文本项目 | torch + 独立 tokenizer 或模型库 |
Token 化、文本模型训练 |
| 端侧推理 | torch、torch.export、ExecuTorch |
模型导出与设备端执行 |
实际建立环境时,应先确定任务与部署目标,再决定扩展包,而不是一次安装整个生态。这样更容易控制 CUDA、Python 和各扩展库之间的版本组合,也能在出现兼容问题时快速定位到具体组件。