
机器学习与深度学习 / 系统课时
使用 DataLoader 批处理
使用 DataLoader 批处理
模型训练通常不是逐样本调用 Dataset,而是把多个样本组合成 batch。DataLoader 负责按索引取样、可选打乱顺序、组成批次并处理尾批次;掌握 batch_size、shuffle 和 drop_last 后,就能明确每个 epoch 实际会得到多少批数据。
学习目标
- 用
DataLoader把单样本数据组合成固定大小的 batch - 正确配置
shuffle与drop_last,理解它们对每个 epoch 的影响 - 根据批次形状和批次数验证加载配置是否符合预期
DataLoader 怎样形成一个 batch
对地图式 Dataset,DataLoader 先产生样本索引,再按 batch_size 分组,调用数据集取出各个样本,最后由默认 collate 逻辑把同形状张量堆叠成批张量。shuffle=True 改变每个 epoch 的索引顺序,drop_last=True 则丢弃不足一个完整 batch 的尾部索引组。
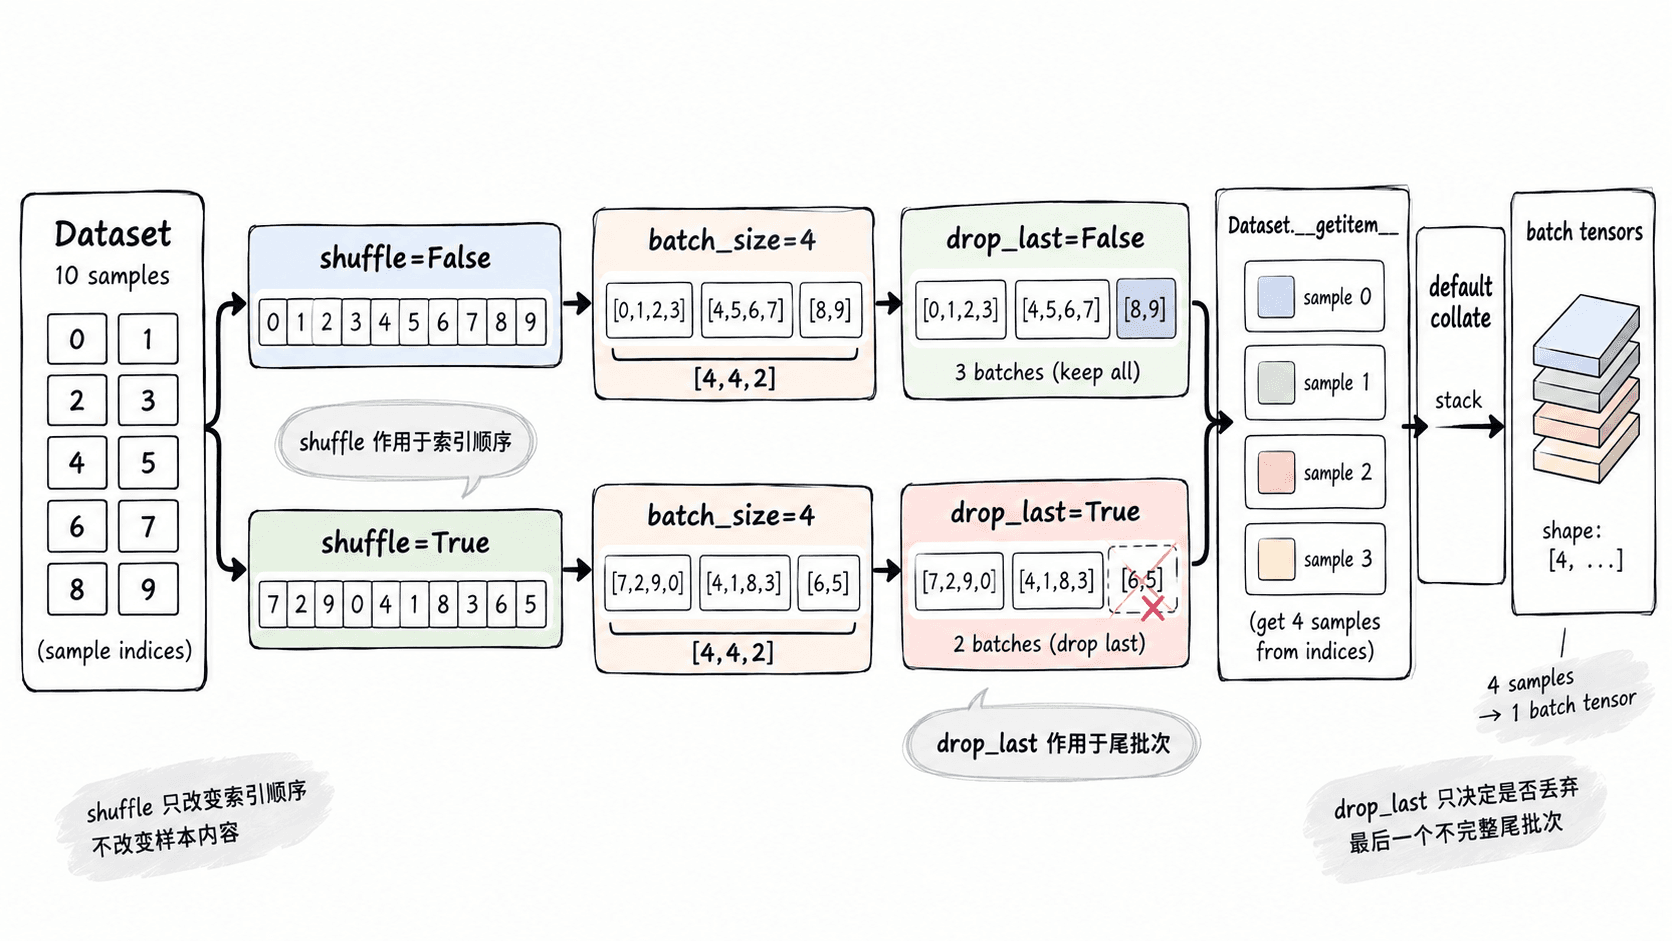
当样本数 、批大小 时,drop_last=False 会产生 3 批,大小分别为 4、4、2;drop_last=True 只产生 2 批,每批都是 4 个样本。
配置批大小、打乱和尾批次
下面示例用 10 个样本演示两种配置。第一种保留尾批次,第二种启用打乱并丢弃不足 4 个样本的尾批次。
import torch
from torch.utils.data import DataLoader, TensorDataset

features = torch.arange(10, dtype=torch.float32).unsqueeze(1)
labels = torch.arange(10)
dataset = TensorDataset(features, labels)

keep_tail = DataLoader(
    dataset,
    batch_size=4,
    shuffle=False,
    drop_last=False,
    num_workers=0,
)

drop_tail = DataLoader(
    dataset,
    batch_size=4,
    shuffle=True,
    drop_last=True,
    num_workers=0,
    generator=torch.Generator().manual_seed(7),
)

print("keep_tail batch sizes:", [len(y) for _, y in keep_tail])
print("keep_tail batches:", len(keep_tail))

seen = []
sizes = []
for _, y in drop_tail:
    sizes.append(len(y))
    seen.extend(y.tolist())

print("drop_tail batch sizes:", sizes)
print("drop_tail batches:", len(drop_tail))
print("drop_tail sample count:", len(seen))
print("all batches full:", all(size == 4 for size in sizes))
预期输出:
keep_tail batch sizes: [4, 4, 2]
keep_tail batches: 3
drop_tail batch sizes: [4, 4]
drop_tail batches: 2
drop_tail sample count: 8
all batches full: True
因为第二个加载器先打乱再分批,被丢弃的是当轮随机排列末尾的 2 个样本,不应假设永远是原始索引 8 和 9。固定 generator 种子可以让本示例更容易复现,但训练中是否固定种子取决于你的复现实验方案。
三个参数怎么选
| 参数 | 常用起点 | 适用判断 |
|---|---|---|
batch_size |
32 或 64 | 先满足显存,再用吞吐量和收敛表现调整 |
shuffle |
训练集 True,验证集 False |
训练时避免长期固定样本顺序;评估通常保留稳定顺序 |
drop_last |
通常 False |
下游要求固定批大小,或不希望极小尾批次参与训练时设为 True |
num_workers |
调试时 0 |
数据读取或预处理成为瓶颈后再逐步增加 |
例如 1003 个训练样本、batch_size=64 时,保留尾批次会得到 16 批,最后一批 43 个样本;设置 drop_last=True 后只有 15 批,本轮实际用于训练的是 960 个样本。若同时开启 shuffle=True,下一轮被落在尾部而丢弃的样本通常会变化。
训练集与验证集不要共用同一策略
训练加载器通常启用 shuffle=True,验证和测试加载器通常关闭打乱,便于结果对齐、逐样本排错和导出预测。drop_last=True 也不应机械用于验证集,否则评估指标会漏掉尾部样本。
如果模型收到的 batch 维度不对,先打印一次 features.shape 和 labels.shape。以本例为例,完整批次应分别是 (4, 1) 和 (4,);若单样本本身形状不一致,默认 collate 无法直接堆叠,应先统一样本尺寸或提供专门的 collate_fn。