
机器学习与深度学习 / 系统课时
使用池化层
使用池化层
池化层不学习卷积核,而是在固定窗口内做最大值或平均值聚合,从而缩小特征图的高和宽。本课用同一张 4×4 特征图比较 MaxPool2d 与 AvgPool2d,再把窗口、步长与输出尺寸对应起来。
学习目标
- 能说明最大池化与平均池化在同一窗口中分别保留什么信息。
- 能根据
kernel_size、stride和padding判断池化后的高宽。 - 能用固定输入运行两种池化层,并核对数值与输出形状。
看懂池化窗口怎样缩小特征图
nn.MaxPool2d 与 nn.AvgPool2d 都按通道独立处理二维窗口,不改变通道数。常用的 kernel_size=2, stride=2 会把不重叠的 2×2 区域压成一个值,因此 32×32 会变成 16×16,64 个通道仍然是 64 个通道。
在 stride 省略时,两类池化层都默认使用与 kernel_size 相同的步长。例如 nn.MaxPool2d(2) 等价于 nn.MaxPool2d(kernel_size=2, stride=2)。
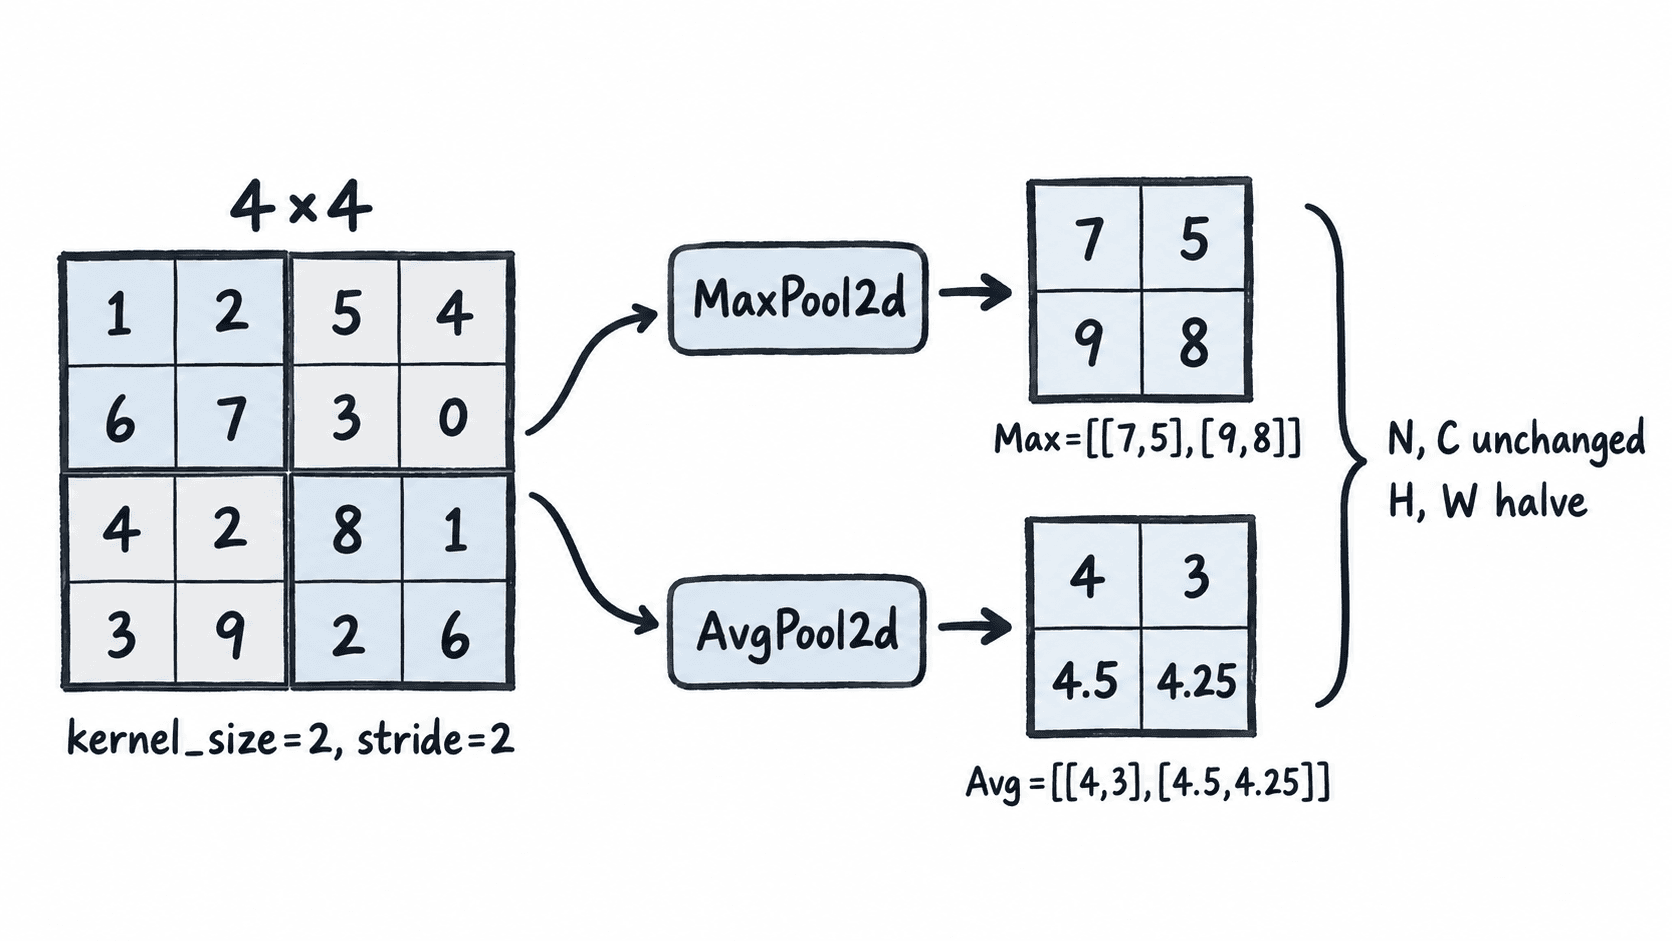
用同一组数据比较最大值与平均值
最大池化保留每个窗口里的最强响应,平均池化保留窗口的平均水平。下面用固定输入避免随机数,让每个窗口的结果都可以手算复核。
import torch
from torch import nn

x = torch.tensor([[[[
    1.0, 2.0, 5.0, 4.0,
], [
    6.0, 7.0, 3.0, 0.0,
], [
    4.0, 2.0, 8.0, 1.0,
], [
    3.0, 9.0, 2.0, 6.0,
]]]])

max_pool = nn.MaxPool2d(kernel_size=2, stride=2)
avg_pool = nn.AvgPool2d(kernel_size=2, stride=2)

print("max:", max_pool(x).tolist())
print("avg:", avg_pool(x).tolist())
print("shape:", tuple(max_pool(x).shape))
预期输出:
max: [[[[7.0, 5.0], [9.0, 8.0]]]]
avg: [[[[4.0, 3.0], [4.5, 4.25]]]]
shape: (1, 1, 2, 2)
例如左上角窗口包含 1, 2, 6, 7,最大池化得到 7,平均池化得到 (1+2+6+7)/4=4。两者都没有可学习参数,差别来自固定的聚合规则。
按目标尺寸选择窗口和步长
当 dilation=1 且 ceil_mode=False 时,可以用下面的常见形式检查输出高度:
对 224×224 特征图,连续两次 kernel_size=2, stride=2 会按 224→112→56 缩小;若通道数依次是 64 和 128,则形状可以是 [N, 64, 224, 224]→[N, 64, 112, 112]→[N, 128, 56, 56]。池化负责改变空间尺寸,通道从 64 变 128 通常由中间的卷积层完成。
如果只想轻微平滑而不希望立刻减半,可以让 stride=1。此时 kernel_size=3, stride=1, padding=1 会保持高宽不变,但会改变局部数值。
处理 padding 与 ceil_mode 的边界
MaxPool2d 和 AvgPool2d 的边界语义并不完全相同。最大池化在有 padding 时把填充区域视作负无穷,因此不会让补齐值抢走最大值;平均池化使用零填充,并且 count_include_pad=True 是默认值,填充零会计入平均值的除数。
ceil_mode=False 是默认设置,输出尺寸按向下取整计算。只有在确实希望保留右侧或下侧未完整覆盖的窗口时才开启 ceil_mode=True;否则同一网络不同输入尺寸更容易出现 1 个像素的形状差异。分类网络里若最终目标是固定成 1×1,比手工叠多层普通池化更直接的做法通常是 nn.AdaptiveAvgPool2d((1, 1))。