
机器学习与深度学习 / 系统课时
理解标量、向量与矩阵
理解标量、向量与矩阵
深度学习中的输入、参数和输出最终都会落到“数值加形状”上。本课用标量、向量和矩阵三种最常见表示建立维度直觉,并通过一个 PyTorch 小例子学会用 ndim 和 shape 检查数据是否符合网络预期。
学习目标
- 区分标量、向量、矩阵及其维度含义。
- 能根据
shape判断批量、特征和输出维度。 - 能用 PyTorch 检查张量的维数与索引结果。
从形状读懂三种数据
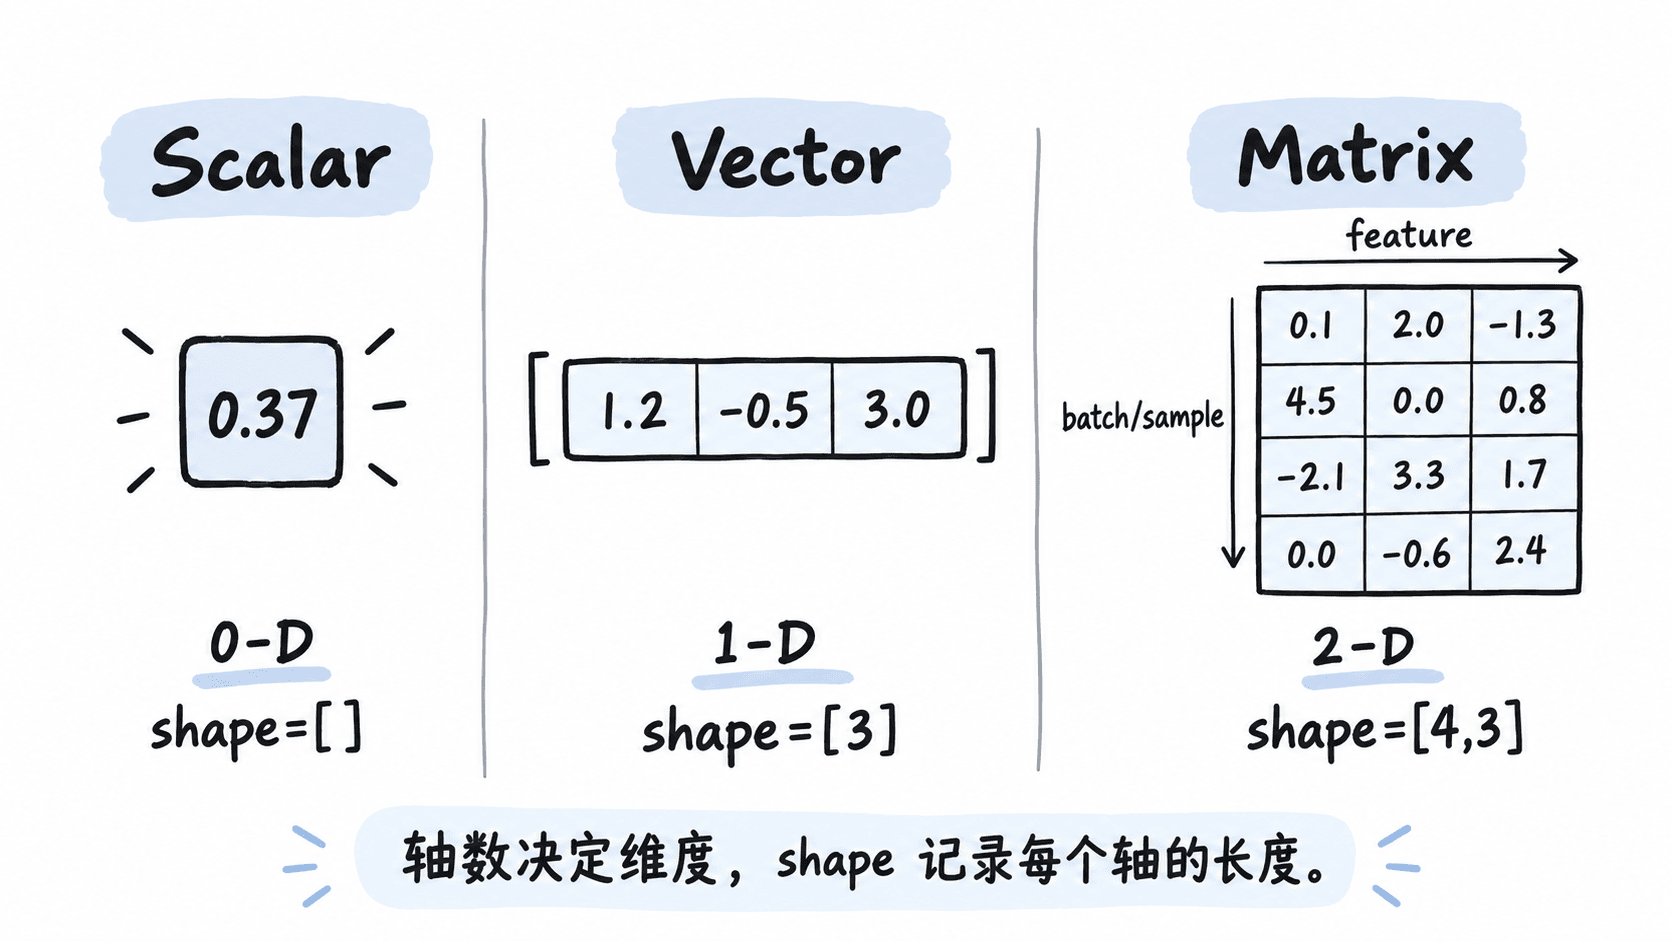
标量只有一个数,例如损失值 ,没有轴;向量是一列或一组有顺序的数,例如样本特征 ;矩阵有两个轴,例如 4 个样本、每个样本 3 个特征时,数据可写成 ,形状为 。
| 表示 | 例子 | PyTorch 典型形状 | 常见含义 |
|---|---|---|---|
| 标量 | 0.37 |
torch.Size([]) |
损失、学习率、单个统计量 |
| 向量 | [1.2, -0.5, 3.0] |
torch.Size([3]) |
单个样本特征、偏置 |
| 矩阵 | 4 行 3 列 | torch.Size([4, 3]) |
一批样本、线性层权重 |
把维度放进神经网络
线性层最常见的维度关系是:输入批次 的形状为 ,表示 32 个样本、每个样本 128 个特征;权重 的形状为 ,把 128 维特征映射到 64 维;偏置 是长度为 64 的向量;输出 最终是 。
读形状时可以固定按“每一轴代表什么”检查:第 0 轴通常是 batch,第 1 轴通常是 feature。看到 torch.Size([32, 128]),不要只记两个数字,而要能说出“32 个样本,每个 128 个特征”。
用 PyTorch 检查维度
下面创建一个标量、一个向量和一个矩阵,并检查 ndim、shape 以及矩阵中的单个元素。X[1, 2] 会先选第 2 行,再取第 3 列,因此结果是标量张量。
import torch

loss = torch.tensor(0.37)
x = torch.tensor([1.2, -0.5, 3.0])
X = torch.tensor([
    [1.0, 2.0, 3.0],
    [4.0, 5.0, 6.0],
])

print(loss.ndim, loss.shape)
print(x.ndim, x.shape)
print(X.ndim, X.shape)
print(X[1, 2].item())
预期输出
0 torch.Size([])
1 torch.Size([3])
2 torch.Size([2, 3])
6.0
实际项目中遇到维度错误时,先打印参与运算对象的 shape,通常比先改网络结构更有效。若预期输入是 [batch, feature],却拿到了 [feature],说明批次轴缺失。
区分向量与单行矩阵
长度为 3 的向量形状是 [3],而单行矩阵形状是 [1, 3];它们元素数量相同,但维数不同。在线性代数推导或批处理接口中,这个差异会直接影响广播和矩阵乘法。
例如,单个样本 x.shape == [3] 若要显式增加 batch 轴,可以使用 x.unsqueeze(0) 得到 [1, 3]。相反,若把 [1, 3] 误当成 [3],后续代码可能仍能广播运行,却产生与预期不同的结果。判断时始终同时看“轴数”和“每个轴的业务含义”。