
机器学习与深度学习 / 系统课时
评估图像分类模型
评估图像分类模型
单看总体准确率很容易掩盖某些类别的失败。本课用固定预测结果构造混淆矩阵,并从中计算每类 Precision、Recall、F1,以及 Macro F1 和 Weighted F1,最后给出图像分类中可直接采用的评估顺序。
学习目标
- 根据真实标签和预测标签构造混淆矩阵。
- 从 TP、FP、FN 计算每个类别的 Precision、Recall 和 F1。
- 区分 Accuracy、Macro F1 与 Weighted F1 的适用场景。
先固定混淆矩阵的方向
这里约定“行是真实类别,列是预测类别”。例如三分类矩阵中,第 2 行第 3 列的值表示真实为类别 1、却被预测成类别 2 的样本数。方向一旦写反,后续 Recall 和 Precision 都会被解释错。
下面用 9 个样本构造三分类混淆矩阵。torch.bincount 不依赖额外指标库,适合在纯 PyTorch 评估脚本中直接使用。
import torch

y_true = torch.tensor([0, 0, 1, 1, 1, 2, 2, 2, 2])
y_pred = torch.tensor([0, 1, 1, 1, 2, 2, 0, 2, 2])

num_classes = 3
index = y_true * num_classes + y_pred
cm = torch.bincount(
    index, minlength=num_classes * num_classes
).reshape(num_classes, num_classes)

print(cm)
预期输出
tensor([[1, 1, 0],
        [0, 2, 1],
        [1, 0, 3]])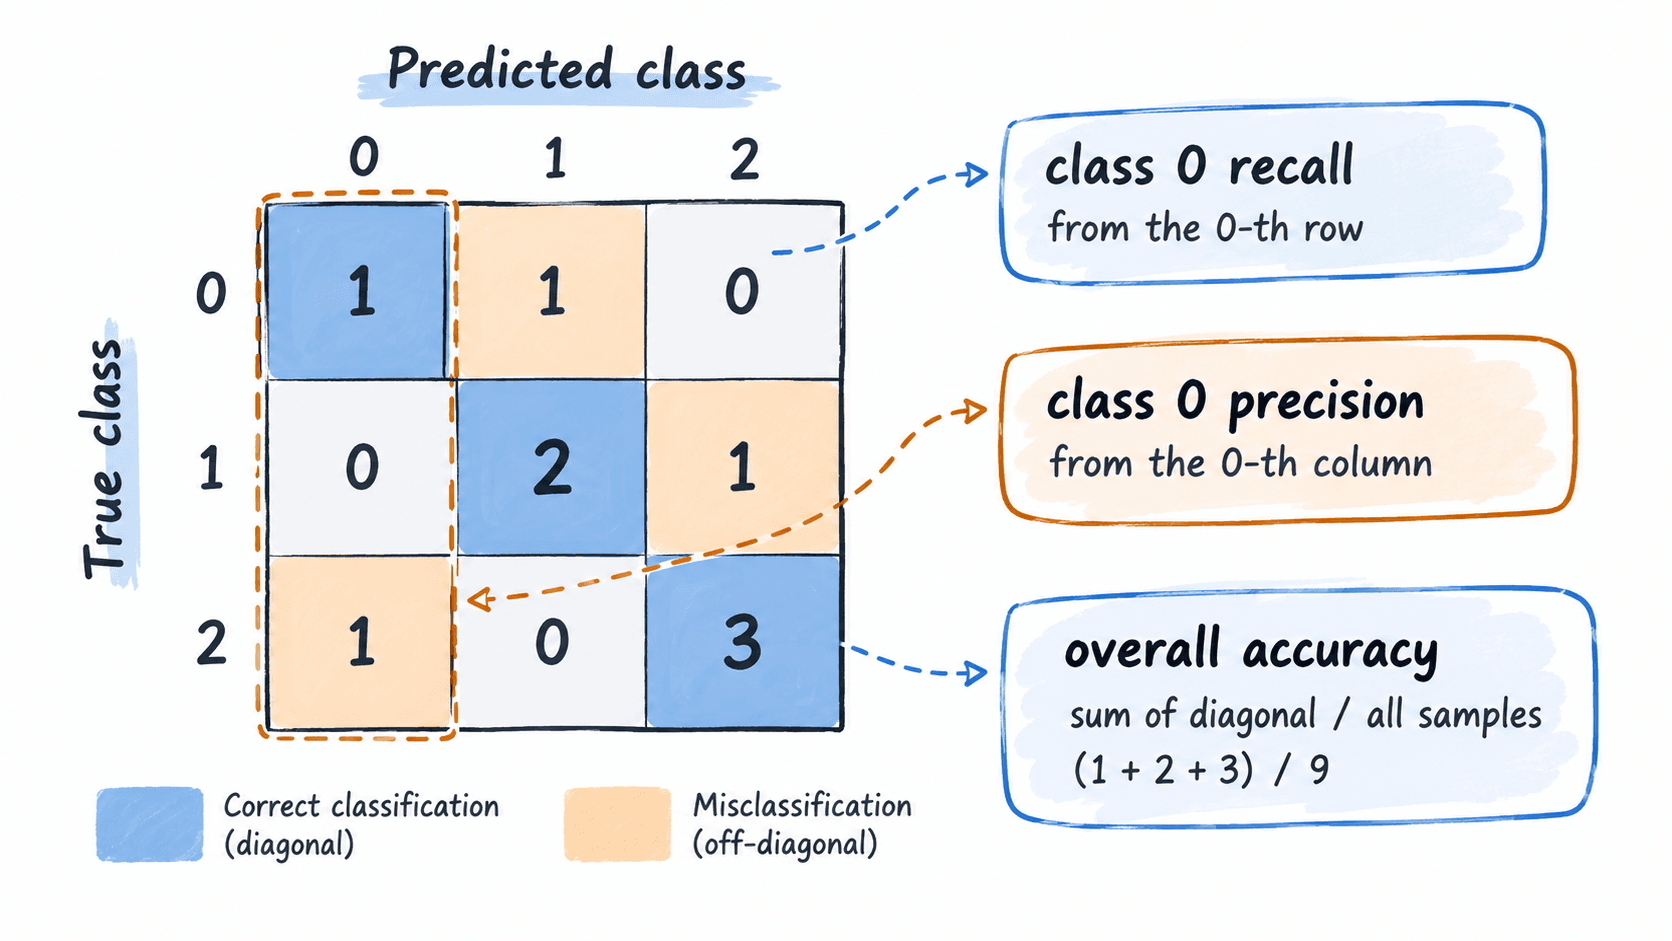
从矩阵计算分类指标
对某一类别而言,Precision 关注“预测成这个类别的样本里有多少是真的”,Recall 关注“真实属于这个类别的样本里有多少被找回来”。F1 是二者的调和平均,适合需要同时控制漏判和误判的场景。
import torch

cm = torch.tensor([
    [1, 1, 0],
    [0, 2, 1],
    [1, 0, 3],
], dtype=torch.float32)

tp = cm.diag()
precision = tp / cm.sum(dim=0).clamp_min(1)
recall = tp / cm.sum(dim=1).clamp_min(1)
f1 = 2 * precision * recall / (precision + recall).clamp_min(1e-12)

accuracy = tp.sum() / cm.sum()
macro_f1 = f1.mean()
support = cm.sum(dim=1)
weighted_f1 = (f1 * support / support.sum()).sum()

print("precision:", [round(v, 4) for v in precision.tolist()])
print("recall:", [round(v, 4) for v in recall.tolist()])
print("f1:", [round(v, 4) for v in f1.tolist()])
print("accuracy:", round(accuracy.item(), 4))
print("macro_f1:", round(macro_f1.item(), 4))
print("weighted_f1:", round(weighted_f1.item(), 4))
预期输出
precision: [0.5, 0.6667, 0.75]
recall: [0.5, 0.6667, 0.75]
f1: [0.5, 0.6667, 0.75]
accuracy: 0.6667
macro_f1: 0.6389
weighted_f1: 0.6667
当某个类别没有任何预测样本时,Precision 的分母会变成 0;示例用 clamp_min(1) 避免除零。在正式报告里还应把该类的 support 一并展示,避免把“样本极少”误解为“模型稳定”。
用 Macro 和 Weighted 看类别不均衡
Accuracy 对大类最敏感。假设验证集有 1000 张图,其中类别 A 有 900 张、B 和 C 各 50 张;模型只会预测 A,也能得到 90% Accuracy,但 B、C 的 Recall 都是 0。
Macro F1 先分别计算每个类别的 F1 再平均,因此每类权重相同,适合关注少数类表现。Weighted F1 按各类别样本数加权,更接近整体数据分布。在类别明显不均衡时,至少同时报告 Accuracy、Macro F1 和每类 Recall。
| 指标 | 关注点 | 适合回答的问题 |
|---|---|---|
| Accuracy | 全部样本总体正确率 | 模型整体猜对多少 |
| Macro F1 | 每个类别同等权重 | 少数类是否被大类掩盖 |
| Weighted F1 | 按样本数加权 | 按真实数据占比看综合表现 |
| Per-class Recall | 单类漏判情况 | 哪一类最容易被漏掉 |
把指标接到验证循环
真实图像分类验证时,在 model.eval() 和 torch.no_grad() 下收集每个 batch 的预测类别,再一次性计算混淆矩阵。不要在训练 batch 上报告最终指标,也不要只挑最高 Accuracy 的单个 batch。
import torch

def collect_predictions(model, dataloader, device):
    model.eval()
    all_true = []
    all_pred = []

    with torch.no_grad():
        for images, labels in dataloader:
            images = images.to(device)
            labels = labels.to(device)

            logits = model(images)
            preds = logits.argmax(dim=1)

            all_true.append(labels.cpu())
            all_pred.append(preds.cpu())

    return torch.cat(all_true), torch.cat(all_pred)
这是片段示例,依赖已创建的 model、dataloader 和 device。生效行为是完整遍历验证集后返回两个一维张量,长度都应等于验证集样本数;验证时检查 len(y_true) == len(dataloader.dataset),再把它们交给前面的混淆矩阵计算逻辑。
最终评估时先看混淆矩阵定位“哪些类别互相混淆”,再看每类 Recall 和 F1 确认问题严重程度,最后用 Macro F1 与 Accuracy 判断模型是否只是在多数类上表现好。