
机器学习与深度学习 / 系统课时
构建项目数据流水线
构建项目数据流水线
数据流水线要保证同一批原始图片经过固定检查、可复现切分、训练增强和批处理后,能稳定产出模型需要的张量。本例用 5 类商品图片演示一条可直接落地的 PyTorch 流水线,并把数据泄漏和验证集误增强这两个高频问题一起处理。
学习目标
- 检查损坏图片、最小尺寸、类别数量和完全重复文件。
- 按类别完成 70%/15%/15% 的可复现切分,并保证三组索引互斥。
- 为训练集与验证/测试集配置不同 Transform,并用
DataLoader验证 batch 形状。
先定义数据门槛
原始目录约定为 data/raw/<class_name>/*.jpg 或 .png。示例要求恰好 5 个类别,每类至少 100 张有效图片,图片短边不得小于 128 像素;正式项目如果数据规范更严格,应直接提高这些阈值,而不是让异常样本带着警告继续训练。
流水线的顺序应固定为:扫描文件与质量检查 → 按类别切分索引 → 为不同集合绑定各自 Transform → 创建 DataLoader → 读取一个 batch 做最终断言。训练增强只能作用在 train,val/test 必须保持确定性。
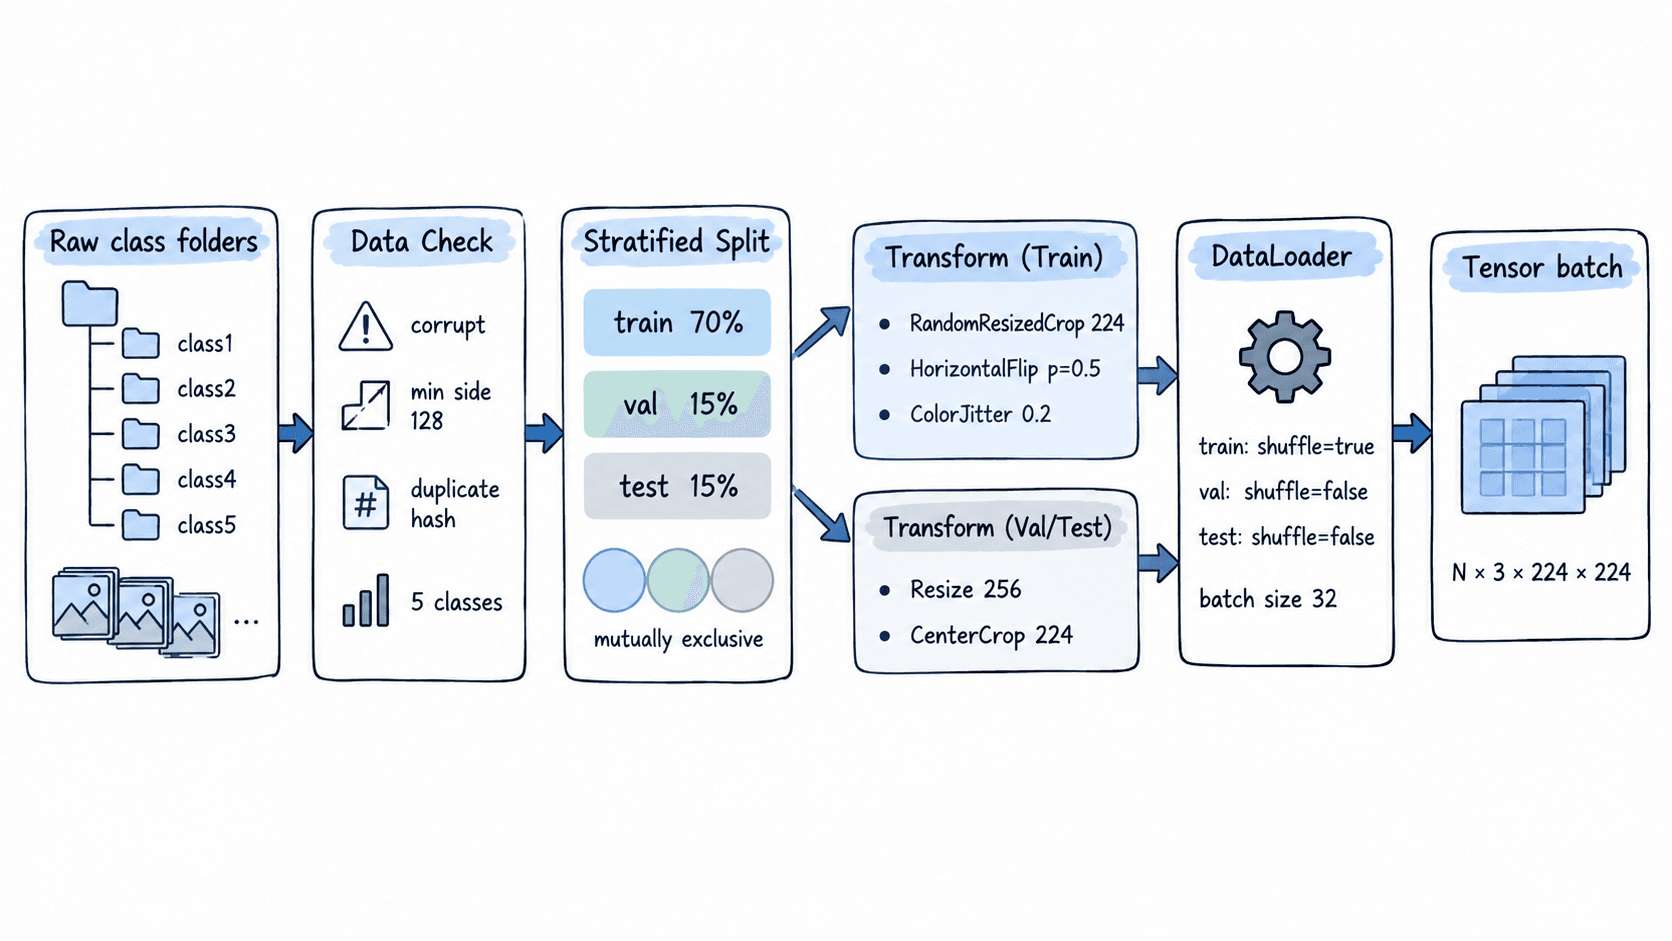
一次性构建切分、增强和批处理
下面示例使用 torchvision.transforms 经典 API。若项目已经统一使用 torchvision.transforms.v2,应按项目锁定的 torchvision 版本改写整套 Transform,不要在同一数据集中混用两套调用风格。
from collections import defaultdict
from pathlib import Path
import hashlib

import torch
from PIL import Image
from torch.utils.data import DataLoader, Subset
from torchvision import datasets, transforms

ROOT = Path("data/raw")
SEED = 2026
BATCH_SIZE = 32
MIN_SIDE = 128
MIN_PER_CLASS = 100
IMAGE_EXTS = {".jpg", ".jpeg", ".png"}

class_dirs = sorted(p for p in ROOT.iterdir() if p.is_dir())
if len(class_dirs) != 5:
    raise ValueError(f"expected 5 classes, got {len(class_dirs)}")

hash_owner = {}
valid_count = 0
for class_dir in class_dirs:
    files = sorted(
        p for p in class_dir.rglob("*")
        if p.is_file() and p.suffix.lower() in IMAGE_EXTS
    )
    if len(files) < MIN_PER_CLASS:
        raise ValueError(f"{class_dir.name}: only {len(files)} images")

    for path in files:
        with Image.open(path) as image:
            width, height = image.size
            image.verify()
        if min(width, height) < MIN_SIDE:
            raise ValueError(f"image too small: {path}")

        digest = hashlib.sha256(path.read_bytes()).hexdigest()
        if digest in hash_owner:
            raise ValueError(f"duplicate: {path} == {hash_owner[digest]}")
        hash_owner[digest] = path
        valid_count += 1

base = datasets.ImageFolder(ROOT)
by_class = defaultdict(list)
for index, (_, class_id) in enumerate(base.samples):
    by_class[class_id].append(index)

generator = torch.Generator().manual_seed(SEED)
train_idx, val_idx, test_idx = [], [], []

for class_id in range(len(base.classes)):
    indices = by_class[class_id]
    order = torch.randperm(len(indices), generator=generator).tolist()
    shuffled = [indices[i] for i in order]

    n_train = int(len(shuffled) * 0.70)
    n_val = int(len(shuffled) * 0.15)
    train_idx.extend(shuffled[:n_train])
    val_idx.extend(shuffled[n_train:n_train + n_val])
    test_idx.extend(shuffled[n_train + n_val:])

assert set(train_idx).isdisjoint(val_idx)
assert set(train_idx).isdisjoint(test_idx)
assert set(val_idx).isdisjoint(test_idx)

normalize = transforms.Normalize(
    mean=[0.485, 0.456, 0.406],
    std=[0.229, 0.224, 0.225],
)

train_transform = transforms.Compose([
    transforms.RandomResizedCrop(224, scale=(0.8, 1.0)),
    transforms.RandomHorizontalFlip(p=0.5),
    transforms.ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2),
    transforms.ToTensor(),
    normalize,
])

eval_transform = transforms.Compose([
    transforms.Resize(256),
    transforms.CenterCrop(224),
    transforms.ToTensor(),
    normalize,
])

train_set = Subset(datasets.ImageFolder(ROOT, transform=train_transform), train_idx)
val_set = Subset(datasets.ImageFolder(ROOT, transform=eval_transform), val_idx)
test_set = Subset(datasets.ImageFolder(ROOT, transform=eval_transform), test_idx)

loader_args = {
    "batch_size": BATCH_SIZE,
    "num_workers": 0,
    "pin_memory": torch.cuda.is_available(),
}

train_loader = DataLoader(
    train_set,
    shuffle=True,
    generator=torch.Generator().manual_seed(SEED),
    **loader_args,
)
val_loader = DataLoader(val_set, shuffle=False, **loader_args)
test_loader = DataLoader(test_set, shuffle=False, **loader_args)

images, labels = next(iter(train_loader))

print(f"class_count={len(base.classes)}")
print(f"valid_images={valid_count}")
print(f"split train={len(train_set)} val={len(val_set)} test={len(test_set)}")
print(f"train_batch_images={tuple(images.shape)}")
print(f"train_batch_labels={tuple(labels.shape)}")
print(f"dtype={images.dtype}")
预期输出:
class_count=5
valid_images=<N>
split train=<TRAIN_N> val=<VAL_N> test=<TEST_N>
train_batch_images=(32, 3, 224, 224)
train_batch_labels=(32,)
dtype=torch.float32
其中 <N>、<TRAIN_N>、<VAL_N>、<TEST_N> 取决于实际每类图片数量;由于按类别分别取整,三个集合的总比例会接近 70%/15%/15%,但不要求用总样本数直接乘比例得到完全相同的整数。
检查增强与 DataLoader 参数
本例假设模型使用常见 ImageNet 预训练主干,因此采用 ImageNet mean/std。训练阶段使用 RandomResizedCrop(224, scale=(0.8, 1.0))、水平翻转概率 0.5 和 ColorJitter 强度 0.2;验证与测试只做 Resize(256) 加 CenterCrop(224),这样同一图片重复评估时输入不会随机变化。
batch_size=32 适合作为起始值。如果显存不足,先降到 16 或 8;如果 GPU 等待数据明显,可把 num_workers 从 0 逐步调到 4 或 8,并重新测一个 epoch 的耗时。Windows 或 Notebook 环境在多进程加载出现启动问题时,先用 num_workers=0 验证逻辑,再处理进程入口。
用失败条件保护训练入口
数据流水线应在训练开始前主动失败,而不是训练数小时后才暴露问题。本例已经对四类问题直接抛出异常:类别数不是 5、单类少于 100 张、短边小于 128、存在字节级重复文件;这类错误都应先修数据,再重新生成切分。
还要额外检查标签语义。ImageFolder 会按文件夹名字典序生成类别索引,因此训练前应记录 base.class_to_idx,并与交付使用的标签映射一起版本化。只要数据版本、随机种子、类别目录和切分算法不变,同一脚本就应产生相同的 train/val/test 索引,这才是后续训练比较有效的前提。