
机器学习与深度学习 / 系统课时
认识 nn.Module
认识 nn.Module
nn.Module 是 PyTorch 组织神经网络的基础抽象:它把可训练参数、子模块和前向计算收进同一个对象,并让这些内容能被统一遍历、保存和迁移设备。掌握注册规则与调用路径后,就能读懂绝大多数模型类。
学习目标
- 能用
nn.Module定义一个包含子模块的模型,并实现forward。 - 能区分参数、子模块与普通属性,并用
named_parameters()检查注册结果。 - 能解释
model(x)与forward的关系,以及为什么不应直接调用model.forward(x)。
模块怎样组织网络
自定义网络通常继承 nn.Module,在 __init__ 中把层保存为实例属性,在 forward 中描述一次前向计算。只要把另一个 nn.Module 赋给 self.hidden 这类属性,PyTorch 就会把它登记为子模块;子模块中的 nn.Parameter 会继续递归登记为当前模型的参数。
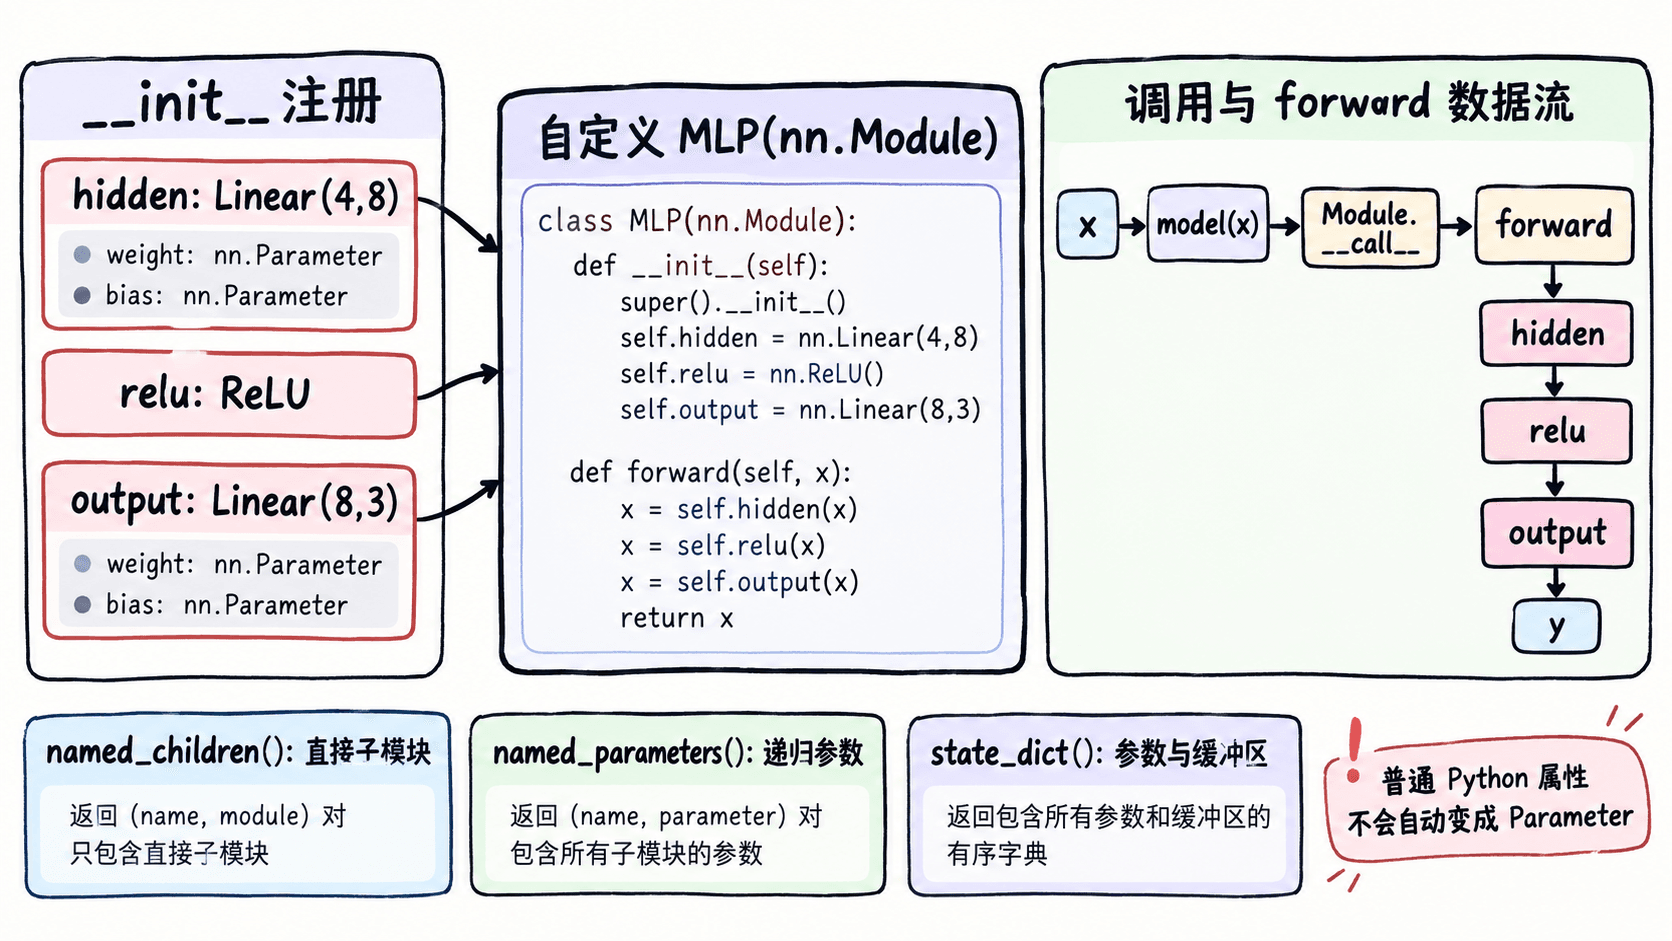
例如 self.hidden = nn.Linear(4, 8) 会同时注册名为 hidden 的子模块,以及它内部的 hidden.weight、hidden.bias。相反,self.scale = 0.5 只是普通 Python 属性,不会出现在 named_parameters() 中。
参数和子模块怎样被发现
检查模型结构时,优先使用框架提供的遍历接口,而不是自己维护参数列表。named_children() 只列出当前模块的直接子模块;named_modules() 会递归列出所有模块;named_parameters() 会递归列出参数;state_dict() 则返回参数和持久缓冲区,通常用于保存模型状态。
下面这个模型有两个 Linear 层,因此共有四个参数张量:两个 weight 和两个 bias。ReLU 没有可训练参数,所以只会出现在子模块列表中,不会出现在参数列表中。
定义并验证一个 Module
下面代码可直接运行。它同时验证子模块注册、参数注册和前向输出形状。
import torch
from torch import nn

class MLP(nn.Module):
    def __init__(self):
        super().__init__()
        self.hidden = nn.Linear(4, 8)
        self.relu = nn.ReLU()
        self.output = nn.Linear(8, 3)
        self.scale = 0.5  # 普通属性,不会被注册为参数

    def forward(self, x):
        x = self.hidden(x)
        x = self.relu(x)
        return self.output(x) * self.scale

model = MLP()
x = torch.ones(2, 4)
y = model(x)

print("output shape:", tuple(y.shape))
print("children:", [name for name, _ in model.named_children()])
for name, parameter in model.named_parameters():
    print(name, tuple(parameter.shape), parameter.requires_grad)
预期输出
output shape: (2, 3)
children: ['hidden', 'relu', 'output']
hidden.weight (8, 4) True
hidden.bias (8,) True
output.weight (3, 8) True
output.bias (3,) True
这里的关键检查是:输入批量大小为 2,最终输出形状是 (2, 3);scale 没出现在参数列表中;两个 Linear 层的参数都被递归发现。
调用 model(x) 而不是 forward
执行 model(x) 时,nn.Module 的调用逻辑会再进入你实现的 forward。这种方式还能正确触发模块注册的前向钩子等调用机制,因此业务代码应写 model(x),而不是绕过模块调用逻辑直接写 model.forward(x)。
如果某个张量需要参与优化,应让它成为子模块参数,或显式创建 nn.Parameter 并赋给模块属性。例如 self.temperature = nn.Parameter(torch.tensor(1.0)) 会出现在 named_parameters() 中;普通的 torch.tensor(1.0) 属性不会。模型保存、优化器取参和设备迁移都依赖这套注册机制。