
机器学习与深度学习 / 系统课时
自定义 Dataset
自定义 Dataset
把样本路径、标签读取和预处理散落在训练循环里,会让数据逻辑难以复用和测试。自定义 Dataset 可以把“索引如何对应到本地文件、怎样生成标签、何时做预处理”封装成统一接口,最终让训练代码只关心取样结果。
学习目标
- 实现
Dataset的__len__与__getitem__两个核心接口 - 把本地文件、标签和预处理逻辑封装到同一个数据集对象中
- 用直接索引验证返回张量的形状、类型和标签是否正确
Dataset 需要承担什么
地图式数据集通常继承 torch.utils.data.Dataset。__len__() 返回可索引样本数,__getitem__(idx) 根据整数索引读取一个样本并返回训练需要的数据结构,例如 (features, label)。
一个实用边界是:Dataset 负责“单个样本怎样得到”,而批量组合、打乱顺序和多进程加载交给 DataLoader。这样同一个数据集既能直接用 dataset[3] 调试,也能接入批训练。
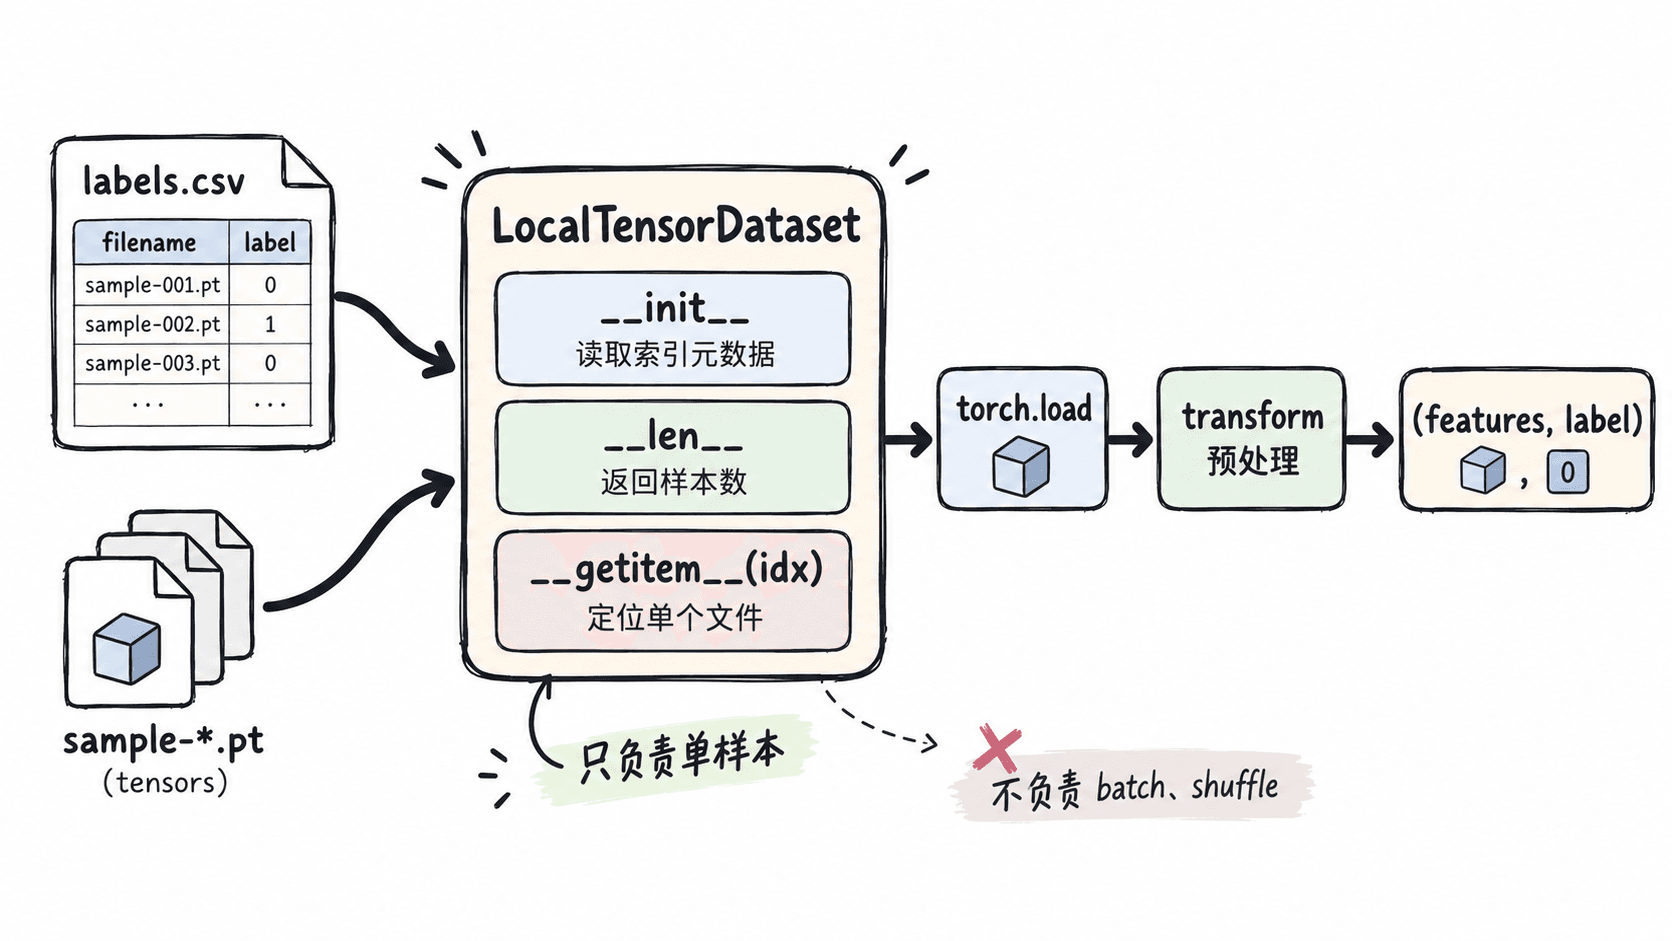
实现一个可运行的数据集
下面脚本先创建 3 个本地 .pt 样本和一份 labels.csv,再实现 LocalTensorDataset。示例只依赖 Python 标准库与 PyTorch,适合 PyTorch 2.x。
import csv
from pathlib import Path

import torch
from torch.utils.data import Dataset

ROOT = Path("demo_dataset")
ROOT.mkdir(exist_ok=True)

rows = [
    ("sample-0.pt", 0),
    ("sample-1.pt", 1),
    ("sample-2.pt", 0),
]

for i, (filename, _) in enumerate(rows):
    torch.save(torch.arange(4) + i, ROOT / filename)

with (ROOT / "labels.csv").open("w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["filename", "label"])
    writer.writerows(rows)

class LocalTensorDataset(Dataset):
    def __init__(self, root: Path, transform=None):
        self.root = root
        self.transform = transform
        with (root / "labels.csv").open(encoding="utf-8") as f:
            self.items = list(csv.DictReader(f))

    def __len__(self):
        return len(self.items)

    def __getitem__(self, idx):
        item = self.items[idx]
        features = torch.load(
            self.root / item["filename"], weights_only=True
        )
        label = int(item["label"])

        if self.transform is not None:
            features = self.transform(features)

        return features, label

dataset = LocalTensorDataset(
    ROOT,
    transform=lambda x: x.to(torch.float32) / 10,
)

x, y = dataset[1]
print("length:", len(dataset))
print("shape:", tuple(x.shape), "dtype:", x.dtype)
print("sample[1]:", [round(v, 1) for v in x.tolist()], "label:", y)
预期输出:
length: 3
shape: (4,) dtype: torch.float32
sample[1]: [0.1, 0.2, 0.3, 0.4] label: 1
这里把 CSV 元数据一次性读入内存,但张量文件在 __getitem__ 被调用时才加载。真实图片、音频或大型张量数据通常也采用这种“保存路径,按需读取”的方式,避免在 __init__ 中一次把全部样本装进内存。
预处理放在哪里
样本级预处理适合通过 transform 注入,而不是写死在训练循环。示例中的 lambda x: x.to(torch.float32) / 10 会对每次取出的张量做类型转换和缩放;换成图像任务时,可以传入由 torchvision transforms 组成的变换链。
需要注意可变性:训练集可以使用随机裁剪、随机翻转等随机增强,验证集应使用确定性预处理。通常创建两个 Dataset 实例,分别传不同的 transform,而不是在 __getitem__ 里根据全局状态判断“当前是不是验证阶段”。
先验证单样本再接 DataLoader
接入批处理前,至少检查 3 件事:len(dataset) 是否等于元数据行数;首尾索引能否读取;返回张量的 dtype、形状和标签范围是否符合模型输入。对于 10000 个样本的数据集,可以先抽查索引 0、4999、9999,比直接启动完整训练更容易定位坏路径或错标签。
如果 __getitem__ 抛出 FileNotFoundError,优先打印当前 idx 对应的文件名,并检查路径是否相对于数据根目录拼接;如果返回样本的形状不一致,后续默认批处理会在堆叠张量时失败,此时应先统一预处理输出尺寸,或再设计专用的 collate_fn。