
机器学习与深度学习 / 系统课时
配置并行数据加载
配置并行数据加载
当磁盘读取、图片解码或数据增强跟不上模型计算时,GPU 会周期性等待下一批数据。本课用 DataLoader 的多进程加载、预取和页锁定内存配置,把数据准备与训练计算重叠起来,并给出跨平台可运行的验证方法。
学习目标
- 会用
num_workers、prefetch_factor和persistent_workers配置并行加载。 - 能在 CUDA 训练时正确组合
pin_memory=True与non_blocking=True。 - 能根据吞吐量和报错现象调整 worker 数量,而不是盲目设大。
先确定 worker 与预取数量
num_workers=0 表示数据仍由训练主进程读取;设为大于 0 后,DataLoader 会启动子进程并行执行 Dataset.__getitem__ 与其中的解码、变换逻辑。实际训练可先从每张 GPU 配 2~4 个 worker 起步,再用每秒 batch 数确认是否继续增加。
prefetch_factor 表示每个 worker 预先准备的 batch 数。num_workers=4、prefetch_factor=2 时,最多会有约 8 个 batch 处于预取队列中,因此它能隐藏 I/O 延迟,也会增加主机内存和共享内存压力。persistent_workers=True 适合多 epoch 训练,可避免每轮结束后反复销毁和重建 worker;它只应在 num_workers>0 时使用。
| 参数 | 起步值 | 什么时候调整 |
|---|---|---|
num_workers |
2 或 4 |
GPU 经常等数据时逐步增加;内存紧张或 worker 崩溃时减少 |
prefetch_factor |
2 |
单个 batch 很大、/dev/shm 紧张时降到 1 |
persistent_workers |
True |
多个 epoch 且 worker 启动成本明显时开启 |
pin_memory |
CUDA 训练时 True |
纯 CPU 训练通常没有必要 |
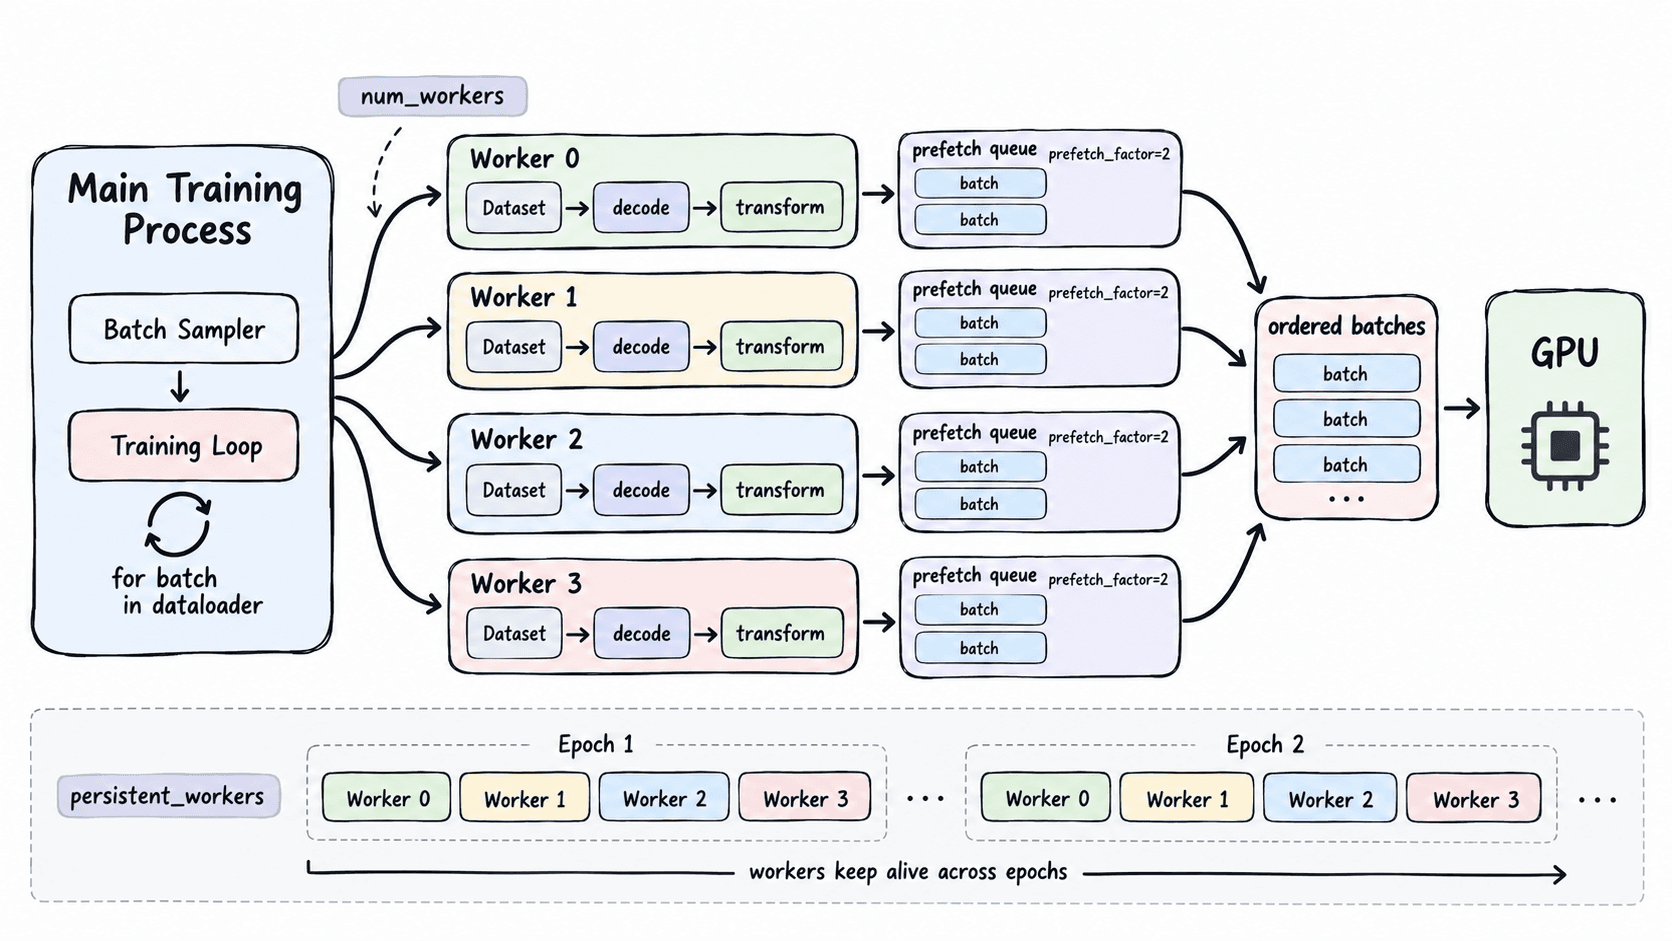
写出可跨平台运行的 DataLoader
下面的程序显式记录每个样本由哪个 worker 读取。类定义放在模块顶层,并用 if __name__ == "__main__": 保护入口,这一点对 Windows 和使用 spawn 的环境尤其重要。
from torch.utils.data import DataLoader, Dataset, get_worker_info

class DemoDataset(Dataset):
    def __len__(self):
        return 8

    def __getitem__(self, index):
        info = get_worker_info()
        worker_id = -1 if info is None else info.id
        return {"index": index, "worker_id": worker_id}

def main():
    loader = DataLoader(
        DemoDataset(),
        batch_size=2,
        shuffle=False,
        num_workers=2,
        prefetch_factor=2,
        persistent_workers=True,
    )

    seen = 0
    worker_ids = set()
    for batch in loader:
        seen += len(batch["index"])
        worker_ids.update(batch["worker_id"].tolist())

    print("samples:", seen)
    print("worker_ids:", sorted(worker_ids))

if __name__ == "__main__":
    main()
预期输出:
samples: 8
worker_ids: [0, 1]
若把 num_workers 改为 0,必须同时移除 prefetch_factor 和 persistent_workers=True 这类只针对多进程 worker 的设置;此时 get_worker_info() 返回 None,示例中的 worker ID 会变为 -1。
把批次送到 GPU 时配合页锁定内存
CUDA 训练可在 DataLoader 中设置 pin_memory=True,再将 batch 迁移写成 batch.to(device, non_blocking=True)。常见配置是 pin_memory=torch.cuda.is_available():有 CUDA 时启用,CPU 环境保持关闭,避免为了一个没有主机到 GPU 传输的场景增加额外工作。
页锁定内存只优化 CPU 到 CUDA 设备的数据搬运,不能解决 JPEG 解码慢、网络文件系统延迟高或数据增强过重的问题。若 GPU 利用率低,应先分别计时“取下一批数据”和“前向/反向计算”,确认瓶颈究竟在输入流水线还是模型计算。
按症状缩小并行加载问题
num_workers 不是越大越好。最实用的调参方法是固定 batch_size,依次测试 0、2、4、8 个 worker,各跑几十到上百个 batch,记录稳定阶段的 batch/s;吞吐量不再上升就停止增加。
遇到 DataLoader worker ... exited unexpectedly 时,先改成 num_workers=0 重新运行,因为异常会直接在主进程抛出,通常更容易看到真实栈信息。Linux 容器出现 Unexpected bus error 时,优先检查共享内存是否过小,并先把 prefetch_factor 从 2 降到 1、worker 数减半或减小 batch_size。如果数据集对象中包含无法序列化的局部函数、lambda 或打开的连接,也应把初始化逻辑移到 worker 可安全执行的位置。
当 num_workers=0 已经能持续供给模型时,并行化反而可能因为进程通信更慢;只有测到数据等待确实存在,再增加 worker,才能把 CPU、内存与共享内存成本换成真正的训练吞吐量。