
机器学习与深度学习 / 系统课时
执行反向传播
执行反向传播
训练模型时,前向计算只得到预测值和损失;真正让参数获得更新依据的是反向传播。本课用一个可运行的线性算例调用 backward(),检查损失如何沿计算图反向传递,并说明为什么同一张计算图通常只能反向一次。
学习目标
- 使用
loss.backward()计算叶子参数的梯度 - 根据简单算例手算并核对
w.grad与b.grad - 理解计算图释放、
retain_graph与梯度累积的边界
从损失反推参数梯度
设输入 x=[2,-1],参数 w=[0.5,-0.25]、b=0.1,预测为 x @ w + b=1.35。目标值取 1.5,平方损失为 0.0225。对预测值求导得到 -0.3,再乘各输入分量,因此 w 的梯度应为 [-0.6,0.3],b 的梯度应为 -0.3。
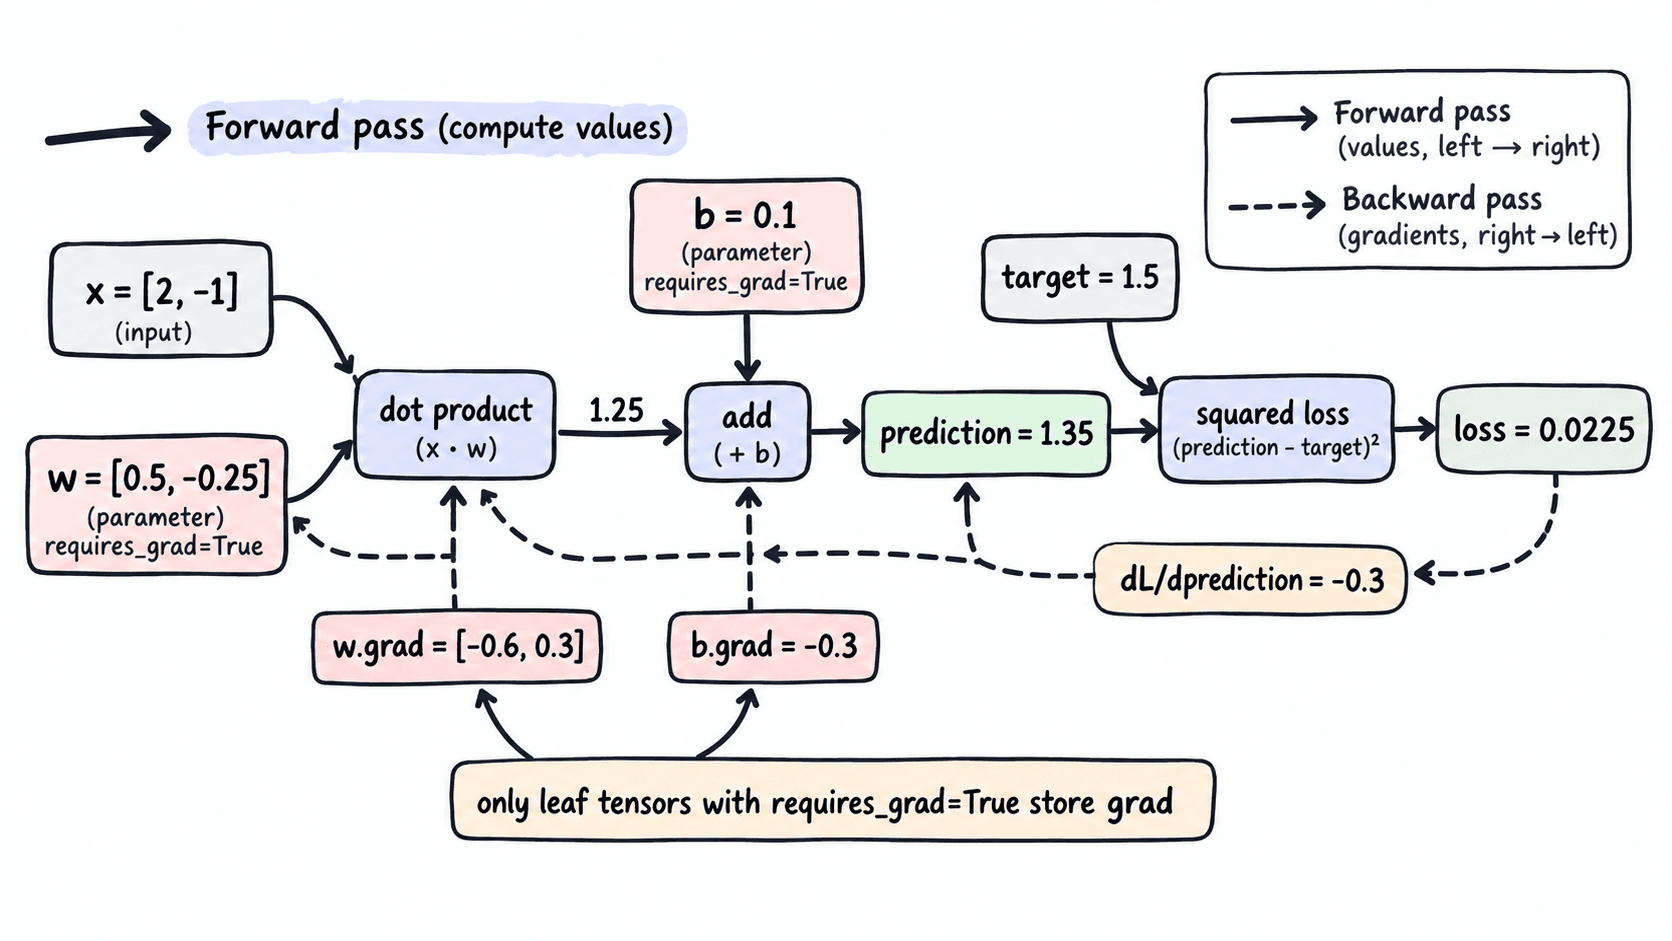
下面的代码直接复现这组数字。requires_grad=True 让 w 和 b 参与自动求导;loss.backward() 会从标量损失开始执行反向模式自动微分,并把结果写入叶子张量的 .grad。
import torch

x = torch.tensor([2.0, -1.0])
w = torch.tensor([0.5, -0.25], requires_grad=True)
b = torch.tensor(0.1, requires_grad=True)
target = torch.tensor(1.5)

prediction = x @ w + b
loss = (prediction - target) ** 2
loss.backward()

print(f"prediction={prediction.item():.2f}")
print(f"loss={loss.item():.4f}")
print("w.grad=", [round(v, 2) for v in w.grad.tolist()])
print(f"b.grad={b.grad.item():.2f}")
预期输出
prediction=1.35
loss=0.0225
w.grad= [-0.6, 0.3]
b.grad=-0.30
backward() 实际做了什么
PyTorch 在前向计算时动态记录运算关系。调用 backward() 后,它从 loss 出发按链式法则反向遍历图,将各路径贡献相加,并最终写入叶子参数的 .grad。这个例子中,x 没有开启 requires_grad,所以不会保存 x.grad。
如果最终张量不是标量,不能直接省略上游梯度。例如 y = w * x 得到两个元素时,要么先用 y.sum().backward() 化成标量,要么显式传入与 y 同形状的梯度参数。模型训练中的损失函数通常已经返回标量,因此最常见写法仍是 loss.backward()。
为什么同一张图不能随意反向两次
默认情况下,backward() 完成后会释放为反向计算保存的中间结果,以减少显存或内存占用。因此,对同一个 loss 连续调用两次 backward() 通常会触发包含 Trying to backward through the graph a second time 的运行时错误。
确实需要重复使用同一张图时,可以第一次调用 loss.backward(retain_graph=True)。但普通训练循环不应依赖它:更常见也更省内存的做法,是下一轮重新执行前向计算,得到新的 loss 和新的计算图。
放进训练循环时的位置
一次典型训练迭代按四步执行:optimizer.zero_grad(set_to_none=True) 清理旧梯度;prediction = model(inputs) 与损失函数完成前向计算;loss.backward() 计算当前批次梯度;最后 optimizer.step() 更新参数。
检查顺序时只要抓住两个位置:backward() 必须在损失计算之后,step() 必须在 backward() 之后。若先 step() 再反向,优化器没有本轮梯度可用;若下一轮不先清理 .grad,新梯度会继续叠加到旧梯度上。