
机器学习与深度学习 / 系统课时
切换训练与评估模式
切换训练与评估模式
同一个 PyTorch 模型在训练和验证阶段可能表现不同,关键原因是 Dropout、BatchNorm 等层会读取模块的 training 状态。本篇给出正确的切换方式、可运行验证,以及 eval() 与关闭梯度之间的边界。
学习目标
- 能用
model.train()与model.eval()正确切换模型模式。 - 能解释 Dropout 和 BatchNorm 在两种模式下的行为差异。
- 能在验证结束后恢复训练模式,并避免把
eval()当成“关闭梯度”。
模式切换会递归影响子模块
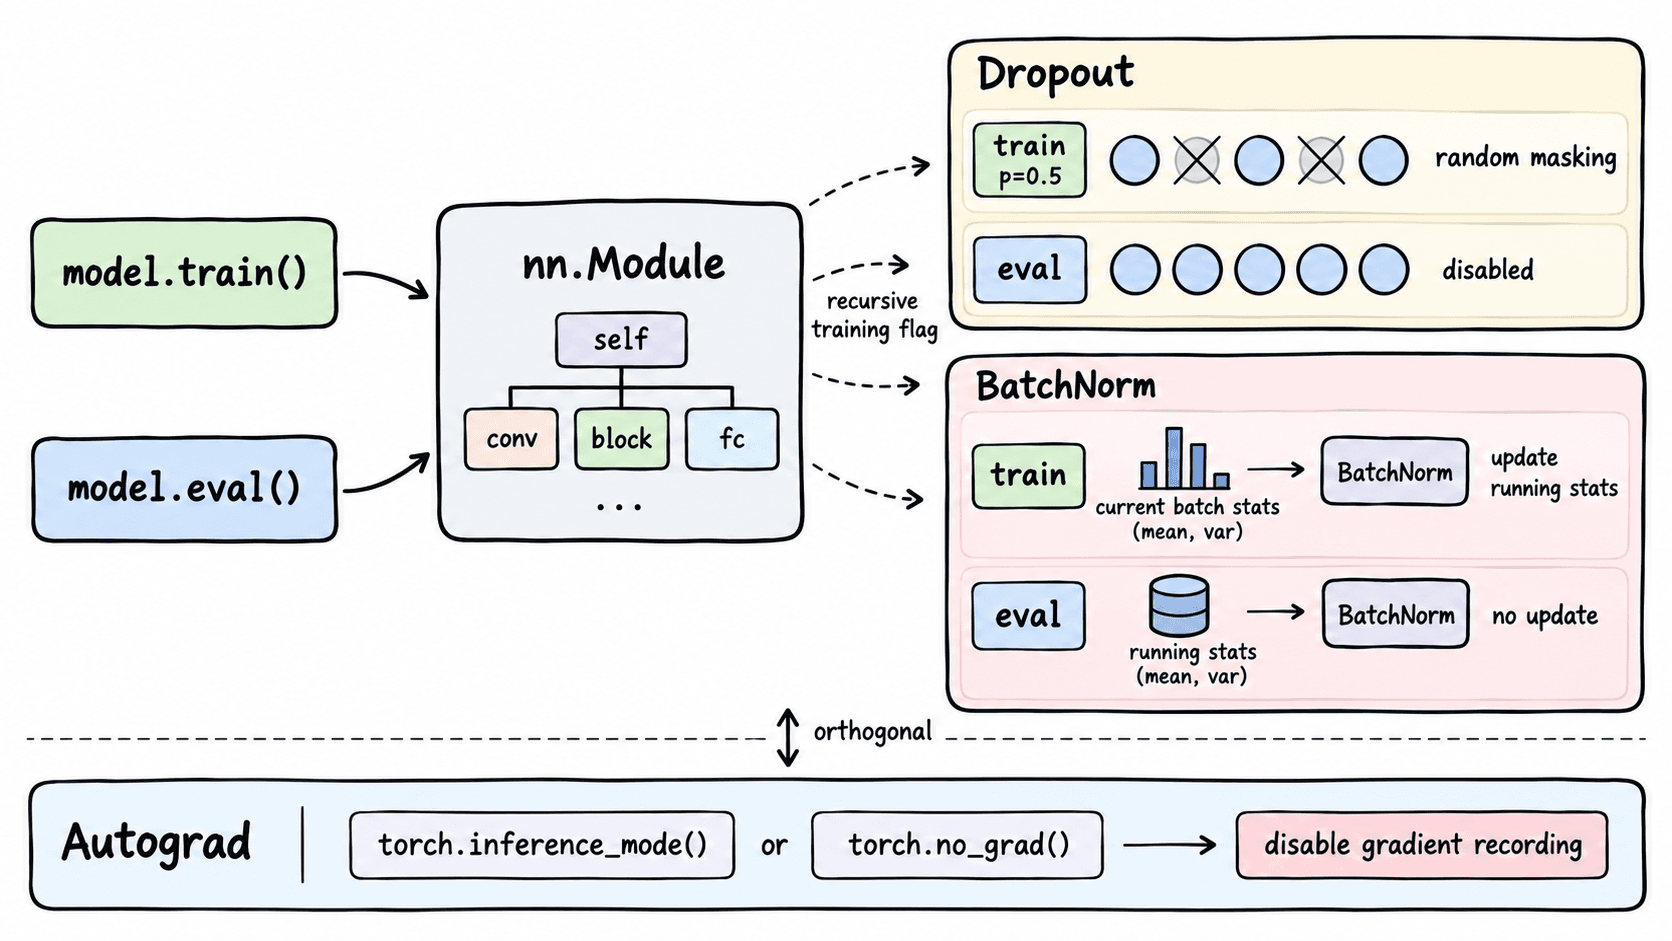
nn.Module 新建后默认处于训练模式,model.training 为 True。调用 model.eval() 等价于 model.train(False),会递归把所有子模块的 training 设为 False;再次调用 model.train() 会递归恢复为 True。
对常见层而言,差异最明显的是:
| 层 | 训练模式 | 评估模式 |
|---|---|---|
nn.Dropout(p=0.5) |
按概率随机置零,并对保留值缩放 | 不再随机丢弃,近似恒等映射 |
nn.BatchNorm1d |
使用当前批次统计量,并更新 running mean/variance | 使用已累计的 running mean/variance,不更新它们 |
nn.Linear、nn.ReLU |
计算规则不因模式变化 | 计算规则不因模式变化 |
用可运行代码检查状态
下面的脚本不依赖训练数据,直接检查模型本身和关键子层的 training 状态,并在评估模式下完成一次前向计算。
import torch
from torch import nn

model = nn.Sequential(
    nn.Linear(4, 4),
    nn.BatchNorm1d(4),
    nn.ReLU(),
    nn.Dropout(p=0.5),
    nn.Linear(4, 2),
)

print("initial:", model.training, model[1].training, model[3].training)

model.eval()
print("eval:", model.training, model[1].training, model[3].training)

with torch.inference_mode():
    x = torch.ones(2, 4)
    y = model(x)
    print("output shape:", tuple(y.shape))

model.train()
print("train:", model.training, model[1].training, model[3].training)
预期输出:
initial: True True True
eval: False False False
output shape: (2, 2)
train: True True True
这里 model[1] 是 BatchNorm1d,model[3] 是 Dropout。三个布尔值同步变化,说明模式切换会递归传递到子模块,而不是只修改最外层模型。
eval 不等于关闭梯度
model.eval() 只改变依赖训练状态的层;它不会禁用 Autograd,也不会清空已有梯度。验证或纯推理通常同时使用 model.eval() 与 torch.inference_mode()。
典型验证顺序可以固定为:
- 调用
model.eval(),让 Dropout 和 BatchNorm 进入评估行为。 - 在
with torch.inference_mode():中执行验证前向计算,避免构建反向传播所需的计算图。 - 验证结束后,如果下一阶段还要继续训练,立即调用
model.train()。
如果验证阶段需要计算输入梯度,例如对抗样本或梯度可视化,只调用 model.eval(),不要包 torch.inference_mode();否则梯度记录会被关闭。
最容易出现的模式泄漏
真实训练循环里常见的问题不是 API 写错,而是“切过去没有切回来”。例如每个 epoch 先训练再验证时,下一轮训练前应显式执行 model.train(),不要依赖前一轮状态。
另一个检查点是 BatchNorm:如果忘记 eval(),验证结果会依赖当前验证批次的均值和方差,而且 running statistics 还会被验证数据继续更新。小批次尤其容易让指标抖动。对含 Dropout 或 BatchNorm 的模型,保存权重后做最终评估时也应先 model.eval();加载 state_dict 本身不会自动切到评估模式。